
价格监控系统不是刷新价格的仪表盘,而是一条四层管线:采集、存储、检测、行动。数据层决定下游一切;实时数据层加追加式时间线,才使系统可信。
本文先对照两种架构:批量缓存与实时按需;再分层拆解采集、存储、检测、行动四层;随后给出每次快照的数据模型与三档规模的成本模型。
两种架构:批量缓存 vs 实时按需
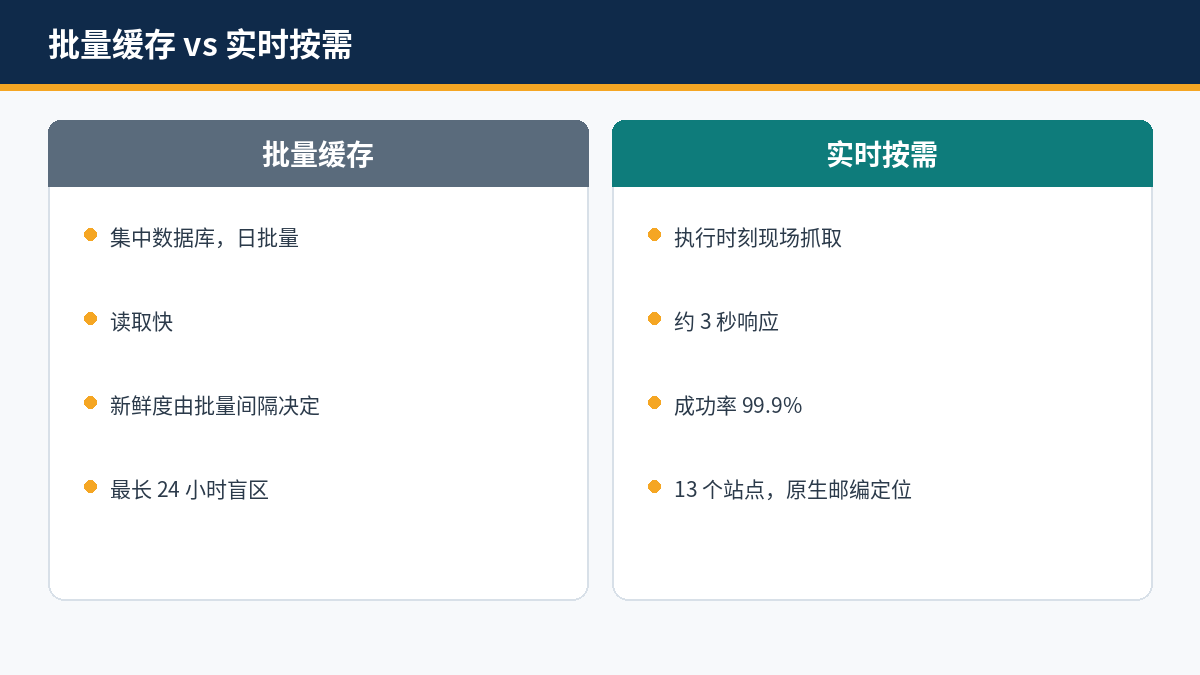
两种架构的分野不在界面,而在数据层:批量缓存架构读的是集中数据库中上一次批量入库的旧数据,实时按需架构在执行时刻现场抓取;前者能保证的只是读取速度,后者能保证的是新鲜度、可比性与可归因性。
批量缓存架构
批量缓存架构以集中数据库为中心:定时批量任务抓取数据并入库,读取时直接返回库中结果。两次批量之间,数据库内容不变,价格已变而读数未变;读取延迟低,但数据新鲜度由批量间隔决定,无法回答某一时刻的真实价格。
实时按需架构
实时按需架构在执行时刻现场抓取:每次查询直达亚马逊页面,按需返回结构化数据。接口平均响应约3秒,成功率99.9%,覆盖13个站点并支持原生邮编定位;每次结果都是当时当地的真实读数,读取速度与新鲜度不再互相牺牲。
各能保证什么,不能保证什么
批量缓存能保证读取速度与查询成本稳定,不能保证新鲜度、可比性与归因:批量时刻与查询时刻不同,同一邮编的连续读数可能来自不同批量条件。实时按需能保证新鲜度、可比性与归因,不能保证零成本:每次查询都发生真实采集,按结果计费。
批量缓存并非一无是处:查询量小、价格变化缓慢、且无需解释变化原因时,读取缓存已足够。批量缓存的适用边界在于问题本身:当问题从”当前价格是多少”变为”价格为何变化”,缓存读数即失去回答能力。
实时按需的代价是每次查询都发生真实采集:查询量越大,采集量越大;但计费只针对成功返回的结果,失败的查询不计费。这一代价换来的是可比性:每一次读数都来自同一类执行条件,时间线上的前后快照才可互相比较。
为什么数据层决定一切
检测层只能比较存储层给它的数据,行动层只能执行检测层给出的结论;数据层若以陈旧或不可比的读数为输入,下游再精密也只能输出陈旧或错误的结论。架构选型首先是数据层选型:新鲜度、可比性与归因能力在采集时刻即已确定,其后各层无法补救。
四层详解:采集 / 存储 / 检测 / 行动
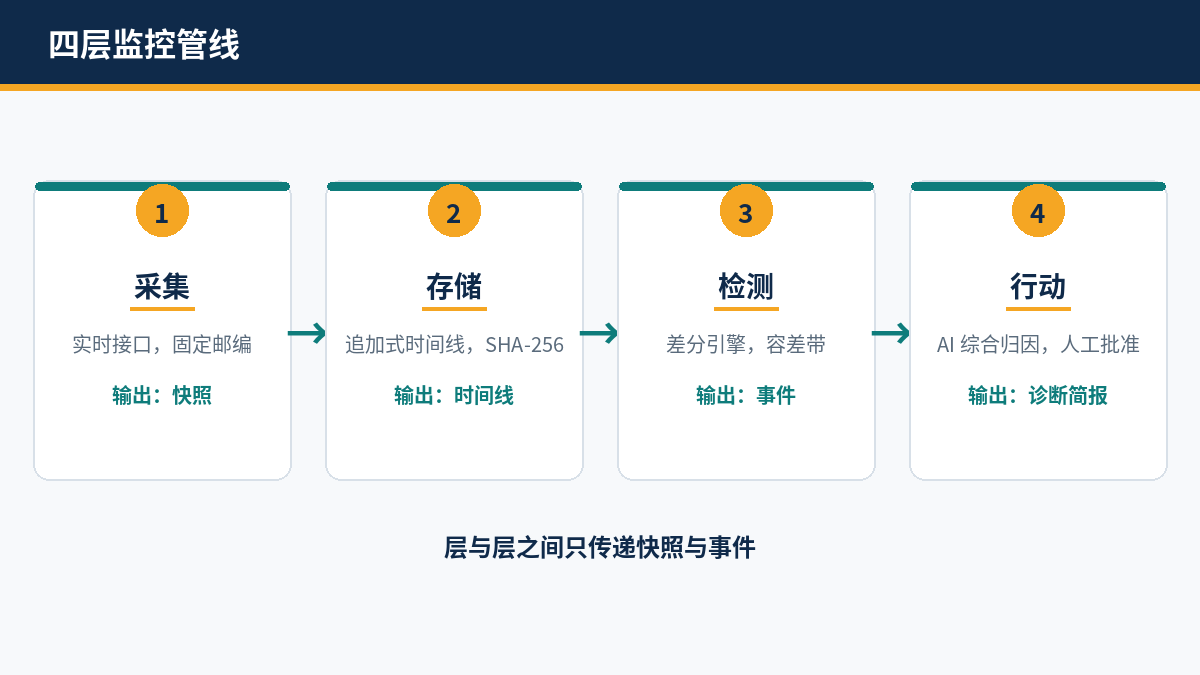
四层各有单一职责:采集层负责真实读数,存储层负责不可篡改的历史,检测层负责筛选异常,行动层负责把结论送达决策;层与层之间只以快照与事件传递数据,职责混杂即是系统不可信的开端。
层与层之间只传递两类数据:快照与事件。采集层只输出快照,存储层只保存快照,检测层只读取快照并输出事件,行动层只消费事件。契约固定后,任一层都可独立替换:更换采集接口不影响存储格式,更换检测规则不影响已存历史。
第一层:采集
采集层通过实时接口按需抓取:Amazon Scraper API返回结构化搜索结果页与商品页数据,执行时固定站点与邮编,赞助位捕获率90%以上。数据采集方式详见Scraper API 文档。
高频或批量查询宜用异步模式:提交任务时传入回调地址 callbackUrl,服务端完成抓取后将结果推送至回调地址,调用方无需阻塞等待。异步采集的接口与回调约定见异步 API 文档。
第二层:存储
存储层以追加式时间线保存快照:每次采集结果以不可变快照写入,旧记录不被覆盖。快照包含时间戳、站点、邮编与全部商业字段,并以 SHA-256 哈希标识内容版本;哈希不同即内容不同,哈希相同即无变化。数据模型见后文”每次快照的数据模型”一节。
存储层独立于检测层:检测规则可以改写与重跑,历史快照不受影响;同一时间线可先后以不同容差重算,得到不同的告警集合,而原始数据始终如一。存储与检测分离,归因结论才可复算、复核。
第三层:检测
检测层以差分引擎逐条比较新快照与前一快照:哈希不同先确认变化,再以容差带判断变化是否值得告警。容差按关键词分组设定,窄带词收紧、宽带词放宽;单次越线只记入时间线,连续越线或伴随 Buy Box 赢家变更、净价变动时升级告警。
第四层:行动
行动层由 AI 智能体综合归因:异常事件连同前后快照、竞品动态与搜索结果页布局一并分析,区分竞品优惠券、缺货与赞助份额变化等成因。智能体经 Amazon Data MCP 直接调用结构化工具,21 个工具的用法见MCP 工具文档;诊断简报经 Webhook 直达 Slack、Microsoft Teams 或 Lark,附人工批准按钮,高影响动作须经人工批准方可执行。完整落地方案见亚马逊排名及价格监控解决方案。
行动层不自动执行高影响动作:调价与申诉只提供建议与证据,执行须经人工批准。自动执行的范围限于低风险防御动作;批准记录本身亦存入时间线,使每一次干预都可回溯至触发它的事件与快照。
每次快照的数据模型
快照是时间线的最小解释单元:一次快照必须同时存下价格数字与产生该数字的全部条件,并且全部字段须来自同一次采集;缺失任一条件,事后归因即无从验证。
快照字段清单
一条快照至少包含:时间戳、站点、邮编、关键词、净价与优惠券、库存与配送承诺、Buy Box 赢家、搜索结果页排名与赞助位分布、评分与评论数、所属 BSR 与子品类节点排名。各字段同属一次采集,不可分批拼接;字段含义在监控启动前固定,避免中途变更口径。
返回格式与计费
同一快照可按三种格式返回,计费不同:结构化 JSON 每页 1 credit,HTML 或 Markdown 每页 0.75 credits,评论每页 5 credits。格式选择影响存储与解析成本,不影响快照包含的商业字段;按成功结果计费时,只对成功返回的结果计费。
评论数据按页计费,每页 5 credits;评论快照与价格快照分开存储,但以同一时间戳与 ASIN 关联。评价数量与评分的突变常伴随价格与排名变化,评论时间线是价格归因的辅助证据,而非替代。
为什么字段必须同属一次采集
分批拼接的字段来自不同时刻,价格、优惠券与配送承诺可能已各自变化,拼成的一条记录并不对应任何真实时刻。归因需要的是某一时刻的完整切面,而非各字段在不同时刻的最大值或最新值;切面完整,变化才可解释。
快照保留期限与监控目标一致:短期复盘需要近期快照,长期趋势分析需要跨季度快照。删除旧快照前,确认其解释价值已被归因结论承接;归因结论须引用快照编号,使结论可回溯至原始数据。
三档规模的成本模型
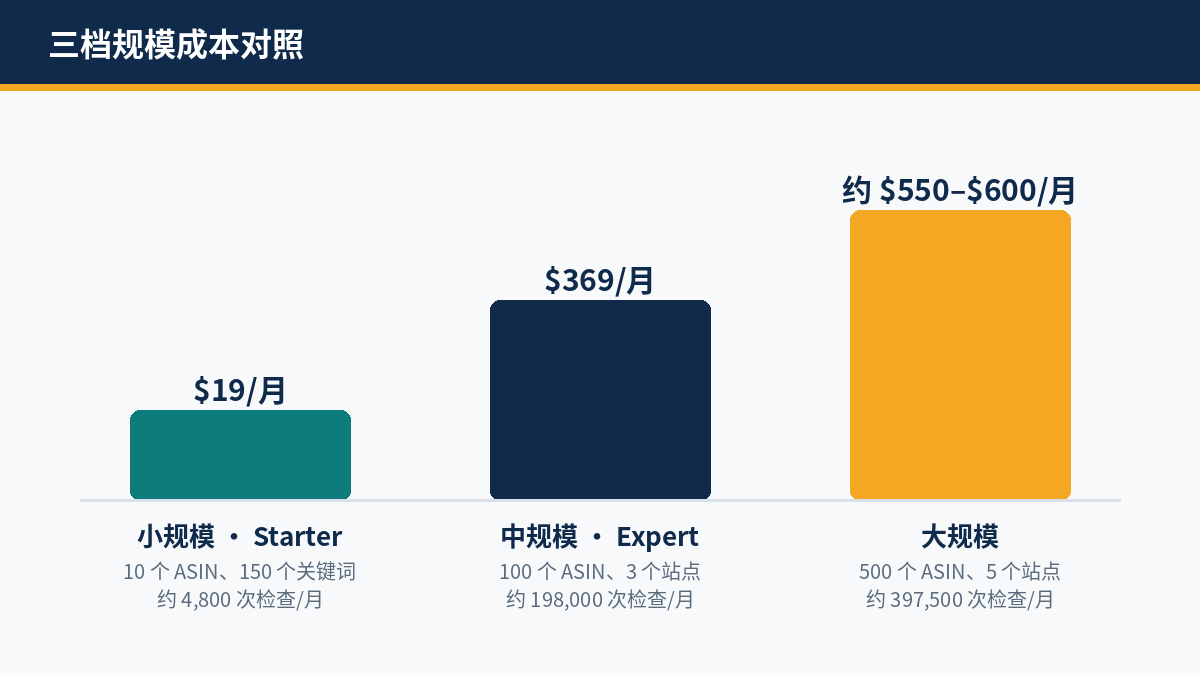
成本模型按规模分三档:小规模时按成功结果计费远低于订阅制,中规模时套餐内额度决定成本,大规模时成本与高端订阅制趋同,优势转向实时数据、数据所有权与灵活性;选型须按规模计算,而非按标价比较。
测算成本先定义监控单元与采集频率,再折算为每月检查量:监控单元包括 ASIN、关键词、站点与邮编的组合,检查量随单元数与频率增长;以检查量对照套餐额度,即可确定所需套餐与超额区间。
套餐与计费规则
计费以 credit 为单位,按成功结果计费:免费套餐 $0,含 60 credits;Starter $19/月,含 9,600 credits;Professional $99/月,含 60,000 credits;Expert $369/月,含 240,000 credits;年付优惠 20%。套餐额度与订阅规则见计费与订阅规则。
小规模
小规模监控 10 个 ASIN、150 个关键词,每日采集一次,每月约 4,800 次检查,Starter 套餐 $19/月即可覆盖。作为对照,Helium 10 Platinum 订阅为 $99–$129/月(2026 年 11 月研究数据),按成功结果计费的小规模成本远低于该订阅。
中规模
中规模监控 100 个 ASIN、覆盖 3 个站点,每月约 198,000 次检查,Expert 套餐 $369/月覆盖该量级。规模扩大后,成本由套餐内额度决定:检查量进入套餐额度上限之前,成本不随检查量线性增长。
大规模
大规模监控 500 个 ASIN、覆盖 5 个站点,采用自适应采集,每月约 397,500 次检查,Expert 套餐加分级超额约 $550–$600/月。该量级的成本与高端订阅制定价趋同,优势转向实时数据、数据所有权与灵活性,而非绝对价格。
年付优惠 20%,测算时以月度检查量为基准:检查量峰值月份可能触发超额,超额按分级计费;年付改变单价,不改变量级归属。
小规模便宜的原因在于计费单位:按成功结果计费时,每月 4,800 次检查只消耗少量 credits;订阅制按月收费,与使用量无关,小规模使用量撑不起订阅价。两种计费的交叉点在量级,不在功能。
常见问题
以下问答覆盖搭建价格监控系统时最常被问及的五个判定问题,答案均可直接作为操作依据。
Q1:批量缓存架构与实时按需架构如何选择?
看问题是否需要解释变化:只需当前价格,批量缓存已足够;需要新鲜度、可比性与归因时,须用实时按需架构。
Q2:异步采集如何工作?
提交任务时传入回调地址 callbackUrl,服务端完成抓取后将结果推送至回调地址,调用方无需阻塞等待。
Q3:一次快照必须存哪些字段?
至少包含时间戳、站点、邮编、关键词、净价与优惠券、库存与配送承诺、Buy Box 赢家、搜索结果页排名与赞助位分布、评分与评论数、BSR 与子品类节点排名。
Q4:小规模监控每月成本是多少?
10 个 ASIN、150 个关键词、每日采集一次,每月约 4,800 次检查,Starter 套餐 $19/月即可覆盖;免费套餐 $0,每月 60 credits,可先小规模起步。
Q5:系统如何避免误报?
检测层以容差带判断变化:单次越线只记入时间线,连续越线或伴随 Buy Box 赢家变更、净价变动时才升级告警;容差按关键词分组设定。
按上述架构搭建监控后,价格变化均可回溯至快照与成因;需要完整落地方案时,可参考亚马逊排名及价格监控解决方案,以实时数据与 AI 智能体承载四层管线。