
监控亚马逊关键词排名不是查一个排名数字,而是建立一条可比的时间线:同一站点、同一邮编、同一条件下的重复测量,使每一次变化都可解释。
本文先区分三种常被混用的排名,再给出六步搭建方法:界定监控范围、自适应采集频率、追加式时间线存储、变化检测、AI智能体归因与工作区交付;随后说明快照数据模型与告警阈值设定。
先分清三种”排名”,再谈监控
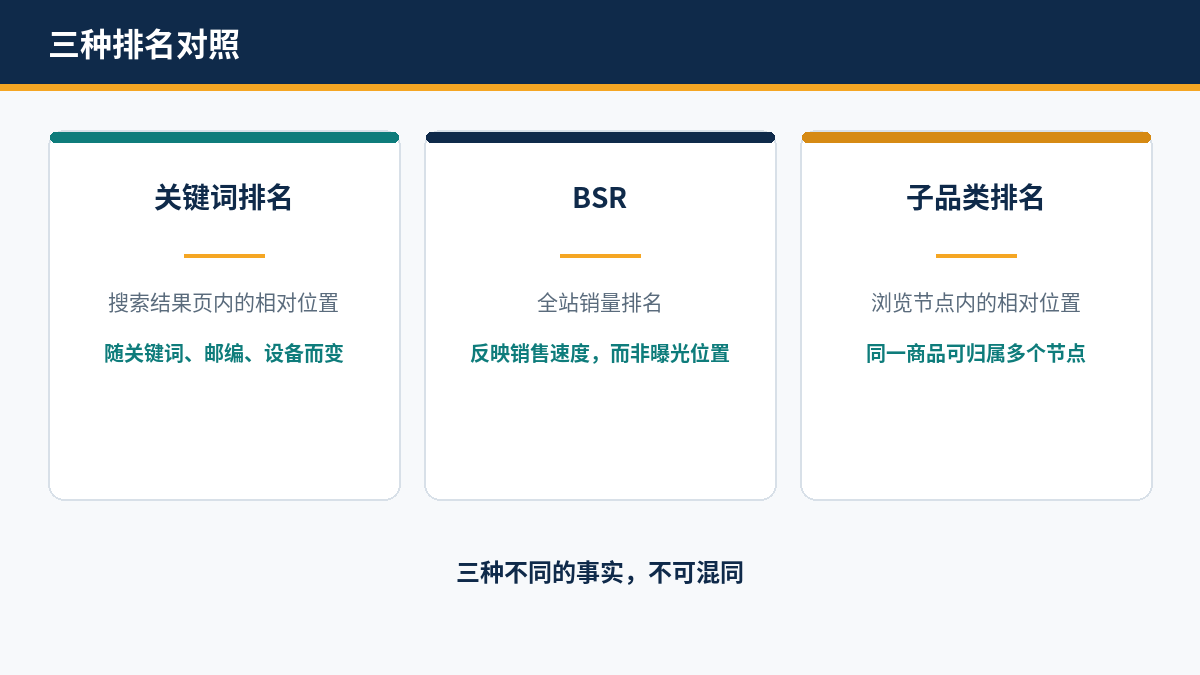
三种排名度量不同对象,混用则监控结论失真:关键词自然排名度量搜索可见性,BSR度量品类销量速度,子品类浏览节点排名度量细分节点内的相对销量速度。
关键词自然排名
关键词自然排名指商品在某一搜索词结果页中的自然位置,由相关性与转化速度决定。它是本文监控的核心对象,也是唯一直接反映搜索可见性的指标。同一关键词在不同邮编下结果不同,比较时必须固定邮编。
BSR
BSR即畅销排名,度量商品在所属大类中的销量速度相对位置。大类覆盖商品范围广,BSR变化反映整体销量趋势,不反映某一关键词的搜索位置。BSR上升时,关键词排名可能同步上升、持平或下降,两者不可互相替代。
子品类浏览节点排名
子品类浏览节点排名度量商品在某一细分浏览节点内的相对销量速度,例如某一手动工具细分节点。节点越细分,排名对销量变化越敏感;同一商品在不同节点中的排名不同,记录时必须注明节点路径。
赞助位与移动端首屏
赞助商品与赞助品牌占据搜索结果页顶部位置,自然结果随之下移,移动端首屏常被广告占满。只记录自然排名而不记录赞助位分布,会高估可见性:排名未变时,曝光可能已因广告份额扩大而下降。
混用三种排名的后果是归因错误:以BSR改善断定关键词可见性提升,或以子品类排名下滑断定搜索流量丢失,均缺乏依据。监控方案须在每条记录中标明排名类型、关键词、站点与邮编,使同类指标只与同类指标比较。
六步搭建排名监控
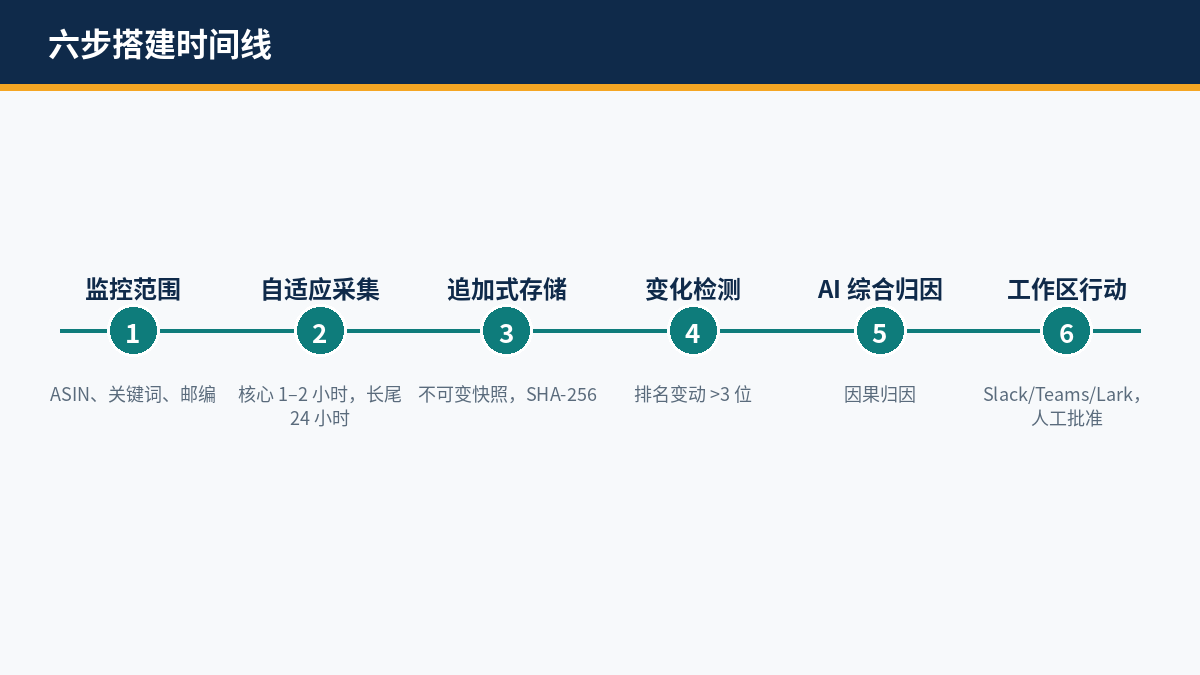
六步流程构成一条完整监控链:界定范围决定测什么,自适应频率决定多久测一次,追加式存储保留全部历史,变化检测筛选异常,AI智能体解释原因,工作区交付推动行动;任一环节缺失,监控即退化为孤立数字。
第一步:界定监控范围
监控范围以父子ASIN结构为骨架:父ASIN统合变体,子ASIN各有价格、库存、优惠券与Buy Box状态。关键词按意图成组,核心成交词与长尾词分开管理;竞品ASIN一并纳入,作为解释本方排名变化的参照。每个监控单元固定站点与邮编,例如以90001覆盖西海岸、60601覆盖中西部、10001覆盖东海岸城市需求。
第二步:自适应采集频率
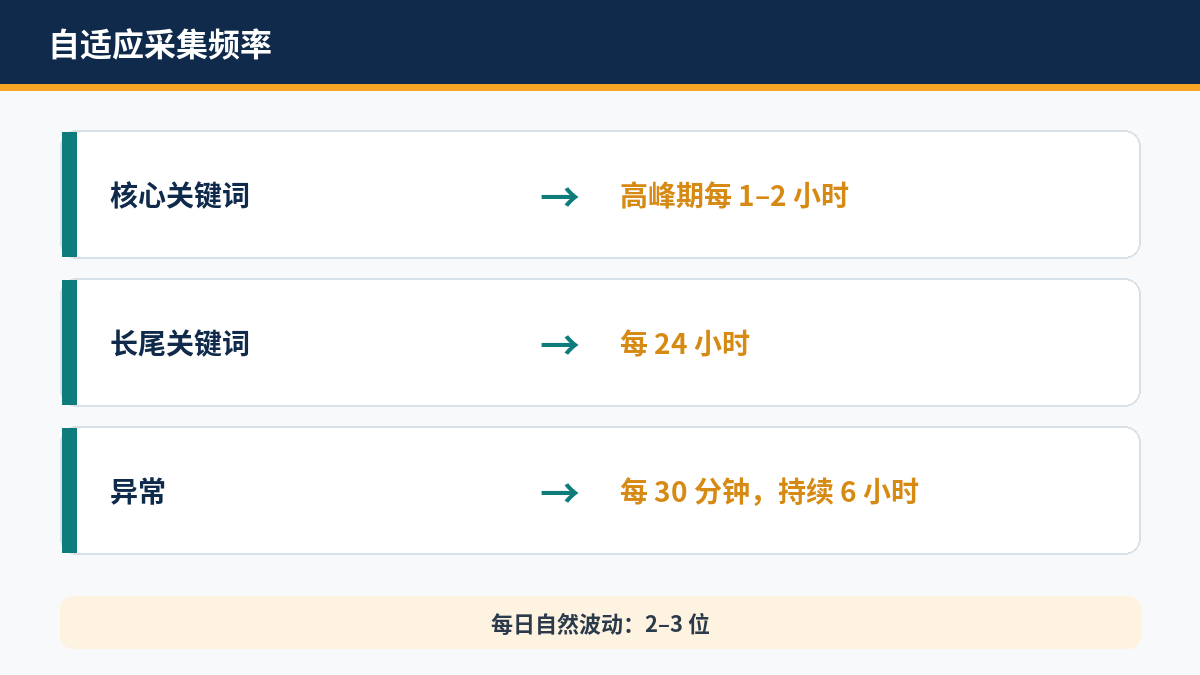
采集频率按关键词价值分层:核心成交词与Buy Box报价在高峰时段每1–2小时采集一次,长尾查询与子品类浏览节点每24小时采集一次。检测到异常后,调度器自动加速至每30分钟一次并持续6小时,以捕捉变化过程而非仅记录结果。
高频采集覆盖全部关键词会浪费采集量:核心词值得高频,长尾词低频已足够。自适应频率的意义在于把采集量投向变化最快、价值最高的位置,而非均匀摊薄;异常升级机制则保证突发变化不会被低频节奏漏掉。
第三步:追加式时间线存储
每次采集结果以不可变快照追加写入时间线数据库,旧记录不被覆盖。快照包含时间戳、站点、邮编、净价、优惠券、Buy Box赢家、配送承诺与完整搜索结果页排名;同一ASIN在不同邮编下的快照分开存储。数据模型见后文”每次快照必须存什么”一节。
第四步:变化检测
差分引擎逐条比较新快照与前一快照,超过容差即标记异常。触发条件包括自然排名移动超过3位、Buy Box赢家变更、计入优惠券后的净价变动,以及竞品赞助位在搜索结果页顶部的显著变化。未超容差的波动只记入时间线,不触发告警。
第五步:AI智能体综合归因
异常事件连同前后快照、竞品动态与搜索结果页布局一并交由AI智能体分析。智能体区分不同成因:竞品优惠券推动的销量增速、缺货导致的配送承诺恶化、赞助份额变化挤压自然曝光。归因结论附证据快照,供人工复核;高影响动作须经人工批准方可执行。
AI智能体经Amazon Data MCP直接调用结构化工具(21 个工具的用法见MCP 工具文档),无须解析原始页面:搜索、商品、评论等工具各司其职,归因所需上下文一次取回。工具调用记录随事件存入时间线,归因过程本身亦可复核。
第六步:工作区交付
诊断简报经Webhook直达团队工作区,如Slack、Microsoft Teams或Lark,附交互卡片与人工批准按钮。低风险防御动作可自动化;调价与申诉等高影响动作只提供建议与证据,不自动执行。监控闭环以”已处理”的处置记录结束,而非以告警发送结束。
上述流程可基于实时数据层搭建:亚马逊排名及价格监控解决方案以Amazon Scraper API按需抓取实时搜索结果页与商品页(数据采集方式详见Scraper API 文档),结合提供21个工具的Amazon Data MCP,由AI智能体完成归因与交付。接口平均响应约3秒,成功率99.9%,覆盖13个站点并支持原生邮编定位,赞助位捕获率90%以上;免费套餐每月60 credits,结构化JSON每页1 credit。
每次快照必须存什么
快照是时间线的最小解释单元:一次快照必须同时存下排名数字与产生该数字的全部条件,缺失任一条件,事后归因即无从验证。
快照数据模型
一条快照至少包含:时间戳、站点、邮编、关键词、自然排名与赞助位分布、净价与优惠券、库存与配送承诺、Buy Box赢家、评分与评论数、所属BSR与子品类节点排名。各字段同属一次采集,不可分批拼接;字段含义在监控启动前固定,避免中途变更口径。
覆盖写为何丧失解释能力
覆盖写只保留最新状态,历史被抹除后,排名变化失去参照点:无法确认变化发生在两次采集之间的哪一刻,也无法取回变化发生时的价格、优惠券与配送承诺。追加式存储以磁盘换取解释能力,是时间线可用的前提。
哈希变化检测
每条快照对其商业属性计算哈希值并与上一条比对,哈希不同即存在变化,相同即跳过归因。哈希比对先于阈值判断:先确认是否变化,再判断变化是否超过容差。哈希值随快照一并存储,可复核、可追溯。
卖家后台报告并非替代品:Seller Central Business Reports延迟24–48小时,SQP按周或按月成批发布并滞后2–3天,无法支撑日内归因。时间线须由实时采集建立,平台报告只作事后校准。
时间线保留期限与监控目标一致:短期复盘需要近期快照,长期趋势分析需要跨季度快照。删除旧快照前,确认其解释价值已被归因结论承接;归因结论须引用快照编号,使结论可回溯至原始数据。
赞助位分布须随快照一并记录:顶部赞助商品数量、赞助品牌是否出现、自然结果首条位置。自然排名不变而赞助位增多时,可见性仍在下降;缺少该字段,曝光变化将无从解释。
告警阈值怎么定才不误报
阈值不是越严越好:容差须大于亚马逊每日2–3位的自然波动,又须小于值得行动的变化;正确阈值使告警只在需要人工判断时出现。
静态阈值的缺陷
固定阈值以同一尺度衡量全部关键词:对核心词过松,对长尾词过严。亚马逊算法测试与日内个性化常使排名自然波动2–3位,若以移动2位即告警,收件箱将被无须行动的通知占满,Buy Box丢失与竞品优惠券攻势反而被淹没。
自然波动带
自然波动带指排名在无结构性变化时的日常摆动区间。对多数关键词,该区间为2–3位。设定阈值前,先以时间线测出各关键词的常态摆动:波动带窄的词容差收紧,波动带宽的词容差放宽;以全站统一阈值替代分组容差,是误报的主要来源。
容差设定方法
容差分层设定:核心成交词以移动超过3位为触发线,长尾词按各自波动带放宽;单次越线只记入时间线,连续越线或伴随Buy Box赢家变更、净价变动时升级告警。每次调整阈值后,记录调整原因与生效时间,使阈值本身亦可复核。
告警分级决定送达方式:仅需知晓的变化写入日报汇总,需要人工判断的变化即时推送至工作区,Buy Box丢失与缺货等结构性变化置顶并附处置建议。分级标准在监控启动前与团队约定,事后按误报率复核调整。
阈值不是一次性设定:关键词进入旺季、竞品上新或广告结构调整后,波动带随之改变。阈值复核与监控复盘同步进行,复核结论记入时间线,使阈值调整本身留有记录。
常见问题
以下问答覆盖监控关键词排名时最常被问及的五个判定问题,答案均可直接作为操作依据。
Q1:关键词排名多久查一次合适?
核心成交词在高峰时段每1–2小时查一次,长尾词每24小时查一次;出现异常后自动加密至每30分钟一次并持续6小时。
Q2:关键词排名与BSR哪个更重要?
两者度量不同对象:关键词排名反映搜索可见性,BSR反映品类销量速度;监控搜索表现以关键词排名为准,BSR只作销量趋势参照。
Q3:排名波动几位才需要处理?
亚马逊排名每日自然波动2–3位;核心词移动超过3位且连续出现,或伴随Buy Box赢家变更、净价变动时,才升级为需要处理的告警。
Q4:同一关键词在不同邮编下排名不同怎么办?
固定邮编再比较:以90001、60601、10001分别代表西海岸、中西部与东海岸需求,同一邮编下的时间线只与自身历史比较,不跨邮编比较。
Q5:免费开始监控关键词排名需要什么?
以Pangolinfo免费套餐起步:每月60 credits,结构化JSON每页1 credit,可先对核心ASIN与关键词建立时间线,再按需扩展至更多站点与邮编。
按上述方法搭建监控后,排名变化均可回溯至快照与成因;需要完整落地方案时,可参考亚马逊排名及价格监控解决方案,以实时数据与AI智能体承载六步流程。