
排名监控不准,不是工具损坏,而是被追踪的数字从来不是一个数字:关键词排名、BSR 与子品类排名是三种不同的排名,分属不同时刻、不同地点、不同数据;混同三者或采样不一致,读数无法互相比较。
本文先分清三种排名的定义与量纲;再逐一解析八个盲点的症状、成因与修复;最后给出一份可直接执行的自查清单,供读者逐项核对自己的监控工具。
三个排名,先分清楚
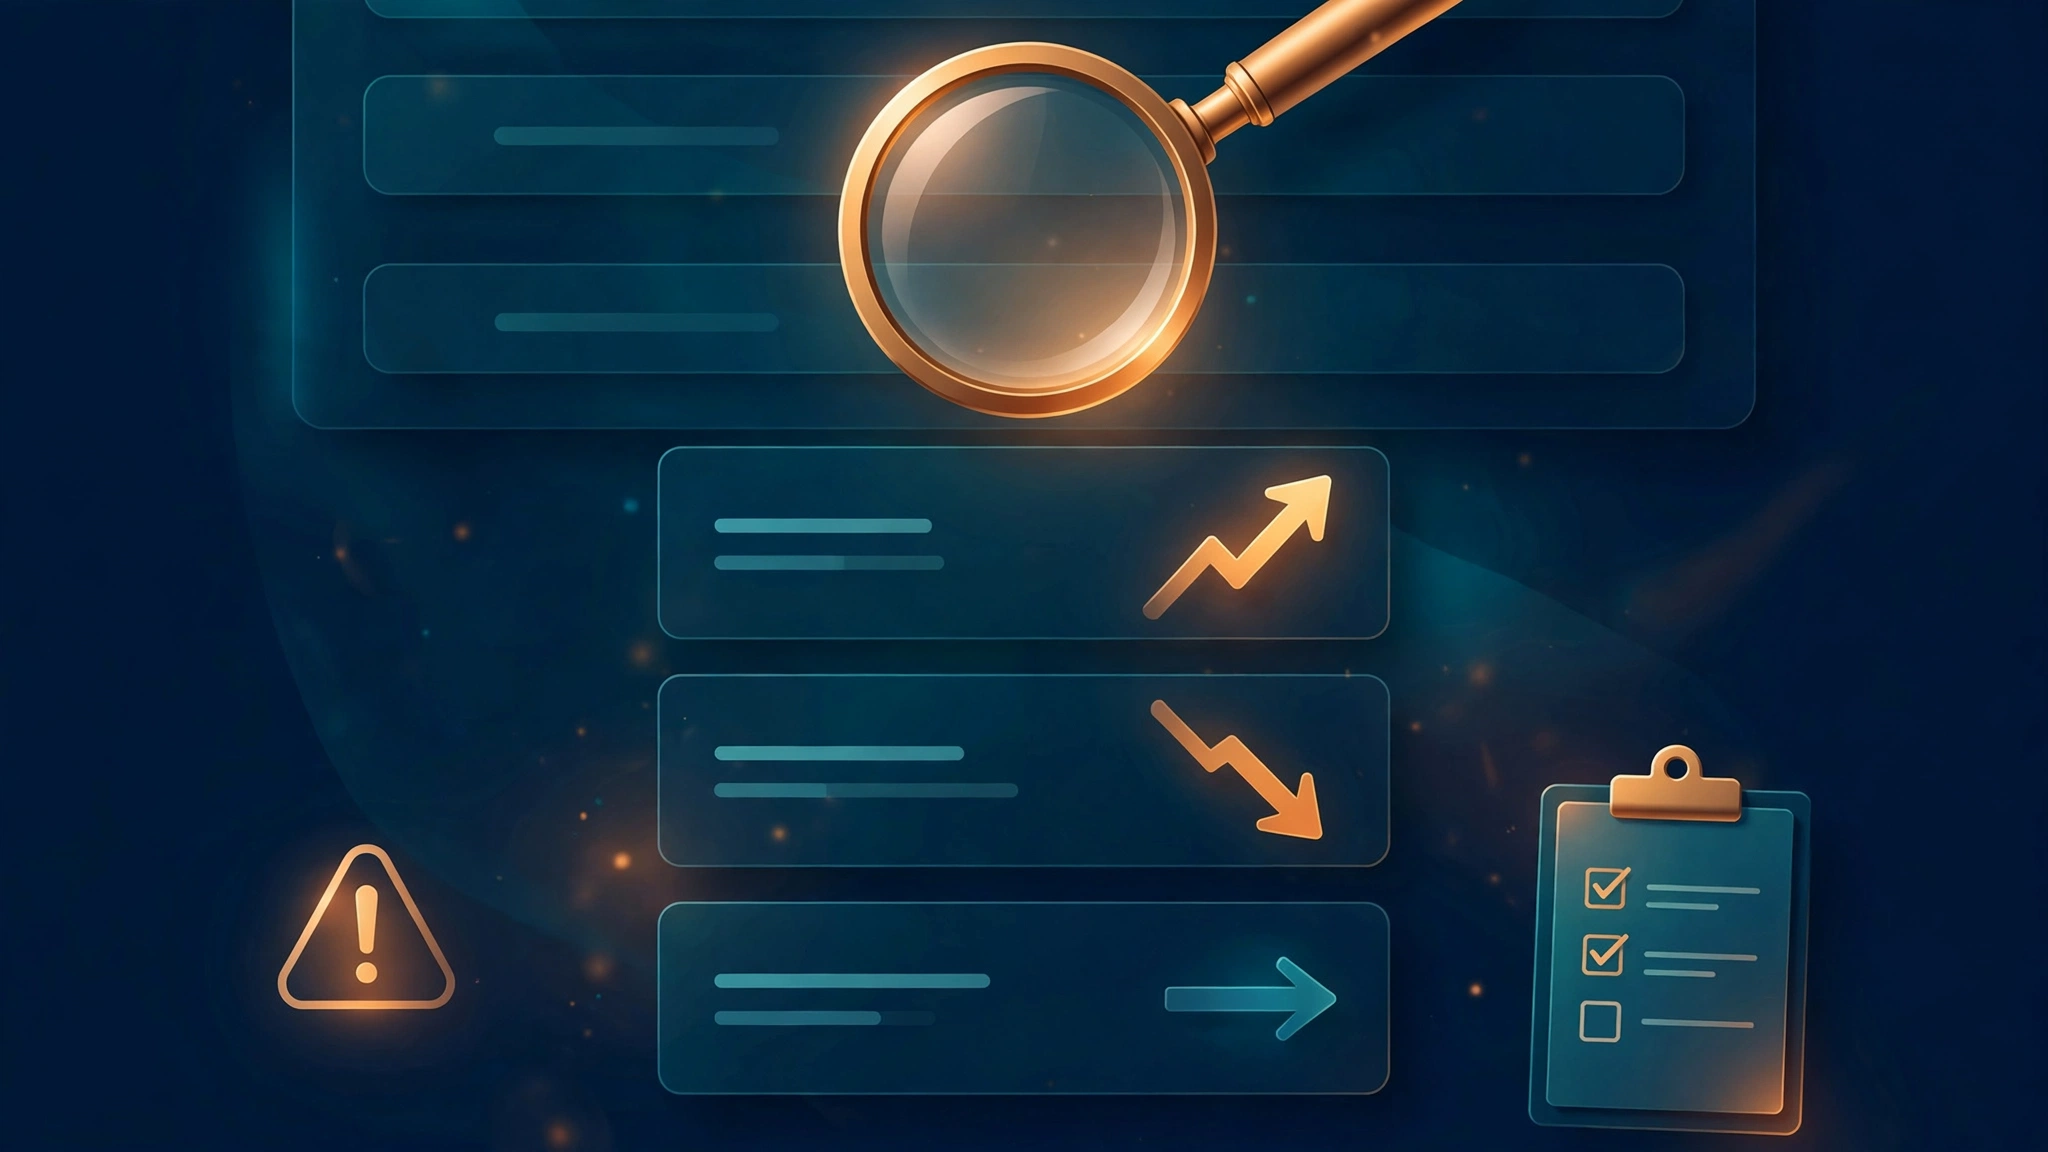
三种排名量的是三种不同的事实:关键词排名量搜索结果页内的相对位置,BSR 量全站销量排名,子品类排名量浏览节点内的相对位置;定义不同,量纲不同,变化方向亦可各自独立,混同即失真。
关键词排名:量搜索结果页内的相对位置
关键词排名指某一关键词搜索结果页中商品的自然排序位置,同一商品在不同关键词下排名各异;排序受搜索词、邮编、设备与会话条件影响,同一关键词在不同邮编下的读数可相差数位,须以固定条件重复测量才可比较。
BSR:量全站销量排名
BSR 是全站销量排名,按近期销量排序,反映销售速度而非曝光位置;BSR 变化只说明销量相对变化,不说明搜索可见性变化。BSR 上升可能源于销量上升或竞品销量下降,二者含义不同,须区分。
子品类排名:量浏览节点内的相对位置
子品类排名是浏览节点内的相对位置,同一商品可同时归属多个节点,在不同节点下的排名各异;节点归属由类目结构决定,排名变化可能源于节点内竞争变化,亦可能源于节点归属变更,须注明节点。
三者并用时,关键词排名回答可见性,BSR 回答销售速度,子品类排名回答节点内相对位置;三者各司其职,不可互相替代。读数须注明量纲:脱离量纲的排名数字没有比较意义。
以 BSR 推断关键词排名是常见错误:销量上升时 BSR 上升,搜索可见性未必上升;以 BSR 代替关键词排名,优化方向即告错误。
赞助位亦影响读数:赞助位占据搜索结果页前列,自然结果被推至移动端首屏之下;赞助份额变化时,自然排名未变而可见性已变,须同时记录赞助位分布。
三种排名各自独立运动:关键词排名上升时 BSR 未必上升,BSR 下降时子品类排名未必下降;三者由不同机制决定。把三者画在同一条曲线上,或以其中一者的变化推断另一者,结论无依据。
八个盲点:症状、成因、修复
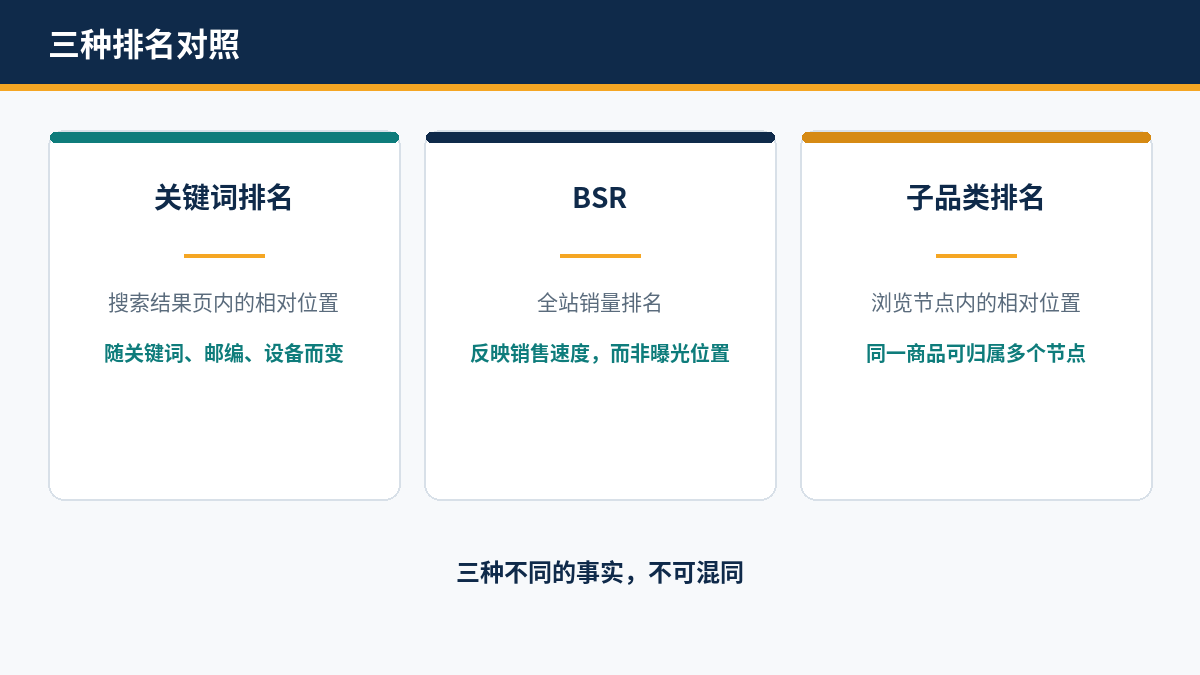
八个盲点各有不同症状,却共享同一根源:读数脱离了产生它的条件。症状是读数不可信,成因在数据层与度量方式,修复须从数据层入手,而非更换界面或增加告警。盲点之间相互放大:可比性漂移使快照无因果更难修复,新鲜度滞后使告警疲劳更易发生;单点修复不足,须以数据层重建为前提。
(一)快照无因果
症状:快照只显示排名变了,不显示排名为何变。成因:只存当前值,不存排名数字背后的条件——价格、优惠券、库存、Buy Box 赢家与搜索结果页布局缺失其一,归因即无从谈起;变化发生后,解释的依据已随旧值一并丢失。
修复:每次采集以快照存下全部条件,变化发生时逐项比对前后快照;快照以 SHA-256 哈希标识内容版本,哈希不同即内容不同;比对的粒度即是归因的粒度,条件缺失的快照不具备解释力。
(二)三排名混同
症状:关键词排名、BSR 与子品类排名被当作同一数字比较,曲线上的每一次起伏都可能只是量纲切换。成因:三者定义不同、量纲不同、运动机制不同,监控工具未加区分即并列呈现,读数者亦无从分辨。
修复:三者分开存储、分开呈现、分开设定阈值,比较只在同类排名之间进行;跨排名的比较须先换算为同一量纲,量纲须与读数一并呈现,缺失量纲的排名数字不进入结论。
(三)可比性漂移
症状:同一关键词连续两日的读数相差数位,却无任何可解释的变化。成因:采集未固定站点与邮编,读数来自不同会话条件;示例邮编 90001、60601、10001 下的同一关键词读数本就不同,漂移来自条件而非市场。
修复:以单次采集固定站点与邮编,Amazon Scraper API 在单次采集内固定站点与邮编,接口平均响应约 3 秒,成功率 99.9%,覆盖 13 个站点;邮编 90001、60601、10001 各自对应独立的时间线,不可合并;数据采集方式详见 Scraper API 文档。
(四)跨模块语境丢失
症状:排名变了,价格、评论与广告数据却各在一方,无法拼成一次变化的完整解释。成因:排名、价格、评论来自不同来源、不同时刻,字段无法按同一时间戳连接;缺失的语境只能由猜测填补,猜测不是归因。
修复:以单次采集同时取得价格、排名与评论字段,净价、优惠券与 Buy Box 赢家一并存入同一快照,缺一即无法归因;快照以结构化 JSON 返回,每页 1 credit,HTML 或 Markdown 每页 0.75 credits,评论每页 5 credits;评论数据作为佐证,评价数量与评分的突变常伴随价格与排名变化,评论数据获取方式见 评论 API 文档。
(五)变体与多站点覆盖缺口
症状:父子变体只监控其一,或仅覆盖单一站点,变化发生在监控范围之外。成因:按层级与 ASIN 计费的配额把监控范围切成碎片,变体与多站点覆盖常被舍弃;覆盖缺口不报错,只以沉默呈现。
修复:按监控单元定义范围,变体、竞品与多站点一并纳入,多站点覆盖 13 个站点、按站点分别建表;覆盖缺口须明示于清单,不以沉默代替缺失,缺口之外的变化不得计入结论。
(六)静态阈值告警疲劳
症状:告警频发,多数并无实际变化,团队逐渐不再响应。成因:静态阈值无视亚马逊每日 2–3 位的自然波动,正常波动亦触发告警;告警失去区分度,即失去作用。
修复:按关键词分组设定容差带,窄带词收紧、宽带词放宽;单次越线只记入时间线,连续越线时升级告警。Buy Box 占销售额 80–82%(移动端 85–90%),赢家变更时亦升级告警。
(七)新鲜度滞后
症状:变化发生当日毫无察觉,数日后才从报表中得知。成因:SaaS 日批量采集存在最长 24 小时的盲区,Seller Central 业务报告延迟 24–48 小时,搜索查询绩效(SQP)按周或按月汇总且滞后 2–3 天;三者叠加,变化发生后的数日内均无可靠读数。
修复:以实时按需采集替代日批量,接口平均响应约 3 秒,成功率 99.9%,覆盖 13 个站点;每一次读数都是当时当地的真实读数,变化发生当日即有新快照,实时按需将盲区降为一次采集的响应时间。
(八)刚性分层成本
症状:为控制成本而削减监控范围,或为扩大覆盖而被迫升级套餐,二者必居其一。成因:分层订阅按 ASIN 数量与层级收费,覆盖与预算直接对立;监控范围由付费层级决定,而非由业务需要决定。
修复:按成功结果计费的 credit 模式只对成功返回的结果计费,小规模用量对应小额成本,覆盖不再以预算为代价;按成功结果计费时,免费套餐每月 60 credits 可先小规模起步,完整落地方案见 亚马逊排名及价格监控解决方案。
自查清单:你的监控工具准不准
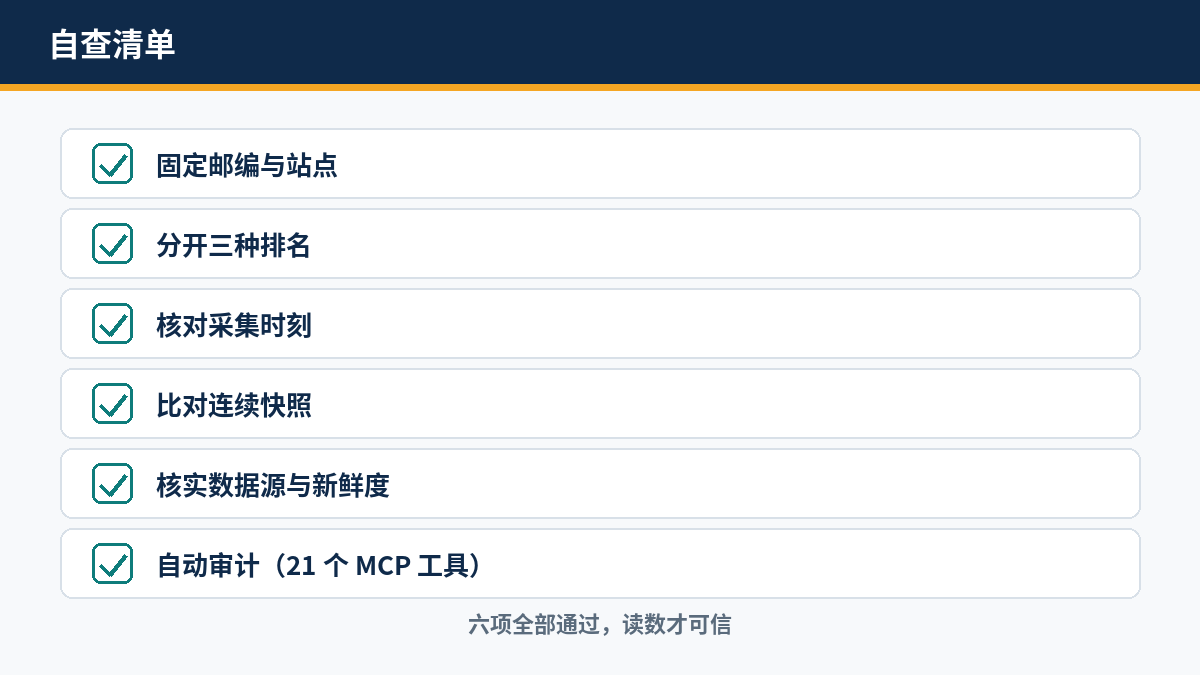
清单的判定标准只有一条:每一次读数能否与前一次读数在同一条件下比较。六项检查逐项通过,监控读数才可信;任一检查失败,读数均须先标注条件再使用。
第一,固定邮编与站点:每一次读数都注明站点与邮编,示例邮编 90001、60601、10001 下的读数各自独立;未固定邮编的连续读数不可比较。
第二,分开三种排名:关键词排名、BSR 与子品类排名分开存储、分开呈现、分开设定阈值;比较只在同类排名之间进行。
第三,核对采集时刻:每一条快照都带有时间戳,变化发生当日即有新快照;抽查变化发生日的快照,确认采集时刻与变化时刻一致。
第四,比对连续快照的可比性:前后两次快照的站点、邮编与采集方式一致,哈希不同才确认变化;条件不一致的两次快照不可直接比较;条件包括站点、邮编、设备与会话。
第五,核实数据源与新鲜度:确认数据来自实时按需采集而非日批量缓存,接口平均响应约 3 秒,成功率 99.9%;赞助位捕获率 90% 以上,搜索结果页布局完整方可归因。
第六,自动审计:Amazon Data MCP 提供 21 个结构化工具,可调用工具逐项核对清单,21 个工具的用法见 MCP 工具文档;未通过的检查项须标注条件后方可使用读数。
审计时抽查三组读数:同一关键词不同邮编下的读数、同一 ASIN 三种排名的读数、同一变化日前后的快照;三组各取一例,盲点即显形。
清单每月执行一次,监控范围变更后即时复核;审计结果本身存入时间线,使每一次结论都可回溯至核对时的条件。
自查清单与八个盲点一一对应:固定邮编与站点修复可比性漂移,快照带时间戳修复新鲜度滞后,容差带修复告警疲劳;清单通过之日,即是盲点消除之时。
常见问题
以下问答覆盖判断排名监控是否准确时最常被问及的五个问题,答案均可直接作为操作依据。
Q1:为什么同一关键词在不同工具里的排名不一样?
因为三者量的不是同一数字:关键词排名、BSR 与子品类排名定义不同、量纲不同;加之采集时刻、站点与邮编不一,读数自然不同。比较前须先确认排名口径与采集条件。
Q2:排名一天波动 2–3 位,需要处理吗?
无须处理:亚马逊排名存在每日 2–3 位的自然波动,静态阈值下的单次越线多为噪声;只当波动超出容差带、连续越线或伴随价格、Buy Box 变化时,才须介入。
Q3:邮编对排名影响有多大?
影响显著:同一关键词在不同邮编下的搜索结果页不同,读数可相差数位;监控须固定邮编,示例邮编 90001、60601、10001 下的读数各自独立,不可混用。
Q4:免费开始监控排名需要什么?
免费套餐每月 60 credits,结构化 JSON 每页 1 credit;先以单站点、少数 ASIN 与关键词起步,核对数据口径与可比性,再决定是否扩大覆盖。
Q5:如何判断监控工具是否可信?
逐项核对自查清单:固定邮编与站点、三排名分开、快照带时间戳、连续快照条件一致、数据源实时、赞助位捕获率 90% 以上;六项全部通过,读数才可信。
按上述清单核对后,读数不可信的原因均可定位到具体盲点;需要一套修复这些盲点的监控方案时,可参考 亚马逊排名及价格监控解决方案。方案以实时数据层加追加式时间线替代日批量与静态阈值。