
亚马逊数据 API 集成摘要
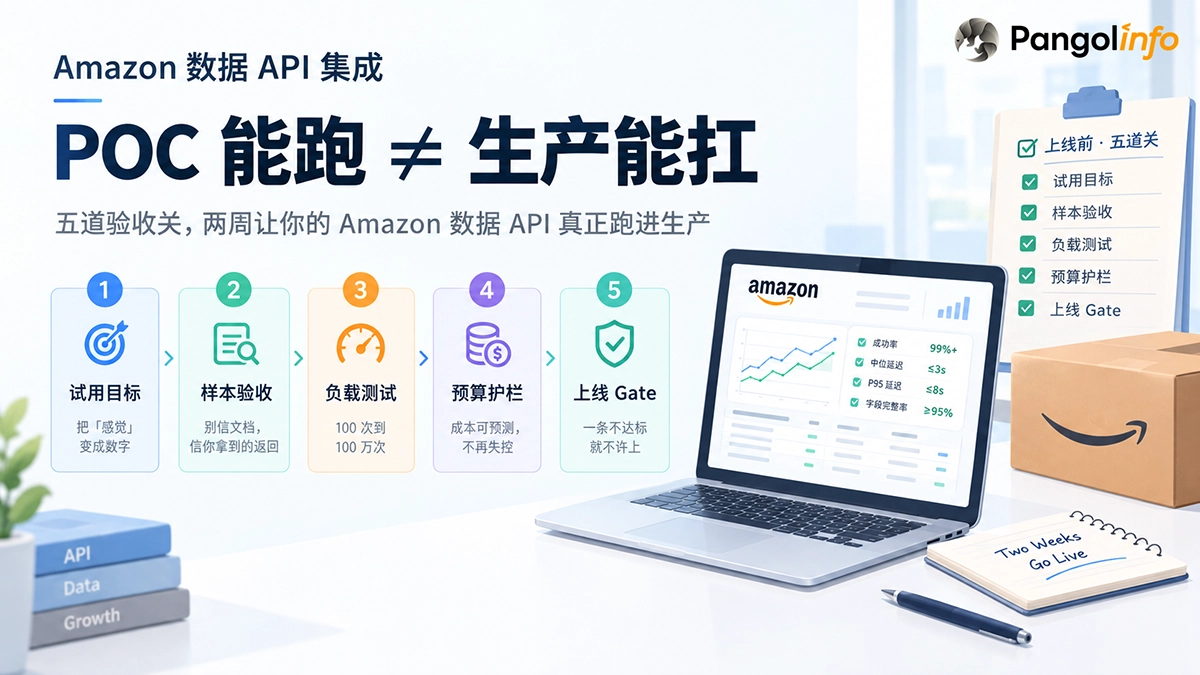
一家做选品工具的公司,用五十个 ASIN 跑通了 Amazon Scraper API 的接入,延迟「看起来不错」,字段「该有的都有」,于是签了合同,直接切进生产。上线的第一个周一,流量涌进来,请求超时率蹿到 18%,月底账单比预估高出三倍,团队被迫回滚。问题不在 API,在于他们把 POC 当成了上线依据。POC 验证的是「通路存在」,生产要求的是「通路在压力下稳定」,中间隔着五道验收关。这篇文章把亚马逊数据 API 集成五道关排成一份两周可执行的验收计划:试用目标、样本验收、负载测试、预算护栏、上线 gate。每道关都有可抄的阈值和一张打勾表,做不完,就别上线。
先定一个前提:这里讲的是「选型已定、准备落地」的阶段。如果你还没想清楚要自建爬虫还是调 API,那是另一个决策,放在选型篇里讲。这篇假设你已经选定了一个数据服务,手里有 key,接下来要回答的问题是:怎么证明它能进生产。
一、POC 通过,到底证明了什么
先承认 POC 的价值,再划清它的边界。一次合格的 POC 能回答三件事:字段有没有(返回里是不是真的有你要的那几个字段)、延迟量级对不对(中位数落在哪个区间)、计价口径清不清楚(按请求还是按记录计费)。这三件事确认了,说明这条数据通路是存在的,选型可以往下走。
POC 回答不了的也有三件事。第一,规模:五十个 ASIN 的抽样请求,证明不了百万级调用下的稳定性,两者之间差着数量级。第二,请求模式:POC 阶段多是顺序发请求、看单次结果,生产的真实负载是并发、重试、突发尖峰混合在一起。第三,失败场景:限流了怎么办、超时了怎么办、某个字段突然缺失了怎么办——这些在 POC 里通常碰不到,在生产里天天见。把 POC 的结论直接搬进生产,等于拿一份健康证去跑马拉松。
所以正确的姿势是:把 POC 当作验收计划的起点,而不是终点。POC 证明「能通」,后面的五道关证明「能扛」。下面五节按顺序走,每一节产出一样东西,攒齐了才构成上线的理由。
二、第一关:试用目标写不成数字,POC 就白做了
多数团队做 POC 的结论是「感觉还行」「大概够用」。这六个字没法验收,也没法在出问题后追溯是谁的责任。第一关做的事只有一件:把「感觉」翻译成数字,写进一份双方都认的验收阈值表。
一张能用的阈值表,至少要有四行:
| 指标 | 验收阈值 | 为什么是这个数 |
|---|---|---|
| 成功率 | ≥ 99% | 低于它,用户侧的失败重试会把你的重试队列打爆,下游雪崩 |
| 中位延迟 | ≤ 3 秒 | 前端列表页一次加载通常并行发十几个请求,单请求中位 3 秒是体感上限 |
| P95 延迟 | ≤ 8 秒 | 中位数好看没用,长尾才是用户体感;P95 超过 8 秒说明少数请求在拖垮整体 |
| 字段完整率 | ≥ 95% | 目标字段在样本中的出现率,价格、评分、库存这类核心字段低于 95% 就要查数据源 |
这张表的数字不是拍脑袋定的,要贴着你的业务场景来。做实时比价工具的团队,延迟阈值要压到更紧;做离线选品报告的团队,延迟可以放宽,但字段完整率要抬高。关键是在动工前写死,而不是上线后出了问题再来「复盘当时为什么没定」。写完之后,把这张表发给你要对接的供应商——如果对方对某个阈值有异议,现在谈,比上线后撕划算。
三、第二关:样本验收,别信文档,信你亲手拿到的返回
文档写的是供应商「承诺」的字段,返回里才是你「实际拿到」的字段,两者之间的差距是集成项目返工的头号来源。第二关做的事:拿一批真实 ASIN 打请求,把返回逐字段和文档对照,建一张样本验收表。
样本怎么选,决定这张表有没有效。别只拿热门商品(iPhone、畅销书),那些是数据最干净的;要刻意混入变体商品(同一父 ASIN 下多个子体)、缺货商品、评论数为零的商品、跨类目商品——这些边界样本才暴露字段陷阱。一个 ASIN 返回的价格字段到底是不是「当前售价」、一个变体的 size 到底是容量还是内存、评论里返回的 asin 是不是你请求的那个——这类问题字段契约篇里有八个实测陷阱,这里不重复,只强调流程:每个字段都要有「期望值、实际值、判定」三列,判定不合格的字段单独列出来,找供应商要解释。
样本验收表长这样,建议直接照抄:
// 样本验收表(每行一个字段,判定 = pass / fail / need_confirm)
sample: ASIN=B0CMZFCQ6D (iPhone 15 128GB, White), marketplace=US
fields:
  - name: title
    expected: 非空且包含品牌词
    actual: "Apple iPhone 15 (128 GB) - White"
    verdict: pass
  - name: price.value
    expected: 数字,货币为 USD
    actual: 699.00
    verdict: pass
  - name: price.strikethrough
    expected: 可选,出现时为数字
    actual: 799.00
    verdict: need_confirm   # 这是 List Price 还是 Typical Price?
  - name: images
    expected: 数组,元素为图片 URL
    actual: ["https://.../img1.jpg", ...]
    verdict: pass
  - name: reviews.count
    expected: 数字,与页面一致
    actual: 1284
    verdict: need_confirm   # 与前台显示 1271 有 13 条偏差,需确认口径
这张表的价值不在「发现多少字段缺失」,而在逼你在上线前把每个字段的语义钉死。一个字段你现在的团队能看懂,不代表三个月后接手的人能看懂,更不代表下游的报表和 BI 能正确处理。need_confirm 的项要么升级成 pass,要么升级成 fail,不许悬着。
四、第三关:负载测试,把 100 次放大到 100 万次
POC 阶段你发的是一百次请求,生产要扛的是一百万次。第三关做的事:在接近生产的负载下,看成功率、延迟、数据新鲜度三个指标往哪个方向走。
负载测试要模拟三个维度,缺一个都会漏。第一是并发:生产不是一个人顺序点,是几百上千个请求同时打进来,测你设的并发上限下错误率升不升。第二是突发:大促、上新、黑五,流量是脉冲式的,测一个尖峰(比如 3 倍均值持续十分钟)之后系统能不能恢复。第三是限流响应:供应商给你设了 QPS 上限,打满之后它是返回 429 让你等,还是直接断连?它的限流错误码长什么样、重试要不要退避,这些必须提前知道,否则生产里限流一触发,你的代码就不知道该怎么处理。
负载下要盯的指标里,延迟衰减曲线比成功率更早暴露问题。请求量翻倍,中位延迟可能只涨 10%,但 P95 可能涨 300%——因为长尾请求在排队。只盯成功率,等到成功率掉下来已经晚了。另一个容易被忽略的是数据新鲜度在负载下的表现:供应商在高压下可能会切换到缓存来保延迟,这意味着「实时」的数据可能悄悄变成「五分钟前」的。三时钟模型怎么测数据新鲜度是另一篇的主题,这里只要记住:负载测试阶段,把数据新鲜度当成和延迟并列的第三个指标一起测。
测完之后,回到第二关那张阈值表,把「POC 阶段达标」改成「负载下达标」。很多供应商 POC 阶段成功率 99.9%,负载一上来掉到 96%,而你第二关写的阈值是 99%——这条就不及格,要么让供应商调,要么调整你的架构去兜底。
五、第四关:预算护栏,账单超了,生产就得下线
成本失控是集成项目最常见的死法,而且往往死得很安静:不是一次性超了,是每个月都超一点,等发现的时候已经超了半年。第四关做的事:把成本从「月底看账单」变成「实时有护栏」。
第一步是把计价口径吃透。你的供应商是按请求计费还是按记录计费——这两个口径差着数量级,一个请求可能返回几十条记录,按记录计费时成本会随结果集大小膨胀,而不是随你的调用次数。定价篇拆过哪些地方会加价,这里不重复,只强调:在签合同前,用你自己的真实数据算一遍单次请求成本,别用供应商给的「示例场景」。
第二步是上三道护栏。用量告警:设 70% 和 90% 两档配额告警,触线就发通知,别等 100%。熔断:单日或单小时用量超过硬上限时,自动降级——把非核心请求切到缓存,只留核心请求打真实接口,而不是整体下线。第三道是单位成本监控:把成本摊到每个业务动作上(每抓一个 ASIN、每拉一条评论的成本),一旦单位成本翻倍,立刻能定位是哪个接口的用量异常,而不是月底对着总账单发懵。
预算护栏的价值不在「省钱」,在「让成本可预测」。一个可预测的成本,才能让你敢把数据接口用进核心业务;一个不可预测的成本,团队会不自觉地少用、绕用、用影子接口,最后账更难算。
六、第五关:上线 gate,一条不达标就不许上
前四关攒齐了证据,第五关是把它们变成一道硬闸门:一张上线 gate 清单,每一条要么通过要么不通过,没有「基本通过」「差不多」。这张表要贴在发布流程里,而不是贴在项目经理脑子里。
| Gate 项 | 通过标准 | 不通过的后果 |
|---|---|---|
| 阈值复验 | 负载下成功率 / 延迟 / 字段完整率仍达标 | 回到第三关,找供应商调优或改架构 |
| 限流与重试 | 限流错误码已处理,重试带退避,不放大请求 | 生产限流会引发重试风暴 |
| 降级开关 | 接口故障时有缓存 / 降级兜底,核心链路不裸奔 | 单点故障直接拖垮下游 |
| 预算熔断 | 用量告警与熔断已生效,演练过触发 | 成本失控,被迫下线 |
| 监控告警 | 成功率 / 延迟 / 用量 / 成本四类指标上监控 | 出问题靠用户投诉才发现 |
| 回滚方案 | 能一键回滚到上一个稳定版本 | 故障时束手无策,扩大事故 |
上线不是「切开关」这一个动作,而是灰度、观察、放量、回滚四步。先放 10% 的真实流量,盯住四类指标,稳定后再放到 50%、100%;每个放量节点之间留观察窗口,任何一项指标偏离基线就停下。回滚方案要在上线前就演练一遍——不是「我们肯定能回滚」,而是真的回滚过一次、计时过需要多久。
七、两周验收计划:五关怎么排进日历
五道关听起来多,排进日历两周够了。关键是把「写文档」和「动手测」穿插起来,别攒到最后一周才一起做。
| 时间 | 做什么 | 产出 |
|---|---|---|
| 第 1–2 天 | 第一关:定试用目标;第二关开跑:选边界样本、建样本验收表 | 验收阈值表 + 样本验收表 |
| 第 3–5 天 | 第二关收尾 + 第三关:负载测试(并发 / 突发 / 限流) | 负载下指标曲线 + 阈值复验结论 |
| 第 6–7 天 | 第四关:吃透计价口径、算单位成本、上告警与熔断 | 成本模型 + 三道护栏生效 |
| 第 8–10 天 | 第五关:过上线 gate、搭灰度、写回滚方案 | Gate 清单全绿 + 回滚演练记录 |
| 第 11–14 天 | 灰度放量:10% → 50% → 100%,每档留观察窗口 | 上线,或带着依据决定回滚 |
两周不是硬性的,取决于你的团队规模和业务复杂度,可以压到十天,也可以拉到一个月。要紧的是顺序:先定目标,再验样本,再压负载,再锁预算,最后才谈上线。反过来做——先上线再补验收——是绝大多数集成事故的起点。
回到开头那个案例:那家选品工具公司如果在上线前跑完这五关,会在第三关就发现并发下 P95 延迟飙到了 12 秒,在第四关发现按记录计费会让成本随结果集膨胀,在第五关发现自己根本没有回滚方案。任何一个发现,都值得他们晚一周上线。晚一周上线,比上线三天后被迫回滚,体面得多。
这套验收流程里,API 本身只是其中一个变量。选一个在负载、字段、计价上都经得起验收的供应商,能让五关里的大多数顺利通过,而不是每关都要你写一堆兜底代码。Pangolinfo 的Amazon Scraper API每天处理 3000 万次以上调用,中位延迟约 3 秒、成功率 99%,SP 广告位采集率在 13 个市场公开可查(整体 91.4%)——这些数字的意义不是让你跳过验收,而是让验收有据可对。拿这套五关去验它,验得过,再谈上线。