
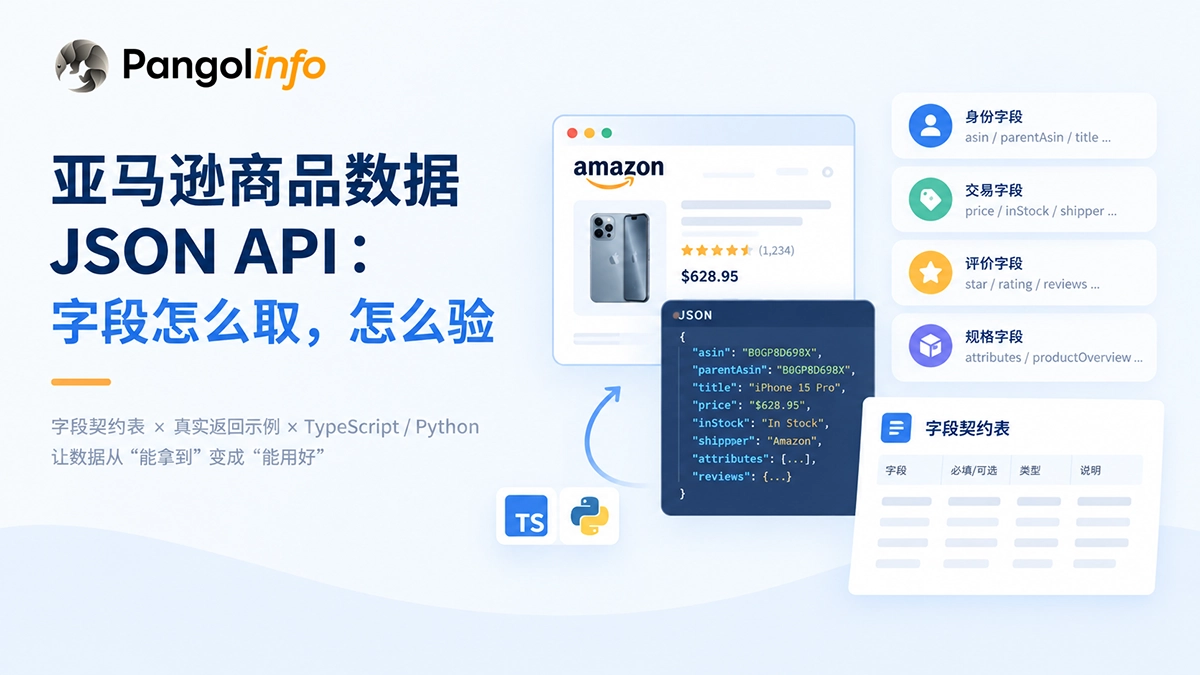
你要建的是一张字段契约表,不是一个数据管道。亚马逊商品数据 JSON API 最容易踩的坑不是拿不到数据,而是拿到了看起来对、实际不能用的数据:同一个 price 字段在不同变体上含义不同,size 存的是运行内存而不是容量,评论接口返回的 asin 属于另一件商品。字段契约表的作用,就是在写代码之前把这些边界写清楚——哪个字段必填、哪个可空、空值代表什么、同一个键在不同变体下量纲是否一致。这篇文章用两件同父商品(parentAsin 均为 B0GP8D698X)加一页评论的真实返回做样本,逐个拆开这些陷阱,给出一份可直接落到 TypeScript 与 Python 的字段词典、空值规则、schema diff 脚本和契约测试用例。
一、为什么字段级评估比接口级评估重要
选型阶段最常见的错误,是把「接入某 API 能不能拿到商品数据」当成评估目标。能拿到是默认状态,任何一家供应商都能通过这个测试。分野在字段层:同一个概念在不同供应商、不同变体、不同接口之间的表示方式并不统一,而这些差异会在你上线之后以脏数据的形式暴露出来。
举一个我们实测到的例子。同一件 iPhone 15 Pro Renewed,512GB 白色与 512GB 黑色,父商品(parentAsin)都是 B0GP8D698X,但两者返回的 strikethroughPrice 语义不同:白色版本返回 {"key": "List Price", "value": "$649.00"},黑色版本返回 {"key": "Typical price", "value": "$629.95"}。两个 JSON 结构一致、类型一致、都不为空,如果你的解析代码只取 strikethroughPrice.value 当「原价」,你会把两个含义不同的数字放进同一列:一个是厂商建议零售价,一个是亚马逊统计的 90 天成交中位数。数据入库成功,报表也会出数,但对比结果是错的。
字段级缺陷的共同特征是静默——它们不触发解析异常,不产生 null,不中断任务,只是在某个维度上悄悄地把两个不可比的东西混在一起。检测手段因此不能是「有没有报错」,而是「我对这个字段的假设,是否在每一个变体、每一个市场上都成立」。这就是字段契约表要解决的问题。它不是文档,是断言集合。
另一个容易被忽视的事实:字段的可空性本身携带业务信息。上面同一件商品的两个变体,一个 shipper 是空字符串,另一个是 "Amazon";一个 inStock 是 " Only 13 left in stock - order soon. ",另一个是 " In Stock "。如果你把空 shipper 当成「配送方是空」,下游的物流时效计算会立刻失真。空值从来不是「没有信息」,它要么是「该字段在这个变体上本来就不适用」,要么是「采集时刻上游没有提供」,这两种含义的处理方式不同。
二、先划对象:四类数据,四种更新节奏
在写字段词典之前,先把返回里的字段按业务对象分组。亚马逊商品数据的字段不是一堆平铺的键值,它们天然属于四个对象,各自有独立的更新频率、稳定性和使用方式。把这个划分做对,后面的必填与可选判断才有依据。
第一类是身份字段。包括 asin、parentAsin、title、itemName、brand、category_id、breadCrumbs。它们回答「这是什么商品、它在类目树的哪个位置」。这类字段的特点是稳定性高、几乎不随时间变化,是所有关联操作的主键来源。但注意 asin 的歧义——同一个键名在商品接口里指「你请求的商品」,在评论接口里指「这条评论所属的商品」,两者未必相同,第四节会展开。
第二类是交易字段。包括 price、strikethroughPrice、savingsPercentage、coupon、inStock、shipper、has_cart、seller。它们回答「现在卖多少钱、还有没有货、谁在卖」。这是全表变化最快的部分,分钟级波动,也是大多数业务场景依赖的字段。它们的空值率最高,量纲最不统一。
第三类是评价字段。包括 star、rating、ratingDistribution、reviews、aiReviewsSummary。它们回答「口碑如何」。变化速度是日级,但内部分层明显:评分分布的百分比可能长时间不动,评论内容则持续累积。
第四类是规格字段。包括 attributes、productOverview、features、productDescription、variantDetails、images、videos。它们回答「技术参数是什么」。这类字段数量最多、结构最不一致,也是最容易埋雷的区域——attributes 在同一父商品的两个变体上长度分别是 48 和 49,键集合并不相同。
分组之后,必填与可选的判断标准就清晰了:身份字段必须非空,交易字段必须允许为空但空值要有明确语义,评价字段的聚合值与明细值要分别建模,规格字段必须按「存在即用、缺失即降级」处理,绝不能做全量强校验。把规格字段设成必填,是新手最常犯的建模错误——它会让你的管道在遇到任何一件信息不全的商品时报错中断,而信息不全是亚马逊商品的常态。
三、必填与可选:不要用接口的键判断业务的可空性
一个反直觉的结论:返回里出现了这个键,不代表它在业务上可选;返回里是空字符串,也不代表这个字段不存在。JSON 的键存在性与业务的可空性是两个独立维度,混为一谈会导致两种相反的建模错误。
先看代码块层面的实现建议。下面的 TypeScript 类型把「必填非空」「必填可空」「可选」三种状态显式区分开,关键是用 | null 而不是 ? 来表达「字段一定在,但值可能是空」。
// 字段契约:三种可空性分别建模
type NonEmpty<T> = T;                 // 一定存在且非空
type Nullable<T> = T | null;          // 一定存在,值可能为空
type Optional<T> = T | undefined;     // 键本身可能不出现

interface ProductContract {
  // --- 身份字段:必填非空 ---
  asin: NonEmpty<string>;
  title: NonEmpty<string>;
  parentAsin: NonEmpty<string>;

  // --- 标题拆分字段:键一定在,值可能为空串 ---
  // 旧版上架商品 itemHighlights 恒为空串,不要用 ? 表达
  itemName: Nullable<string>;
  itemHighlights: Nullable<string>;

  // --- 交易字段:键一定在,值可能为空 ---
  price: Nullable<string>;            // 形如 "$628.95",含货币符号
  inStock: Nullable<string>;          // 自由文本,非枚举
  shipper: Nullable<string>;          // 可能为空串,空 != "无配送方"
  savingsPercentage: Nullable<string>;// 形如 "6%",含百分号

  // --- 结构化价格:嵌套对象,注意 key 的枚举不稳定 ---
  strikethroughPrice: Nullable<{
    key: string;   // 实测出现 "List Price" 与 "Typical price" 两种
    value: string;
    tip: string;
  }>;

  // --- 规格字段:一律可选,缺失即降级 ---
  attributes?: Array<{ key: string; value: string }>;
  productOverview?: Array<{ key: string; value: string }>;
  size?: string;                      // 注意:此处为运行内存,非存储容量
}
这个类型定义里有三处值得单独说明,它们直接对应实测到的三个陷阱。
第一处是 itemName 与 itemHighlights。亚马逊从 2026-07-27 起把商品标题拆成两部分:itemName 是标题主体,itemHighlights 是标题后缀(材质、用途、卖点)。但我们抓到的这件商品属于尚未完成拆分的旧版上架商品,此时 itemName 等于完整标题,而 itemHighlights 是空字符串。如果你的代码假设「itemName + itemHighlights 拼接等于完整标题」,在旧版商品上会丢掉后半段;如果假设「itemHighlights 一定有值」,会在旧版商品上全部落空。正确做法是:itemName 直接用,itemHighlights 为空时回退到 title。
第二处是 size。这件商品返回的 size 是 "8 GB"。乍看像容量,实际是运行内存——同一返回里 attributes 的「Memory Storage Capacity」是 "512 GB",「RAM Memory Installed」是 "8 GB"。把 size 当容量入库,你所有的存储容量筛选都会错一个数量级。更麻烦的是这个字段的语义并不跨类目稳定:卖服装时 size 是尺码,卖手机时它被复用为内存规格。字段名相同不代表语义相同。
第三处是 variantDetails 里的 size。这个数组里的 size 是变体选项值,取值是 " 512GB "(带首尾空格,无空格分隔),与顶层 size 的 "8 GB" 是两回事。同一个词「size」在这个 JSON 里出现了两次,一次指导运行内存,一次指导存储容量。这类同名不同义的字段,是契约表必须显式记录的内容。
四、变体:同一父商品下的字段漂移
变体是字段评估的核心区域,因为这里的陷阱最密集、最隐蔽,而且只在对比时才暴露。我们把同属 parentAsin B0GP8D698X 的两个变体做了一次字段级 diff,结果如下。

| 字段 | 白色 512GB(B0CMZFCQ6D) | 黑色 512GB(B0CMZ5KBNS) | 风险 |
|---|---|---|---|
strikethroughPrice.key | List Price | Typical price | 两个值语义不同,不可同比 |
strikethroughPrice.value | $649.00 | $629.95 | 基准不同,折扣率不可比 |
inStock | Only 13 left in stock – order soon. | In Stock | 自由文本,无法直接枚举 |
shipper | (空字符串) | Amazon | 空值语义未定义 |
attributes 长度 | 48 | 49 | 键集合漂移 |
Display Resolution Maximum | 2556 × 1179 pixels | 2556×1179 pixels | 全角乘号 vs 小写 x |
product_dims | 6 x 4 x 2 inches | 5.77 x 2.78 x 0.33 inches | 精度口径不同 |
price | $628.95 | $628.95 | 一致 |
parentAsin | B0GP8D698X | B0GP8D698X | 一致,可作分组键 |
rating | (5258) | (5258) | 一致,父级共用 |
这张表里最值得停下来看的是两个字段。
分辨率字段的写法不一致。同一件商品的两个颜色变体,白色版本返回 "2556 × 1179 pixels"(用的是全角乘号 U+00D7,数字间有空格),黑色版本返回 "2556x1179 pixels"(用的是小写字母 x,无空格)。两者指向同一个物理规格,但字符串不等。如果你按精确匹配做规格筛选或去重,这两个变体会被判定为不同商品。规格字段的清洗必须在入库前完成:统一乘号、统一大小写、统一空格,再去比较。这不是供应商的缺陷,是亚马逊页面本身写法不统一,任何采集方都会原样带出来。
attributes 的键集合会漂移。两个变体的属性条目数分别是 48 和 49,差的那一条是「Model Series」(黑色版本有,白色版本没有)。这意味着你无法用「所有变体都有某个 attribute」作为前提,也不能用固定列宽去展开这个数组。处理方式是把 attributes 当稀疏映射:按 key 建索引,缺失时走默认值,绝不假设键的完整性。同理,productOverview 也不是全集,它只承载页面上「重要信息」区块的那部分键,与 attributes 存在重叠但不相等——实测两者都包含「RAM Memory Installed / RAM Memory Installed Size」与「Memory Storage Capacity」,键名也不一样。
变体建模的实操建议是把 parentAsin 作为分组键。asin 标识具体变体,parentAsin 标识商品族。同一族内,评价与评分是共用的(两个变体都返回 (5258)),价格与库存是独立的。把这两个层级分开存,你才能在族级别做口碑分析、在变体级别做定价监控。混在一起会导致一个常见错误:把某个变体的评分当成整族评分,或者把整族的评论数摊到单个变体上。
评论接口的 asin 字段不等于你请求的 ASIN
这是本文最重要的一条实测发现,也是最能说明「为什么字段契约必须逐个验证」的例子。我们请求 ASIN B0CMZFCQ6D 的评论,返回 10 条评论,逐条检查其 asin 字段后得到的结果是:
// 请求 asin = B0CMZFCQ6D,返回 10 条评论的 asin 字段分布
B0CMYXFK3R  ×2
B0CMZL2TJ9  ×3
B0CMZBXYWX  ×1
B0CMZ7L14T  ×1
B0CRJRNTNS  ×1
B0CMZ9KS3G  ×1
B0CMZCGQDK  ×1
─────────────────────────────
distinct ASIN = 7
其中等于请求 asin(B0CMZFCQ6D)的条数 = 0

十条评论里,没有一条的 asin 等于我们请求的 ASIN。这不代表接口出错——它反映的是亚马逊真实的评论归属机制:评论挂在具体变体上,而 Renewed 商品族的变体共享评论池,页面聚合展示,所以你会拿到整个族里各个变体的评论。每条评论的 asin 告诉你它实际来自哪个变体。
这个事实直接决定了两件事。第一,如果你的代码用 reviews[].asin 去回填主商品记录,会污染数据——评论被挂到了错误的商品上。第二,如果你需要「这款商品自己的」评论,必须在拿到评论后按 asin 过滤,不能假设返回已按请求商品筛选。契约表里这一行的写法应该是:reviews[].asin 属于具体变体,可能不等于请求 asin;需要变体级评论时必须显式过滤;需要族级口碑时按 parentAsin 聚合。
顺带一个更细的字段格式分歧,藏在同一字段的两种形态里。评论接口返回的 star 是 "1.0 out of 5 stars",而商品接口 reviews 数组里的 star 是 "5 out of 5 stars"。前者带一位小数,后者是整数。同一个字段名,两个接口,两种格式。如果两端共用同一个解析函数,其中一端必然解析失败或被静默截断。正确做法是提取数字后统一为数值类型,不在字符串层做比较。
五、空值规则:把 null、空串和缺失分开处理
空值治理是字段契约里最容易写对、也最容易在实现时写错的部分。核心原则只有一条:区分「不适用」「未知」「取不到」三种空,并给每一种定义确定的下游行为。下表把实测到的空值形态与建议语义列在一起。
| 形态 | 实测例子 | 建议语义 | 下游行为 |
|---|---|---|---|
| 键存在,值为空串 | shipper: ""、itemHighlights: ""、fastestDelivery: "" | 本次采集未取到 / 该变体不适用 | 保留原值,标记为「未知」,不用 null 覆盖 |
| 键存在,值为 null | reviews: null、importantInfo: null、promotions: null | 该块在当期页面上不存在 | 跳过该块,不算失败 |
| 键存在,值为空数组 | videos: null 与空数组两种 | 内容为空 | 按空集合处理,不报错 |
| 键缺失 | 规格类字段在部分商品上不出现 | 商品未填写该属性 | 走默认值,计入填充率统计 |
| 值存在但为占位文本 | first_date: ""、color: "" | 页面未展示 | 同「未知」 |
实现层面,绝对不能把空串先归一成 null 再统一处理。上面的表说明了两者的信息量不同:shipper 为空串表示这次没取到配送方,而 reviews 为 null 表示这份商品详情页当前没有评论模块。把它们混成一个空值,你既无法统计供应商的字段填充率,也无法在填充率下降时判断是采集问题还是页面变化。
空值规则还要覆盖一个容易被忽略的场景:同一字段在不同变体上的可空性不同。同一件商品,一个变体 shipper 有值、另一个为空;一个变体 inStock 是「仅剩 13 件」,另一个是「有货」。这属于正常差异,不是数据质量问题。你的监控告警要把「字段为空」和「字段值异常」分开统计,否则会因为某个变体天然为空而持续误报。
inStock 是自由文本,不是枚举
单独说 inStock,因为它是被误用最多的字段。实测返回的两种取值是 " Only 13 left in stock - order soon. " 和 " In Stock ",注意首尾都有空格。这个字段承载的是亚马逊页面上的原始文案,形态包括「有货」「仅剩 N 件」「暂时缺货」等多种表达,且措辞会调整。
正确用法是把它当原文保存,另建一个派生字段做枚举映射:
import re

def normalize_stock(raw: str | None) -> tuple[bool | None, int | None]:
    """把 inStock 自由文本归一到 (是否有货, 剩余件数)。

    返回 (None, None) 表示无法判定,调用方须按「未知」处理,
    不得默认当作有货。
    """
    if not raw or not raw.strip():
        return None, None
    text = raw.strip().lower()
    if "left in stock" in text:
        m = re.search(r"(\d+)\s+left in stock", text)
        return True, int(m.group(1)) if m else None
    if "in stock" in text:
        return True, None
    if "unavailable" in text or "out of stock" in text:
        return False, 0
    return None, None   # 未知形态,保留原文待人工确认
这个函数里最关键的一行是最后的 return None, None。面对无法识别的库存文案,正确行为是标记为未知并保留原文,而不是默认判定为有货。缺货误判为有货,会让你的补货告警失效;有货误判为缺货,会造成无效的紧急调价。两种误判都有业务代价,而「未知」不会——它只是把一个未识别的形态暴露给你,让你去补充映射规则。
六、版本策略:字段漂移的处理方式
字段会变。亚马逊会拆分标题字段(本文样本里的 itemName / itemHighlights 就是 2026-07-27 之后的新结构),会调整属性键集合,页面改版会引入新的字段形态。供应商侧同样会调整返回结构。因此字段契约不是一个静态文档,它需要一套版本策略来承接变化。
我们的做法是把契约版本化,并用 schema diff 检测漂移。具体是三步。
第一步,把字段清单固化成快照。每次评估或每次供应商变更后,跑一遍采样商品,把每个 ASIN 的字段路径(如 strikethroughPrice.key、attributes[].key)、类型、是否可空、出现频次记录下来,存成一份基线文件。这份文件就是契约的机器可读形态。
第二步,用 diff 对比基线与新样本。下面这个脚本对比两份字段快照,输出新增字段、消失字段和类型变化。它的价值在于把「字段悄悄变了」变成一条可审阅的差异报告。
import json
from collections import defaultdict

def flatten(obj, prefix: str = "") -> dict:
    """把嵌套 JSON 压平成 {路径: 类型} 映射,数组统一记为 [] 结尾。"""
    out = {}
    if isinstance(obj, dict):
        for k, v in obj.items():
            out.update(flatten(v, f"{prefix}.{k}" if prefix else k))
    elif isinstance(obj, list):
        out[prefix + "[]"] = "array"
        for item in obj[:5]:          # 只取前 5 个样本,避免数组过长
            out.update(flatten(item, prefix + "[]"))
    else:
        out[prefix] = type(obj).__name__
    return out

def schema_diff(baseline: dict, current: dict) -> dict:
    added    = sorted(set(current) - set(baseline))
    removed  = sorted(set(baseline) - set(current))
    retyped  = sorted(
        p for p in set(baseline) & set(current)
        if baseline[p] != current[p]
    )
    return {"added": added, "removed": removed, "retyped": retyped}

def load(path):
    with open(path, encoding="utf-8") as f:
        return flatten(json.load(f))

if __name__ == "__main__":
    diff = schema_diff(load("baseline.json"), load("current.json"))
    for label, items in diff.items():
        print(f"[{label}] {len(items)}")
        for item in items:
            print("   ", item)
    # 退出码可用于 CI:出现字段变化即让流水线标记待审
    raise SystemExit(1 if any(diff.values()) else 0)
这个脚本退出码的设计是刻意的:有任何差异就返回 1,让 CI 流水线把它标成「待人工审阅」而不是直接失败。字段新增通常无害,可以直接接受;字段消失或类型变化则可能破坏解析。契约测试的定位是预警,不是拦截——它会拦下需要人判断的变更,但不阻断正常的发布节奏。
第三步,把契约测试接进 CI。测试用例分三类。第一类是结构断言:按第节的类型定义校验必填字段存在且非空、可空字段类型正确。第二类是语义断言,用固定样本验证已知陷阱的处理——例如断言 strikethroughPrice.key 无论取 List Price 还是 Typical price 都能被正确分类,断言 display resolution 的全角乘号与小写 x 两种写法归一后相等,断言评论按 asin 过滤后不污染主商品记录。第三类是填充率断言:对采样集统计各字段的非空比例,低于基线阈值即告警——这是发现上游页面改版导致批量字段丢失的最早信号。
三类断言管的都是「结构对不对、语义稳不稳」,它们回答不了另一个问题:这份数据是什么时候的。字段填得满,不代表填的是当下的值——一个每轮都非空的价格字段,可能来自两小时前的缓存快照。新鲜度需要独立的检测手段,我们把这个缺口单独写在怎么把实时性测出来里:三时钟模型拆时间戳、五个缓存特征做判别、再用 48 小时协议验证。字段契约与新鲜度验证是两道并列的关卡,缺一道都会留下盲区。
七、字段词典:实际要取哪些字段
把上面所有结论落到一张表。以下是做商品监控与数据分析最常用的字段,按四个对象分组,标注类型、可空性与处理要点。这份词典可以直接作为团队内部契约的起点。
| 字段 | 类型 | 可空 | 处理要点 |
|---|---|---|---|
asin | string | 否 | 变体级主键;评论接口中含义不同 |
parentAsin | string | 否 | 商品族分组键,评价共用 |
itemName | string | 是 | 标题主体;旧版商品为完整标题 |
itemHighlights | string | 是 | 后续为空须回退到 title |
brand / category_id | string | 否 | 类目分析的基础维度 |
price | string | 是 | 含货币符号,入库前转数值 |
strikethroughPrice | object | 是 | 必读 key,区分建议零售价与中位成交价 |
savingsPercentage | string | 是 | 含百分号;基准不明时不可跨变体比较 |
inStock | string | 是 | 自由文本,派生枚举,未知不默认有货 |
shipper | string | 是 | 空串 ≠ 无配送方 |
seller | object | 是 | 含 id,用 id 而非 name 做关联 |
delivery.deliveryTime | string | 是 | 亚马逊现算字段,可作活性探针 |
star | string | 是 | 商品接口与评论接口格式不同 |
rating | string | 是 | 含括号的计数,与 totalReviews 口径不同 |
ratingDistribution | array | 是 | 百分比之和可能因四舍五入不为 100% |
bestSellersRankItems | array | 是 | 按类目分别排名,须保留类目 |
attributes | array | 是 | 稀疏映射,键集合跨变体漂移 |
variantDetails | array | 是 | 选项值带首尾空格,须 trim |
size | string | 是 | 语义随类目变,手机类目下为运行内存 |
images / highResolutionImages | array | 是 | 缩略图与高清图分开存 |
关于评价字段还有一处口径问题值得单独记录。同一件商品,商品接口返回的 rating 是 "(5258)",而评论接口在筛选低星后返回的 totalReviews 是 "942"。两个数字的分母不同:前者是该变体页面展示的评价总数,后者是当前筛选条件下的结果数。把两者放进同一列做趋势对比,会得到一条毫无意义的曲线。字段契约表必须为这类聚合字段标注口径,而不只是标注类型。
八、成本与效率:字段级决策的取舍
字段评估最终要回答一个成本问题:你为哪些字段付费,为哪些字段只做低频采集。把所有字段按最高频率采集是浪费,按最低频率采集会让关键决策失准。分层是唯一合理的答案。
交易字段(价格、库存、Buy Box、优惠券)变化最快,且直接驱动业务动作,值得按分钟级轮询。评价聚合字段(评分、评分数)按日采集足够,因为它们的日变化幅度很小。评论内容与规格字段按周采集即可,除非你在跟踪批量评论事件或竞品改版。身份字段一次采集长期复用,无需重复请求。
这个分层直接决定成本结构。以一件商品为单位:分钟级轮询价格意味着每天上千次请求,而规格字段每周一次只有几十次。如果你的场景只需要日级价格,就不该为实时能力付费;如果你在做价格战监控,日级快照会让你在对手调价后的十几个小时里做出错误决策。先定每个字段的容忍延迟,再选采集频率,最后才是比价——顺序反了,比出来的价格没有意义。
字段的获取成本也可以通过接口选择来优化。商品详情类接口通常一次返回数十个字段,单次成本低;而评论、榜单、类目类接口往往按页或按对象计费,单次成本明显更高。设计数据流时,应尽量用商品详情接口承载身份、交易与规格字段,只在需要评论明细时才调用评论接口,并优先用低星筛选提升单条数据的信号密度。按字段需求选择接口,而不是按接口能力堆字段,是控制成本最直接的手段。想系统了解按调用量计费的定价结构,可参考每千条可用记录的成本怎么算。
用可运行的契约测试替代口头约定
字段契约如果不写进测试,就只是文档,而文档不会在字段漂移时报警。下面是三组最小可用的契约测试,覆盖本文实测到的三类陷阱。
import re
import pytest

# ---------- 陷阱一:strikethroughPrice 的 key 语义不稳定 ----------
@pytest.mark.parametrize("payload,expected", [
    ({"key": "List Price",    "value": "$649.00"}, "list_price"),
    ({"key": "Typical price", "value": "$629.95"}, "typical_price"),
])
def test_strikethrough_key_is_classified(payload, expected):
    """两个变体的 key 含义不同,必须分类存储,不可混为一列。"""
    assert classify_strikethrough(payload["key"]) == expected

def classify_strikethrough(key: str) -> str:
    k = key.strip().lower()
    if "list price" in k:
        return "list_price"
    if "typical" in k:
        return "typical_price"
    return "unknown"          # 未知形态须显式暴露

# ---------- 陷阱二:规格文本的写法不统一 ----------
def normalize_resolution(value: str) -> str:
    """2556 × 1179 pixels 与 2556x1179 pixels 归一后必须相等。"""
    v = value.replace("\u00d7", "x").replace("\u00d7", "x")
    v = re.sub(r"\s+", "", v.lower()).replace("pixels", "")
    return v

def test_resolution_writing_variants_are_equal():
    assert normalize_resolution("2556 \u00d7 1179 pixels") == \
           normalize_resolution("2556x1179 pixels")

# ---------- 陷阱三:评论 asin 不等于请求 asin ----------
def test_reviews_are_not_implicitly_filtered(reviews, requested_asin):
    """返回的评论可能全部来自同族其他变体,调用方必须显式过滤。"""
    own = [r for r in reviews if r["asin"] == requested_asin]
    others = [r for r in reviews if r["asin"] != requested_asin]
    assert len(own) + len(others) == len(reviews)
    # 关键断言:不做过滤就回填主商品记录,会污染数据
    if others:
        assert all(r["asin"] != requested_asin for r in others)

# ---------- 填充率监控:上游改版的最早信号 ----------
def test_fill_rate_does_not_regress(products, baseline: dict):
    for field, floor in baseline.items():
        filled = sum(1 for p in products if p.get(field) not in (None, "", []))
        rate = filled / len(products)
        assert rate >= floor, f"{field} 填充率 {rate:.2%} 低于基线 {floor:.2%}"
这三组测试的写法有一处共性:断言的是「归一后的等价」和「显式的未知」,而不是「值等于某个常量」。规格文本、库存文案、折扣基准这些字段的上游写法会变,写死常量会让测试频繁误报,最终被团队忽略。断言归一后的等价关系,则能在写法变化时继续有效,只在语义真的改变时才失败。
九、这套方法在 Pangolinfo 上的落地
本文所有的字段样本来自我们把两件同族商品与一页评论放进同一套契约测试的过程。这些陷阱——标题字段的拆分边界、size 的语义漂移、折扣基准不统一、评论 asin 不等于请求 ASIN——都是在这个过程中被测出来的,而不是从文档里读出来的。这正是我们建议的姿势:不要相信字段名的字面含义,用同一父商品的两个变体跑一次 diff,绝大多数问题会自己浮出来。
Pangolinfo 的 Amazon Scraper API 返回结构化 JSON,商品详情覆盖身份、交易、评价、规格四类字段,支持按指定邮区采集以获取对应地区的价格与配送信息。我们在 30M+/天的调用量下维持 99% 的成功率与约 3 秒的中位延迟,字段填充率作为独立指标监控。对需要评论明细的场景,Amazon Review API 按星级、排序与媒体类型筛选,可以只取低星评论提升信号密度。
接入方式上,如果你在做数据管道而不是一次性取数,建议先看亚马逊数据管道要自建哪几层,把字段契约放在哪一层想清楚。如果你还在评估不同供应商在字段覆盖上的差异,主流亚马逊数据 API 的字段级对比给了同一口径下的横向比较。实现层面,Python 采集示例与Node.js 接入示例里已有可直接运行的代码骨架,字段校验可以接在解析层之后。具体的接口字段定义与返回样例,参考Pangolinfo 开发者文档。
十、从字段契约开始,而不是从接入开始
回到最初的问题:亚马逊商品数据 JSON API 的评估重点不在「能不能拿到」,而在「拿到之后每个字段是否可用」。本文用同一父商品的两个变体与一页评论,拆出了五类需要显式写进契约的事实:标题字段有拆分边界,size 的语义随类目漂移,折扣基准的 key 不稳定,评论的 asin 不等于请求的商品,同一个字段在两个接口里可能有不同格式。
这五条没有一条会引发程序报错,但每一条都会在你上线之后变成错误决策。字段契约表的价值不是文档完备,而是把这些静默缺陷提前变成可执行的断言。落地路径可以很简单:先按四个对象给字段分组,再用同一父商品的两个变体跑一次 schema diff,然后把测出来的每条陷阱写成一个断言接进 CI,最后加上填充率监控作为上游改版的预警。
做完这四步,你的管道对字段的理解就从「键名」升级成了「语义」。这是把数据采集做成可用资产和做成技术债的分界线。
亚马逊商品数据 JSON API 的字段那么多,先建哪些?
先建身份与交易两类的契约。身份字段(asin、parentAsin、title)是所有关联的主键,必须非空;交易字段(价格、库存、配送、卖家)变化最快、空值最多、直接影响业务动作,最需要明确空值语义。评价与规格字段按可选处理,缺失即降级,不做强校验。
同一父商品下不同变体的字段会不一样吗?
会,而且比预期严重。实测同属 parentAsin B0GP8D698X 的两个变体,strikethroughPrice.key 一个是 List Price、一个是 Typical price,attributes 长度分别为 48 与 49,分辨率字段一个用全角乘号一个用小写 x。评估时必须用同一族至少两个变体做 diff,不能只测一个。
评论接口返回的 asin 为什么和我请求的不一样?
因为评论挂在具体变体上,而同一商品族的变体共享评论池并聚合展示。实测请求 B0CMZFCQ6D 返回的 10 条评论分布在 7 个不同 ASIN 上,没有一条等于请求值。需要用变体级评论时必须在拿到结果后按 asin 显式过滤,不能假设返回已筛选。
字段为空的时候应该存 null 还是空字符串?
保留原始形态并附上语义标记,不要预先归一。空串(如 shipper: "")表示本次未取到或该变体不适用,null(如 reviews: null)表示该模块当期不存在。两者信息量不同,混同会让你无法统计字段填充率,也无法在填充率下降时区分采集问题与页面变化。
怎么尽早发现供应商改了返回结构?
两条线并行。一是 schema diff:把字段路径与类型存成基线快照,每次变更后跑一次对比,输出新增、消失与类型变化清单,接进 CI 但只标记待审不阻断发布。二是填充率监控:对采样集统计各字段非空比例,低于历史基线即告警,这是上游批量字段丢失时最早出现的信号。
数据说明:本文所有字段样本于 2026-09-14 通过 Pangolinfo MCP 工具在 amz_us 市场实测采集,样本商品为 parentAsin B0GP8D698X 下的 B0CMZFCQ6D 与 B0CMZ5KBNS,评论样本为 B0CMZFCQ6D 的一页低星评论。字段取值原样引用,未作修改。