
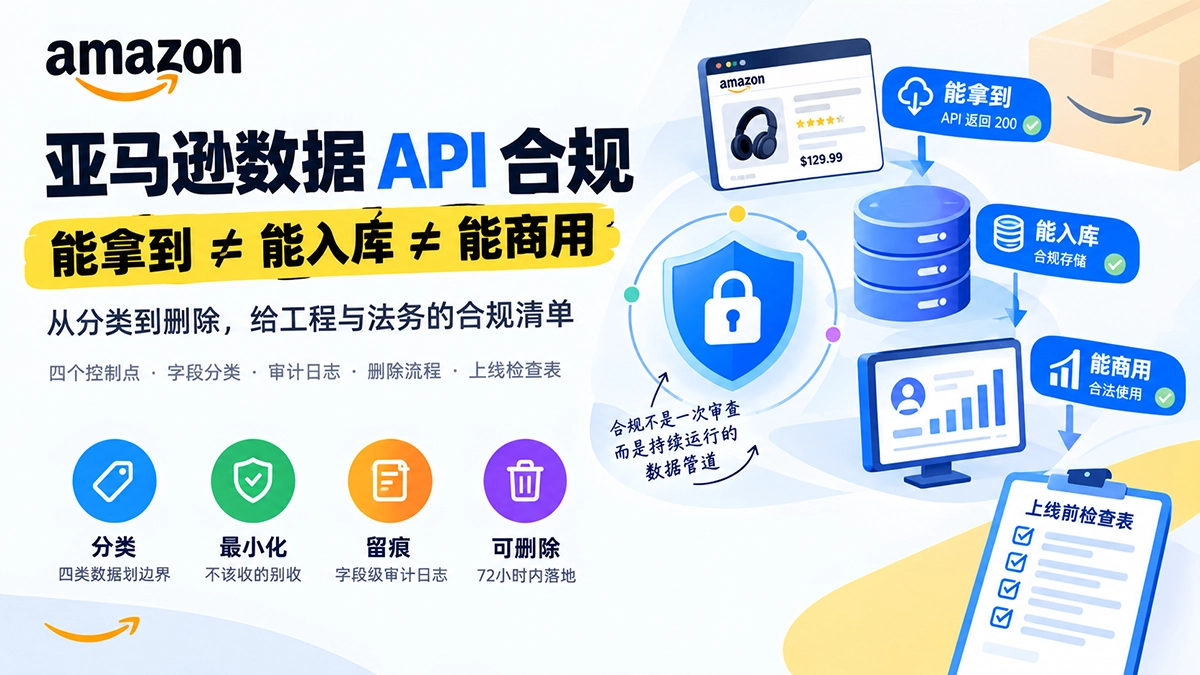
亚马逊数据 API 合规最容易发生的错位,是把「接口返回 200」当成安全信号。接口能返回数据,说明技术通路是通的;这些数据能不能进你的数据库、能不能展示给你的用户、能不能支撑你的商业决策,是三个独立的问题,每一道门都有单独的锁。合规处理不是上线前的一次审查,而是数据管道里持续运行的四个控制点:分类、最小化、留痕、可删除。这篇文章给一份工程与法务共用的清单——按四类数据划边界、给出审计日志的字段设计、删除流程的时限要求、以及一份上线前逐项打勾的检查表。它不提供法律结论,遇到具体裁决请找律师;它提供的是让律师问询来临时你能拿出证据的工程基础。
一、三个问题,三把锁:亚马逊数据 API 合规重点是什么?
把合规问题混在一起谈,是团队行动不起来的常见原因。拆开看,任何一次数据接入都要依次回答三个问题:能不能拿(获取侧)、能不能存(存储侧)、能不能用(使用侧)。三个问题的答案互不包含。
能不能拿,看的是获取方式:对方有没有公开这个数据、你的采集行为是否遵守其服务条款与 robots 协议、有没有绕过登录墙或验证码。能不能存,看的是数据本身的属性:价格是公开事实,存下来风险低;买家署名是个人数据,存下来就落入数据保护法的管辖;商品图片是受版权保护的内容,存储行为本身在多数法域属于复制。能不能用,看的是使用场景:内部价格分析、对外展示、训练模型、二次分发,四者的合规水位各不相同——同一张图片,内部比对没问题,放到你的前端页面上就是另一个问题。
错位最典型的形态是:工程团队拿到 API key,跑通请求,把全部返回原样落库,然后进入下一个需求。直到法务或客户提出问询,才发现数据库里混着不该长期保留的个人数据,而没人说得清哪些字段来自哪次采集。合规失败的形态通常不是「被抓」,而是「被问到时拿不出答案」。这份清单要解决的就是后者。
还有一个定位要说清楚:这份清单以「经 API 获取公开数据」为场景。它覆盖的是你通过正规数据服务接口拿到数据之后的处理责任,不覆盖你自己写爬虫去绕反爬的场景——那是另一个风险量级的话题,本文不展开。用正规的数据采集接口(例如 Amazon Scraper API)(文档)意味着获取侧的主要责任已经由供应商承担了一部分,但存储侧与使用侧的责任不随接口转移,它们全程在你手里。
二、先分类:四类数据,四种法律属性
合规动作的第一步不是读法条,是把返回里的每个字段按属性分类。亚马逊商品数据的字段可以分成四类,每类的处理规则不同。下表是分类基准,建议直接抄进你团队的字段词典。
| 类别 | 典型字段 | 法律属性 | 核心动作 | 风险等级 |
|---|---|---|---|---|
| 公开事实类 | price、inStock、star、ratingDistribution、seller 名称 | 事实信息,无独立版权 | 可入库、可分析;保留采集时间与来源 | 低 |
| 受版权内容类 | images、productDescription、features、评论文本正文 | 受版权保护的表达 | 默认存引用与摘要;展示需授权或链接回源 | 中 |
| 个人数据类 | 评论者昵称与头像、评论者主页链接、卖家联系方式 | 个人数据(GDPR / CCPA 管辖) | 默认不落库;确需使用时脱敏并记录依据 | 高 |
| 平台生成数据类 | BSR 排名、Amazon’s Choice 徽章、coupon 活动标识 | 平台商业标识与动态结果 | 标注采集时间戳;不用于暗示官方背书 | 中 |
这张表有三个使用要点。第一,分类的对象是字段,不是接口——同一个评论接口的返回里,评分分布是公开事实类,评论正文是受版权内容类,评论者昵称是个人数据类,必须拆开处理。第二,分类要落进 schema,而不是落进会议纪要:给每个字段打上 data_class 标签,后续的保留策略、脱敏规则、审计范围全部以这个标签为依据驱动。第三,分类表要有版本,亚马逊改版导致字段增减时(这类事情每个季度都会发生),分类表跟着走版本,审计时才对得上。
以我们自己的字段词典为例,标签直接挂在字段契约上:
// 字段词典中的合规分类标签(YAML 片段)
fields:
  price:
    data_class: public_fact      # 公开事实类
    retention: 24m               # 保留 24 个月
  images:
    data_class: copyrighted      # 受版权内容类
    retention: 7d                # 只存 7 天引用,源图不落库
    display: "reference_only"    # 仅引用,不对外展示
  reviews:
    data_class: copyrighted      # 评论文本本体
    retention: 12m
  reviewer_name:
    data_class: personal         # 个人数据类
    retention: 0d                # 默认不落库
    transform: drop              # 采集后立即丢弃,不经过存储层
  bsr:
    data_class: platform_metric  # 平台生成数据类
    retention: 24m
    display: "with_timestamp"    # 展示必须带采集时间戳
下面四节按四类数据逐个展开处理动作。
三、公开事实类:低风险不等于零动作
价格、库存状态、评分分布属于事实信息——「这件商品现在卖 129 美元」这件事没有人拥有版权,你采集、存储、分析它,在多数法域风险等级低。但低风险不等于零动作,事实类数据有它自己的三个合规要点。
第一是时效标注。价格分钟级波动,你存下来的每一个价格都只代表采集时刻的状态。没有时间戳的价格数据不只是质量问题(字段契约怎么建是另一篇文章的主题),也是合规问题:把过期价格当成现价展示给用户,可能构成误导。数据的新旧本身也是需要独立测量的属性,三时钟模型怎么测是另一个话题。事实类数据的最低要求是每一行都带 captured_at,展示侧强制带「价格采集于 X 时 X 分」。
第二是来源可溯。每一条事实数据要能回答「从哪个市场、哪个接口、哪次任务拿到的」。这不只是为了排障——当你的分析结论被客户或监管质疑时,来源链是你自证数据质量的第一证据。来源字段建议固定为四元组:(marketplace, asin, task_id, captured_at)。
第三是诚信采集。事实类数据的获取侧仍有红线:不伪造身份、不绕登录墙、不重放验证码。如果你的数据供应商在这上面出问题,风险会传导给你——你无法通过「数据是买的」来切割责任。选型时值得直接问供应商两个问题:采集是否基于公开页面、是否有公开的采集质量与覆盖率报告。以我们为例,Pangolinfo 的 SP 广告位采集率在 13 个市场公开可查,整体 91.4%——供应商敢把这类数字放到公开页面上,本身就是一种可审计的姿态。
四、受版权内容类:能抓取不等于能再分发
商品图片、A+ 页面内容、卖点文案、评论正文,都受版权保护。通过 API 拿到它们是获取问题;拿到之后你怎么用,是版权问题。核心原则一句话:存引用,不存本体;做分析,不做再分发。
图片是最常见的踩雷区。把商品图下载到你自己的服务器,再展示在你的页面上,构成对版权作品的复制与传播——即使你注明了来源,也不构成免责。合规的处理方式有两种:一是只存图片 URL,前端展示时直接引用源站地址(接受图片链接失效的风险,用定期校验任务兜底);二是确需存储的场景(比如做历史价格与历史主图对照),把存储范围压到缩略图并记录使用依据。选数据供应商时也要注意同一件事:正规服务返回的图片字段是 URL 引用而非转存后的二进制,这个细节值得写进选型标准。
评论文本的边界更细。把评论正文用于统计分析——情感分布、关键词频次、差评归因——属于对事实与观点的处理,风险低;把评论原文整段搬运到你的产品页做营销展示,就是在复制受版权内容,而且评论者的署名还牵出个人数据问题(下一节展开)。中间地带是「引用片段」:少量、注明出处、服务于你自己的分析结论,这是普遍接受的用法。Amazon Review API 这类按星级与媒体类型筛选的接口,主要价值正在分析侧——取数是为了算信号,不是为了搬内容。
卖点文案与商品描述同样按此处理。做竞品卖点对比时,把 features 数组拆成要点做结构化比较,是分析;把对手的 A+ 文案原文贴进你的选品报告对外发送,就越界了。一个实用的判断标准:你的产出物里,受版权内容的占比越高、替代性越强(用户看完你的引用就不用去看原页面),风险越高。
五、个人数据类:最小化原则怎么落地
评论者昵称、头像、主页链接,卖家登记的联系方式,属于个人数据。只要你面向欧盟用户运营(GDPR)或服务加州居民(CCPA),这批数据一落库,你就成了数据控制者,要承担告知、目的限定、可删除等一整套义务。对多数数据团队来说,最经济的合规策略不是建立这套义务体系,而是从一开始就不采集、不落库——数据最小化原则最不留余地的执行方式是让数据不进入你的系统。
落地分三步。第一步是默认丢弃:采集管道在入口处把个人数据类字段直接 drop,不写入任何存储层,包括日志。很多团队的泄漏不发生在数据库,发生在调试日志——把整个返回体打进了应用日志,日志又同步到了第三方观测平台。第二步是确需使用时的替代设计:如果你的场景确实需要区分「同一评论者的多条评论」,用单向哈希替代明文昵称;需要展示评论者身份时,展示聚合结果(「某用户提供」)而非明文。第三步是记录依据:任何一条个人数据被有意保留,都要有对应的业务目的、法律依据、保留期限三行记录,挂在数据目录里可查。
卖家信息值得单独说。卖家店铺名是公开事实类,可以入库;卖家登记的邮箱、电话、地址是个人数据类,即便接口返回了也应该丢弃。做卖家分析的正确姿势是用店铺名做聚合维度,联系卖家走平台自带的站内信通道。
六、平台生成数据类:时效性也是合规问题
BSR 排名、Amazon’s Choice 徽章、活动标识(coupon、Deal)是亚马逊计算并展示的动态结果。它们不属于任何第三方,但使用时有两个特有约束。
一是时效绑定的展示义务。BSR 小时级变动,你今天拿到的排名只对今天成立。用 BSR 做宣传素材(「类目第一名的产品」)而不带采集时间,一旦排名下滑,这句话就从事实变成了误导。平台生成数据的展示规则因此要写死在代码里:任何 BSR 与徽章的渲染,模板强制拼接 captured_at,没有时间戳的数据不允许出报表。
二是不构成背书的边界。Amazon’s Choice 徽章是平台算法在特定时刻的结果,把它放进你的营销物料暗示「亚马逊推荐了我们的产品」,可能牵出商标与虚假宣传问题。内部决策用这些数据没有问题——它们本来就是为你做选品与竞品判断服务的;对外的边界是只陈述事实(「该商品于 X 日获得某徽章」),不制造关联(「亚马逊认可我们的品牌」)。
七、访问控制与审计日志:出了问询,你拿什么自证
前五节解决「怎么处理数据」,这一节解决「怎么证明你这么处理了」。审计能力的载体是审计日志,而审计日志的设计要前置——出事之后补记的日志没有证明力。
先说访问控制的三条底线。API key 不进代码库(用密钥管理服务或环境变量注入);数据访问按角色收敛(分析角色不需要触碰原始返回,只需要触碰清洗后的表);任何对个人数据类字段的例外访问都要走审批并留痕。这三条是通用安全实践,放在这里是因为它们同时是合规证据链的入口——没有访问控制,你的审计日志无法回答「谁在什么时候动了这批数据」。
审计日志的字段设计,核心是把「数据事件」记录到字段级。下面是我们生产在用的最小字段集:
{
  "event_id": "aud_20260916_e3f1c8",
  "event_time": "2026-09-16T09:14:22+00:00",
  "event_type": "acquire",          // acquire | store | access | transform | delete
  "actor": "svc://ingest-worker-07",  // 服务账号或用户 ID
  "source": {
    "provider": "pangolinfo",
    "endpoint": "product_detail",
    "marketplace": "US",
    "task_id": "tsk_884213"
  },
  "subject": {
    "asin": "B0CMZFCQ6D",
    "fields": ["price", "inStock", "ratingDistribution"],
    "data_classes": ["public_fact"]   // 本次触达数据的最高敏感级
  },
  "policy_version": "v2026.3",        // 依据的分类表版本
  "retention_until": "2028-09-16",    // 该批数据的到期时间
  "checksum": "sha256:9f2a..."       // 返回体摘要,用于证明日志与数据对应
}
五个设计要点。event_type 覆盖数据生命周期五类事件,缺一类就存在审计盲区;data_classes 记录「本次事件触达数据的最高敏感级」,让你能用一句话回答「个人数据有没有进过你的系统」;policy_version 把日志与分类表版本绑定,规则改了,历史行为仍按当时的规则评价;retention_until 让删除任务有了机器可读的依据;checksum 把日志与原始数据对应起来,防止「日志说有、库里说无」的罗生门。日志本身只追加、不修改,访问日志的日志同样要留。
八、保留与删除策略:删除请求要在 72 小时内走到数据层
保留策略回答「数据存多久」,删除策略回答「要删的时候多快删得掉」。两个策略都要预先定义,并且要能被执行,而不是停留在政策文档里;这些动作落在数据管道的哪一层,管道分层设计一文有展开。
保留期限按数据分类逐类设定:公开事实类可以长(我们定 24 个月,支撑跨年度价格分析);受版权内容类的本体尽量短(图片引用 7 天校验一次);个人数据类默认 0(入口即丢)。期限写进字段词典(见第二节的 retention 标签),由定时任务扫描执行,到期数据自动进入删除队列。
删除流程要区分两种触发。第一种是到期触发,机器可判断,全自动执行。第二种是请求触发——评论者要求删除其评论相关数据、监管问询要求提供或删除特定数据——这类请求要有时限承诺。我们的内部标准是 72 小时内把删除动作落到数据层,并出具删除凭证:
# 删除任务的执行脚本骨架(要点版)
def handle_deletion_request(req):
    # 1. 定位:按请求给出的标识(昵称哈希 / ASIN / 任务号)扫全量存储
    targets = locate(req.identifier, include=["db", "warehouse", "cache", "backup", "logs"])
    assert targets, "未命中任何存储层时也要记录一次空删除"

    # 2. 执行:按存储层逐一删除,备份层标记墓碑而非物理覆写(按备份策略周期清理)
    for t in targets:
        t.delete_or_tombstone()

    # 3. 凭证:出具删除回执,写审计日志
    receipt = {
        "request_id": req.id,
        "completed_at": now(),
        "layers_purged": [t.name for t in targets],
        "verified_by": "second_scanner_pass",   # 独立二次扫描确认无残留
    }
    audit_log.write(event_type="delete", payload=receipt)
    return receipt  # 72 小时内回执给请求方
两个容易漏的细节。一是衍生数据:原始数据删除后,由它聚合出的报表、缓存、模型特征要不要跟着删?规则要预先写明——聚合统计因为不再指向个人,通常可以保留;但请求方明确要求全链路删除时,衍生层也要进目标清单。二是备份与只追加存储:备份里删不掉的,用墓碑标记加周期清理;审计日志本身不删(它是你自证删过的证据),但要在其中记录删除事件本身。
九、上线审查清单:工程 12 项 + 法务 6 项
最后把前面八个控制点收拢成一份上线前逐项打勾的清单。工程项与法务项分开列,签字人不同,但共用同一份证据底座——分类表、审计日志、删除凭证。
工程项(12 项,由技术负责人签署):
- 返回的每个字段都已按四类分类,
data_class标签落进字段词典; - 个人数据类字段在采集入口处默认丢弃,丢弃动作有日志;
- 调试日志不落完整返回体(抽查最近 1000 行日志确认);
- 受版权内容类字段默认存引用不存本体,展示侧走引用渲染;
- 每条事实数据带
captured_at与四元组来源标识; - 展示模板强制拼接时间戳,无时间戳数据不出报表;
- 审计日志覆盖五类事件,字段集完整,只追加不可改;
- 保留期限逐类配置,到期删除任务在跑且有执行记录;
- 删除请求流程演练过一次,72 小时时限、删除凭证、二次扫描都有产出;
- API key 无一硬编码,访问按角色收敛,例外访问有审批流;
- 分类表带版本号,供应商改版后的字段变更处理流程有责任人;
- 数据供应商的采集方式、覆盖率报告已归档备查。
法务项(6 项,由法务或合规负责人签署):
- 数据用途清单已书面化(内部分析 / 对外展示 / 模型训练逐项列明);
- 面向的法域已确认(是否触达欧盟、加州用户),对应义务已评估;
- 评论文本与图片的使用方式在版权边界内(引用比例、注出处、不再分发);
- 平台生成数据的使用不构成官方背书暗示;
- 个人数据的例外的场景(如有)具备目的、依据、期限三要素记录;
- 供应商协议中数据来源合法性条款已审阅,责任划分清楚。
这份清单的用法不是一次通过就归档——分类表版本变更、供应商接口改版、新增法域市场,任何一个触发条件出现都要重跑。把重跑条件也写进流程,清单才是活的。
十、结语与常见问题
回到开头的判断:能拿到 ≠ 能入库 ≠ 能商用。获取侧的责任可以通过选择正规数据服务分出去一部分,存储侧与使用侧的责任留在你自己手里,而且全程需要证据支撑。四个控制点——分类、最小化、留痕、可删除——没有一个是法务专属动作,全部可以落进工程实现;反过来说,等问询来了才补的文档,证明力会打折扣。把清单跑起来,让每一批数据从进系统的第一天起就带着自己的合规身份。
常见问题
用正规数据 API 拿数据,合规责任就归供应商了吗?
不是。供应商承担获取侧的主要责任(采集方式、robots、反爬边界),但存储侧与使用侧的责任不随接口转移:数据进了你的系统,最小化、保留、删除、审计就是你的义务。选一家采集方式干净的供应商能降低上游风险,不能豁免下游责任。
亚马逊商品数据里哪些字段属于个人数据?
主要是评论者身份信息(昵称、头像、主页链接)与卖家登记的联系方式。商品本身的价格、库存、评分分布、BSR 都是事实或平台数据,不属于个人数据。判断标准是能否直接或间接指向一个自然人。
商品图片和评论文本能存吗?
分开看。图片默认存 URL 引用不存本体,确需存储的压到缩略图并记录依据;评论文本用于统计分析风险低,整段搬运到对外产品页风险高。共同原则:做分析不做再分发,存引用不存本体。
审计日志最少要记哪些字段?
最小字段集是七个:事件 ID、事件时间、事件类型(获取/入库/访问/转换/删除五类)、操作者、数据来源(供应商、接口、市场、任务号)、触达字段及其数据分类、保留到期时间。再加一个返回体校验和,把日志与数据对应起来。
删除请求来了要多快响应,删到什么程度?
建议对内承诺 72 小时内落到数据层并出具删除凭证。范围要覆盖数据库、数仓、缓存、日志,备份层用墓碑标记加周期清理;衍生聚合数据通常可保留(不再指向个人),但请求方要求全链路删除时要一并处理。审计日志本身不删,记录删除事件正是它存在的目的之一。