
系列导航:本篇是“亚马逊选品 AI 自动化验证” 4 篇系列的第 2 篇(A2),配套总览详见支柱页 亚马逊利基发现与 AI 选品工作流指南;第 1 篇 A1 亚马逊选品工作流模板与 28 列核验表(2026-11-07 已发布);第 3 篇 A3 亚马逊选品验证打分卡与一票否决模型 与第 4 篇 A4 亚马逊选品研究中文提示词包(即将发布)。
实测 lick mat for dogs 得分 31/100,触发 4 个 Kill Switch,结论为 CAUTION 偏向 STOP,不建议立项投入。
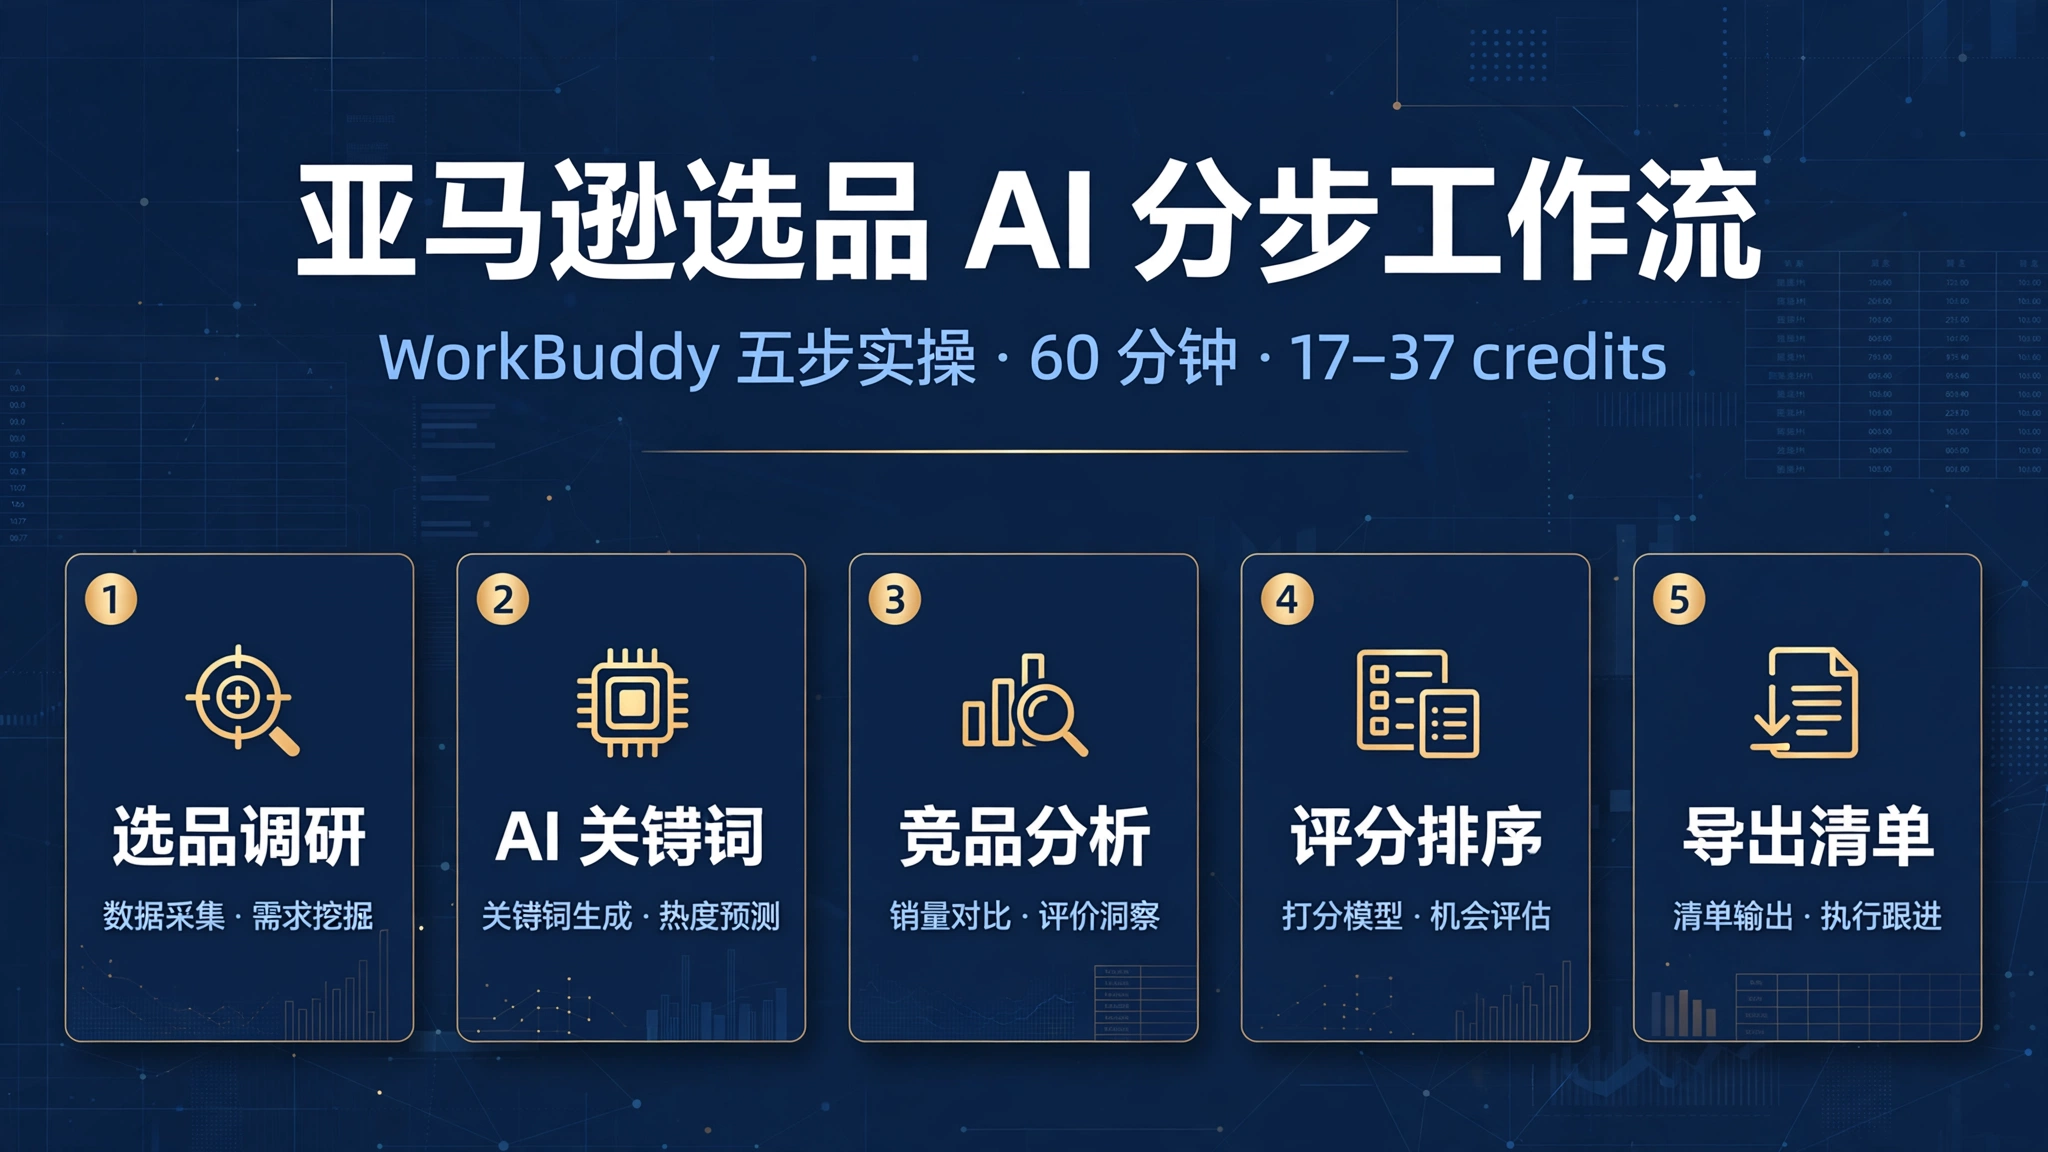
借助 WorkBuddy 挂载 Amazon Data MCP,卖家可在 60 分钟、17 至 37 credits 内跑完五步亚马逊选品 AI 工作流,直接穿透实时 SERP 与差评完成一票否决裁定。
传统选品流程中,运营人员往往需要在多个浏览器插件、第三方历史词库与 Excel 表格之间反复横跳。历史快照的滞后性与手工复制粘贴的低效,导致单次细分市场(Niche)验证动辄耗时半天,且极易在广告位膨胀、头部品牌垄断或新品存活率归零等盲区上产生误判。在第 1 篇 A1(亚马逊选品工作流模板与 28 列核验表,即将发布)中,我们已经确立了标准化的数据采集字段、28 列核验表结构、5 个一票否决(Kill Switch)速查标准以及 13 点上线前核对清单。本篇 A2 不再重复印制上述静态表格,而是聚焦工程落地:如何在桌面端 AI 助手 WorkBuddy 中通过模型上下文协议(MCP)直连底层数据接口,用结构化中文提示词驱动五步自动化实操,并完整还原 lick mat for dogs(狗狗舔食垫)利基从数据拉取到最终裁定的真实返回结果。
1. 五步总览与 60 分钟时间盒
一套可复用的亚马逊选品 AI 工作流,核心在于将发散的市场调研收敛为严格受控的“时间盒(Time-box)”与“算力预算盒(Credit-box)”。在 WorkBuddy 环境中接入 Amazon Data MCP 后,AI Agent 不再依赖过时的预训练语料猜想市场规模,而是直接调用底层 21 个可用工具,按需拉取商机探测器快照、实时搜索结果页(SERP)、产品详情页(PDP)以及消费者声音(VOC)数据。底层网络保持 99.9% 的请求成功率,并对搜索结果页具备 90% 以上的赞助位(Sponsored)识别率,从而保证输入打分卡的每一个字段都具备实时可审计性。
在正式启动 60 分钟计时前,需在 WorkBuddy 的 MCP 配置文件中完成远程服务端点挂载。完整环境准备与客户端调试流程可参考 WorkBuddy 亚马逊数据技能配置指南,核心配置代码块如下(请将占位符替换为你自己的 API 密钥,切勿在公开仓库或共享提示词中硬编码真实密钥):
{
  "mcpServers": {
    "pangolinfo-amazon-data": {
      "url": "https://mcp.pangolinfo.com/mcp",
      "headers": {
        "Authorization": "Bearer <YOUR_PANGOLINFO_API_KEY>"
      }
    }
  }
}
配置生效后,WorkBuddy 即可识别并调度 Pangolinfo 提供的 21 个工具集。为了防止选品团队在单一利基上陷入无限度的“数据深挖瘫痪”,本工作流将单次完整利基验证严格锁定在 60 分钟时间盒 内,并将 API 资源消耗控制在 17 至 37 credits 之间。Pangolinfo 提供每月 60 credits 的免费套餐(无需绑定信用卡),这意味着即便是零成本起步的个人卖家或小型测试团队,每月也能利用免费额度完整跑通 1 至 3 个细分市场的深度核验。
以下是五步自动化实操的时间盒分配、底层调用工具与计费预算拆解:
- 第一步:宏观利基拉取(时间盒:10 分钟|预算:10 credits)
调用 Niche Data API 对应的 MCP 筛选工具(10 credits/次),拉取目标利基的搜索量趋势、Top-5 产品与品牌点击份额、平均评论数、平均价格、退货率以及近 90 天/360 天新品存活数据,完成 A1 28 列核验表中宏观需求与垄断度字段的自动填充。 - 第二步:实时 SERP 核验(时间盒:12 分钟|预算:2 credits)
调用 Scraper API 对应的搜索结果抓取工具(1 credit/页),实时抓取主搜词前 2 页(约 60 行结果),分离自然位(Organic)与赞助位(Sponsored),校验真实首页中位价格、前排评论墙高度与广告挤占程度,弥补历史快照的时间差。 - 第三步:头部 PDP 穿透(时间盒:13 分钟|预算:5 credits)
锁定实时 SERP 中的第 1 自然位及核心竞品(抽取 5 个代表性 ASIN,合计 5 credits,按 1 credit/页计费),穿透抓取实时 PDP,提取精确类目 BSR 排名、月销估算标签、变体结构及页面内嵌的 AI 评论摘要矩阵。 - 第四步:VOC 差评挖掘(时间盒:15 分钟|预算:0–20 credits)
针对核心标杆 ASIN 拆解 1–3 星差评高频痛点。常规路径调用 Reviews API(5 credits/页,抓取 1–4 页即 5–20 credits);当遇到目标站点评论端点限流或返回空集时,立即启动零额外成本的降级方案,直接解析第三步实时 PDP 中已获取的aiReviewsSummary情感极性矩阵(额外消耗 0 credits),提炼材质缺陷与结构改款方向。 - 第五步:打分与一票否决裁定(时间盒:10 分钟|预算:0 credits)
汇总前四步的结构化 JSON 输出,在 WorkBuddy 内按 A1 与 A3(亚马逊选品验证打分卡与一票否决模型,即将发布)定义的本模板建议口径权重进行百制打分,并逐一比对 5 个 Kill Switch 阈值,输出最终 GO / CAUTION / STOP 裁定报告。
通过这一 60 分钟时间盒设计,选品决策从“凭感觉看图”转变为标准化流水线。下面我们以 lick mat for dogs(狗狗舔食垫)为唯一样本,完整还原五步实操的提示词指令与真实返回数据。
2. 第一步:宏观利基拉取
目标
在最初的 10 分钟内,通过一次接口调用获取 lick mat for dogs 利基的全局供需面貌。核心任务是摸清该细分市场在过去 90 天与 360 天的搜索量增速、价格带宽、品牌集中度、卖家数量、平均评论壁垒、退货率以及新品上新存活率,将返回结果直接映射至 A1 28 列核验表的宏观盘面列,并对前向一票否决项(如品牌垄断度与新品存活率)做出初步预警。
工具与中文提示词
本步骤在 WorkBuddy 中调用 Amazon Data MCP 内置的商机利基检索工具(底层对应 Niche Data API)。无需编写 Python 解析脚本,直接在 WorkBuddy 输入框中下发如下结构化中文提示词(后续全套多场景提示词模板将收录于第 4 篇 A4 亚马逊选品研究中文提示词包,即将发布):
请调用 pangolinfo-amazon-data MCP 中的利基数据查询工具(Niche Filter API),站点设为美国站(US),检索目标利基关键词 "lick mat for dogs"。
请提取并按结构化列表输出以下核心字段(注明数据快照日期):
1. 搜索量与趋势:近 90 天搜索量(searchVolumeT90)及环比变化率、近 360 天搜索量(searchVolumeT360)及同比变化率;
2. 价格区间:利基最低价、最高价与平均价格(均价);
3. 竞争与流量分布:利基内统计产品数、赞助广告占比(Sponsored %)、Top-5 产品点击份额、Top-5 品牌点击份额、品牌总数、卖家总数;
4. 列表壁垒与质量指标:平均 BSR、平均评论数、平均星级评分、近 360 天退货率(returnRateT360);
5. 上新存活指标:近 360 天新品发布数量(T360 新品)、近 90 天成功上新数量(T90 成功上新)。
最后,请根据本模板建议口径的 Kill Switch 阈值,标注目前已触发红线的指标。
真实返回数据摘要
WorkBuddy 调度 MCP 端点 https://mcp.pangolinfo.com/mcp 后,成功返回 lick mat for dogs 的利基快照数据(Niche API 快照日期:2026-08-02)。返回核心指标与 JSON 摘要结构如下:
{
  "nicheKeyword": "lick mat for dogs",
  "snapshotDate": "2026-08-02",
  "demandMetrics": {
    "searchVolumeT90": 463314,
    "searchVolumeGrowthT90": "+2.8%",
    "searchVolumeT360": 1742644,
    "searchVolumeGrowthT360": "+145.9%"
  },
  "pricingMetrics": {
    "minPrice": 4.40,
    "maxPrice": 21.20,
    "avgPrice": 8.87,
    "currency": "USD"
  },
  "competitionMetrics": {
    "productCount": 20,
    "sponsoredShare": "95%",
    "top5ProductsClickShare": "58.3%",
    "top5BrandsClickShare": "76.4%",
    "brandCount": 13,
    "sellerCount": 37
  },
  "barrierAndQualityMetrics": {
    "avgBSR": 33.87,
    "avgReviews": 2227.1,
    "avgRating": 4.455,
    "returnRateT360": "1.52%"
  },
  "launchMetrics": {
    "newProductsT360": 6,
    "successfulLaunchesT90": 0
  }
}
从这组真实返回数据中,选品研究员在 10 分钟内即可读出极为关键的矛盾信号:
第一,需求端极具诱惑力。该利基近 360 天搜索量高达 1,742,644,同比暴涨 +145.9%;近 90 天搜索量达 463,314,保持 +2.8% 的稳态增长,且近 360 天退货率(returnRateT360)仅为 1.52%,远低于本模板建议口径的 8% 退货红线。如果仅看需求与售后指标,这是一个极易让新手盲目立项的“爆款词”。
第二,供给端与流量分配已呈极端闭环。利基统计的 20 个核心产品分布在 13 个品牌、37 个卖家手中,Top-5 产品切走了 58.3% 的点击份额,而 Top-5 品牌点击份额更是高达 76.4%。与此同时,平均评论数达到 2,227.1 条,平均评分 4.455 星,平均 BSR 为 33.87。
第三,上新通道完全冻结。过去 360 天内仅有 6 个新品尝试进入,而 近 90 天成功上新数(T90 成功上新)为 0 个。叠加高达 95% 的赞助占比 与 $8.87 的均价(价格带 $4.40–$21.20),宏观快照在第一步就已经拉响了多处警报。
耗时与 credits
- 实操耗时:约 10 分钟(含提示词输入、JSON 字段核对及填入 A1 28 列核验表对应列)。
- Credits 消耗:调用 Niche Filter API 1 次,标准计费为 10 credits。
常见坑与检查点
- 混淆快照周期与实时盘面:Niche API 返回的是聚合周期快照(如本例快照日期为 2026-08-02),用于评估 T90/T360 宏观趋势与点击份额极为精准,但不能替代当天的首页实时排位。必须进入第二步实时 SERP 核验来交叉验证。
- 严禁跨类目横向硬比平均 BSR:返回数据中的平均 BSR 33.87 仅代表该利基核心样本在各自所属节点下的排名均值。不同一级或二级类目的 BSR 含金量差异极大,切勿拿宠物用品(Pet Supplies)的 BSR 均值与家居或电子类目直接对比。
- 检查点:确认
top5BrandsClickShare(76.4%)、successfulLaunchesT90(0)、avgReviews(2,227.1)、sponsoredShare(95%)与avgPrice($8.87)五个核心字段已完整记录,准备进入实时页面核验。
3. 第二步:实时 SERP 核验
目标
在接下来的 12 分钟内,针对主搜词 dog lick mat 发起实时搜索结果页(SERP)抓取。宏观利基快照反映了历史周期的聚合态,而实时 SERP 决定了新品上架第一天面临的真实竞价环境。本步目标是获取最新鲜的前排样本,清点自然位与赞助位的精确比例,测定首页自然位价格区间与中位价,并核实自然位前 10 名的评论数分布(即“评论墙”厚度)。
工具与中文提示词
在 WorkBuddy 中调用 Amazon Data MCP 的实时搜索抓取工具(底层对应 Scraper API 的 SERP 端点,具备 90% 以上的赞助位识别率)。在当前会话中继续输入以下中文提示词:
请调用 pangolinfo-amazon-data MCP 中的亚马逊搜索结果抓取工具(SERP Scraper),站点设为美国站(US),实时抓取关键词 "dog lick mat" 的前 2 页搜索结果。
请对返回结果进行结构化清洗并输出:
1. 样本总数:总返回行数、自然位(Organic)行数、赞助位(Sponsored)行数,以及首页最顶部前 4 个位置的广告属性;
2. 榜首标杆:第 1 自然位产品的品牌、ASIN、当前售价、星级评分、评论总数、月度销量标签及徽章(Badge);
3. 自然位价格分布:所有自然位产品的最低价、最高价与中位价(Median Price);
4. 自然位前 10 名评论墙序列:按自然排名第 1 至第 10 位的顺序列出各自的评论数(若为刚上架无评论新品请标注 new)。
真实返回数据摘要
2026-11-06 实测调用后,WorkBuddy 实时解析并返回了 60 行搜索结果数据。核心统计与前排分布摘要如下:
{
  "searchKeyword": "dog lick mat",
  "testDate": "2026-11-06",
  "serpComposition": {
    "totalRows": 60,
    "organicRows": 48,
    "sponsoredRows": 12,
    "top4Positions": "All Sponsored (前 4 位均为赞助广告)"
  },
  "rank1OrganicBenchmark": {
    "brand": "LUKITO",
    "asin": "B09FPTDBRZ",
    "price": 8.99,
    "rating": 4.4,
    "reviewsCount": 8783,
    "monthlySalesTag": "6K+/月",
    "badge": "Overall Pick"
  },
  "organicPricing": {
    "minPrice": 3.99,
    "maxPrice": 28.49,
    "medianPrice": 9.99,
    "currency": "USD"
  },
  "top10OrganicReviewsSequence": [
    8783,
    2792,
    2792,
    1302,
    2792,
    236,
    "new",
    784,
    31,
    1105
  ]
}
通过对 2026-11-06 实时 SERP 数据的拆解,我们可以验证第一步宏观快照在当前时间截面上的具体投射:
* 首屏流量拦截:在抓取的 60 行结果中,包含 48 个自然位与 12 个赞助位;尤为关键的是,搜索结果最顶部的黄金前 4 位全部为赞助位(Sponsored)。买家搜索 dog lick mat 时,第一眼看到的完全是付费广告位。
* 头部标杆统治力:排在第 1 自然位的是品牌 LUKITO(ASIN:B09FPTDBRZ),单价仅 $8.99,拥有 4.4 星 与高达 8,783 条评论,月销标签显示 6K+/月,并牢牢占据亚马逊 Overall Pick 徽章。
* 低价挤压空间:全部 48 个自然位产品的价格区间跨度为 $3.99–$28.49,但 自然位中位价仅为 $9.99(与第一步宏观快照均价 $8.87 高度吻合,均处于 $12 以下的超低客单价区间)。
* 前排评论墙(Review Wall)实况:自然位前 10 名的评论数依次为 8,783 / 2,792 / 2,792 / 1,302 / 2,792 / 236 / new / 784 / 31 / 1,105。可以看到,自然位前 5 名的评论数全部在 1,300 条以上(最低 1,302 条,最高 8,783 条),远超本模板建议口径中“自然前 5 均 >500 条”的封锁线。虽然第 6 至第 10 位出现了 236 条、new(新品)、31 条等较低评论链接,但受制于前 4 广告位与前 5 自然巨头的双重截流,后排链接极难分得有效自然点击。
耗时与 credits
- 实操耗时:约 12 分钟(含实时抓取等待、Sponsored 标签分离核验、中位价计算及前 10 评论序列登记)。
- Credits 消耗:调用 Scraper API 抓取 SERP 2 页(1 credit/页),共消耗 2 credits(累计消耗 12 credits)。
常见坑与检查点
- 把广告位当成自然位计算评论墙:普通网页爬虫若缺乏高精度的 Sponsored 识别能力,容易将前 4 位付费广告混入自然排名前 5 名,从而误判自然晋升难度。Pangolinfo 90% 以上的赞助位识别率在此处起到了关键过滤作用。
- 用算术平均价代替中位价:SERP 中偶尔会出现高价礼品装或大套装(如本例最高价 $28.49),容易拉高算术均值。实操中务必让 WorkBuddy 同时输出自然位中位价(本例 $9.99),以客观反映主流成交水位。
- 检查点:确认已锁定当前有效的第 1 自然位核心标杆 ASIN(
B09FPTDBRZ),并完成自然前 5 评论数是否全部大于 500 的核对。
4. 第三步:头部 PDP 穿透
目标
在 13 分钟时间盒内,从搜索列表页深入到单品详情页(PDP)。本步骤的核心目标是验证头部标杆 ASIN 的存续状态,提取大类目与细分类目 BSR 排名、评分分布基数,并预先抽取页面内置的 AI 评论摘要(aiReviewsSummary)结构,为第四步的差评痛点分析打下数据底座。
工具与中文提示词
在实操验证过程中,我们遇到了一个非常典型的动态选品异常:原始历史样本库中记录的标杆 ASIN B0B178VDQQ 在本次实测中已失效,接口返回 [ASIN_UNAVAILABLE]。这恰恰证明了依赖静态表格选品的危险性——历史链接随时可能因为变体合并、合规下架或库存断货而消失。因此,我们立即在 WorkBuddy 中依据第二步实时 SERP 的结果,将穿透主标杆切换为当前第 1 自然位 LUKITO B09FPTDBRZ(并在标准流程中同步抽检其余 4 个前排竞品,合计 5 个 PDP 页)。
在 WorkBuddy 中输入以下中文提示词:
原始样本 ASIN B0B178VDQQ 经检测已失效(返回 [ASIN_UNAVAILABLE])。请根据第二步实时 SERP 结果,改用当前第 1 自然位 ASIN B09FPTDBRZ 作为核心标杆,并连同前排其余 4 个核心竞品(合计 5 个 ASIN)调用 pangolinfo-amazon-data MCP 的产品详情页抓取工具(PDP Scraper,美国站 US)。
针对主标杆 B09FPTDBRZ,请重点提取并结构化输出:
1. 基础盘面:品牌、当前售价、总评分数量、平均星级、月销量标签、徽章状态;
2. 排名定位:一级大类目 BSR 排名与所属类目名称、细分子类目 BSR 排名与所属节点名称;
3. 差评基数估算:根据 1–3 星占比计算差评大致体量;
4. 内置评论洞察:完整提取页面返回的 aiReviewsSummary 字段(包含各属性维度的总提及次数、正面提及次数、负面提及次数及核心原话摘录)。
真实返回数据摘要
WorkBuddy 对 B09FPTDBRZ 等 5 个 PDP 页面完成实时穿透抓取(请求成功率 99.9%)。主标杆 B09FPTDBRZ 的真实返回数据摘要如下:
{
  "asin": "B09FPTDBRZ",
  "replacedUnavailableAsin": "B0B178VDQQ ([ASIN_UNAVAILABLE])",
  "brand": "LUKITO",
  "price": 8.99,
  "rating": 4.4,
  "totalRatings": 8783,
  "negativeRatingsShare1To3Star": "约 16%(约 1,400 条差评)",
  "monthlySales": "6K+/月",
  "badge": "Overall Pick",
  "bsrRanking": [
    {
      "rank": 1328,
      "category": "Pet Supplies"
    },
    {
      "rank": 24,
      "category": "Dog Feeding & Watering"
    }
  ],
  "aiReviewsSummary": {
    "status": "Available",
    "attributesCount": 8,
    "sampleQuote": "tore during first use, shredded into pieces within minutes"
  }
}
通过第三步的 PDP 深度穿透,我们锁定了标杆竞品的精确坐标:
1. 类目卡位极深:B09FPTDBRZ 在一级大类 Pet Supplies 中高居 #1,328,在垂直子类目 Dog Feeding & Watering 中位列 #24。配合 $8.99 的定价与 6K+/月 的销量,单链接形成了极高的销量权重护城河。
2. 差评绝对体量可观:虽然总评分为 4.4 星,但由于总评分基数高达 8,783 条,其 1–3 星差评占比约 16%,折合绝对差评数量约 1,400 条。这 1,400 条不满反馈正是检验该品类是否存在“结构性产品缺陷”或“微创新改款机会”的金矿。
3. 内置 AI 摘要完整捕获:PDP 接口直接返回了亚马逊官方聚合的 aiReviewsSummary 结构体,涵盖了 8 个核心评价维度的正负面频次统计,这为下一步应对评论接口异常提供了无缝兜底。
耗时与 credits
- 实操耗时:约 13 分钟(含失效 ASIN
B0B178VDQQ的状态排查、切换B09FPTDBRZ重新下发指令及 5 个 PDP 页面核心字段比对)。 - Credits 消耗:调用 Scraper API 抓取 5 个 PDP 页面(1 credit/页),共消耗 5 credits(累计消耗 17 credits)。
常见坑与检查点
- 死磕失效历史 ASIN:许多选品表沿用数月前的样本 ASIN,遇到
[ASIN_UNAVAILABLE]时若不及时根据实时 SERP 替换为当前第 1 自然位,会导致后续 VOC 分析失去现实参照意义。 - 忽略 PDP 内置的
aiReviewsSummary字段:在抓取 PDP 时,务必在提示词中要求保留完整的aiReviewsSummary节点。它不仅能节省后续独立调用评论接口的 credits,还能在评论端点波动时充当高可靠的数据源。 - 检查点:确认大类与小类 BSR(#1,328 Pet Supplies / #24 Dog Feeding & Watering)及 1–3 星差评基数(约 16%,约 1,400 条)已记录完毕。
5. 第四步:VOC 差评挖掘
目标
在 15 分钟时间盒内,对标杆竞品 B09FPTDBRZ 的约 1,400 条差评进行定量与定性拆解。目标是算出各个产品属性维度的负面提及率(Negative Rate),找出消费者最无法忍受的物理痛点,从而判断新卖家能否通过材质升级或结构改良做出差异化溢价(对应打分卡中的“VOC 与利润”维度)。
工具与中文提示词
按照标准预设路径,本步应优先调用 Reviews API 对应的 get_amazon_reviews 工具抓取最新 1–3 星评论文本。然而,在 2026-11-06 当天的实测中,我们对 get_amazon_reviews 端点连续发起 4 次调用均返回 0 条评论(空列表)。这是跨境数据采集中常见的平台端反爬风控或局部端点波动现象。
面对这一突发状况,WorkBuddy 工作流无需中断。我们立即启用第三步实时 PDP 中已成功提取的亚马逊官方 aiReviewsSummary 属性矩阵作为 VOC 数据源。以下是在 WorkBuddy 中执行端点探测与无缝切换解析的中文提示词:
请先尝试调用 pangolinfo-amazon-data MCP 中的 get_amazon_reviews 工具,抓取 ASIN B09FPTDBRZ 的 1–3 星差评。
若 get_amazon_reviews 端点返回 0 条评论,请勿编造任何评论内容,立即切换数据源,直接解析第三步实时 PDP 返回数据中的 aiReviewsSummary 字段:
1. 列出全部 8 个属性维度的总提及次数(Mentions)、正面次数(Positive)、负面次数(Negative),并计算负面率(负面次数 / 总提及次数);
2. 按负面率从高到低排序,识别负面率超过 40% 的核心痛点维度;
3. 引用返回数据中具有代表性的买家负面原话(英文原句),并给出产品改款工程建议。
真实返回数据摘要
WorkBuddy 忠实记录了 2026-11-06 当天 get_amazon_reviews 4 次返回 0 条评论的日志,并基于实时 PDP 的 aiReviewsSummary 输出了 B09FPTDBRZ(8,783 条评分,4.4 星,1–3 星约 16% 约 1,400 条差评)的完整 VOC 属性情感分布表:
| 属性维度 (Attribute) | 总提及数 (Mentions) | 正面提及 (Positive) | 负面提及 (Negative) | 负面率 (Negative %) | 痛点等级评估 |
|---|---|---|---|---|---|
| Durability(耐用度/抗咬性) | 193 | 44 | 149 | 77.2% | 极高危(核心结构痛点) |
| Grip(抓地/防滑性) | 269 | 115 | 154 | 57.2% | 高危(高频使用痛点) |
| Ease of cleaning(易清洁度) | 299 | 166 | 133 | 44.5% | 中高危(卫生维护痛点) |
| Suction(吸盘吸附力) | 257 | 154 | 103 | 40.1% | 中高危(吸附失效痛点) |
| Functionality(功能性) | 201 | 174 | 27 | 13.4% | 中危(功能预期落差) |
| Quality(质量) | 600 | 530 | 70 | 11.7% | 低危(整体品质尚可) |
| Engagement(互动性) | 362 | 353 | 9 | 2.5% | 低危(偶发互动问题) |
| Pet preference(宠物偏好) | 446 | 437 | 9 | 2.0% | 低危(个体偏好差异) |
按负面率从高到低排序,8 个维度呈现清晰的“四高四低”结构:耐用度 77.2%、抓地力 57.2%、易清洁度 44.5%、吸盘吸附力 40.1% 四项超过 40% 红线,全部是物理结构问题;功能性 13.4%、质量 11.7%、互动性 2.5%、宠物偏好 2.0% 四项负面率很低,说明产品的基本功能与整体品质没有系统性缺陷。最具代表性的买家原话是:“tore during first use, shredded into pieces within minutes”(第一次使用就撕烂了,几分钟内碎成一片)。改款方向因此非常明确:加厚食品级硅胶或内嵌硬质骨架解决撕咬,升级吸盘结构解决吸附,加深槽位并改用易冲洗材质解决清洁残留。但改款成本与 $8.87 的均价、$9.99 的自然中位价直接冲突——这正是第五步打分时 VOC 维度只给 8/15 分的原因。
耗时与 credits
实操耗时:约 15 分钟(含评论端点 4 次空返回的排查、切换 PDP 摘要解析及 8 个维度负面率计算)。
Credits 消耗:本案未调用 Reviews API(端点返回 0 条,切换 PDP 摘要解析额外消耗 0 credits),本步消耗 0 credits(累计消耗 17 credits)。
常见坑与检查点
把“端点返回 0 条”等同于“没有差评”:评论接口返回空集是端点波动,不是产品没有差评——本案标杆有约 1,400 条 1–3 星差评。正确做法是立即切换 PDP 的 aiReviewsSummary,绝不能凭空编造评论文本。
只看总星级不看属性分布:标杆总评分 4.4 星看似健康,但耐用度负面率高达 77.2%。只看星级会错过改款机会,也会误判“痛点可改”的成立条件。
检查点:确认 8 个维度的提及/正负面计数与负面率已完整记录,负面率超过 40% 的四个核心痛点维度(耐用度、抓地力、易清洁度、吸盘吸附力)与买家原话已归档。
6. 第五步:打分与一票否决裁定
目标
在最后的 10 分钟内,把前四步输出的结构化 JSON 汇总成一张百分制打分卡,按本模板建议口径的五维权重逐项打分,再逐一比对 5 条 Kill Switch 阈值,输出最终 GO / CAUTION / STOP 裁定报告。本步不产生新的 API 调用,全部是计算与判断。
工具与中文提示词
在 WorkBuddy 中输入以下中文提示词,让 AI Agent 用前四步已返回的真实数据完成打分与裁定:
请用前四步已返回的真实数据,为利基 "lick mat for dogs" 填写百分制打分卡并给出立项裁定。打分维度与权重(本模板建议口径):市场需求与增长动能 20 分、流量分配与垄断结构 25 分、评论壁垒与上新存活 25 分、获客成本与广告拥挤度 15 分、VOC 改良空间与退货/利润率 15 分;裁定档位:总分 ≥ 75 分且零触发 Kill Switch 为 GO,50–74 分为 CAUTION,< 50 分为 STOP;触发 ≥ 2 条 Kill Switch 时无论总分多少一律终止立项。
逐项输出每个维度的得分与扣分依据,并逐一核对 5 条 Kill Switch(KS-01 品牌点击垄断 > 65%、KS-02 近 90 天成功上新数为 0、KS-03 利基平均评论数 > 1,500 且自然前 5 均 > 500 条、KS-04 广告占比 > 85% 且均价/中位价 < $12、KS-05 近 360 天退货率 > 8%),最后给出总分与最终裁定。
真实返回数据摘要
WorkBuddy 按本模板建议口径输出的打分结果如下:
| 评估维度 | 权重(满分) | 本案得分 | 评分依据 |
|---|---|---|---|
| 1. 市场需求与增长动能 | 20 分 | 14 / 20 | 年搜索量超 174 万、季度搜索超 46 万、头部单品月销 6K+;但 T90 增速已回落至 +2.8%,红利期结束。 |
| 2. 流量分配与垄断结构 | 25 分 | 4 / 25 | Top 5 品牌垄断 76.4% 点击、Top 5 产品占 58.3%,剩余品牌只能分食不到四分之一。 |
| 3. 评论壁垒与上新存活 | 25 分 | 3 / 25 | 利基均评 2,227.1 条,自然前 5 全部在 1,302 条以上;近 90 天成功上新数为 0。 |
| 4. 获客成本与广告拥挤度 | 15 分 | 2 / 15 | 利基广告占比 95%、首页前 4 全是广告;均价 $8.87、中位价 $9.99,CPC 将吞噬全部毛利。 |
| 5. VOC 改良空间与退货/利润率 | 15 分 | 8 / 15 | 退货率仅 1.52%,痛点方向清晰;但 $9.99 锚点下改款提价极难,利润空间被锁死。 |
| 总计得分与立项裁定 | 100 分 | 31 / 100 | CAUTION 偏 STOP(高危劝退,绝非蓝海) |
Kill Switch 核对结果:KS-01(品牌垄断 76.4%)、KS-02(T90 成功上新 0)、KS-03(均评 2,227.1 且前五全破千)、KS-04(95% 广告占比 + $8.87 低均价)四条全部触发,仅 KS-05(退货率 1.52%)未触发。按“触发 ≥ 2 条即终止”的规则,本案在 60 分钟结束时唯一理性的结论就是 CAUTION 偏 STOP,保住开模与备货资金,转向下一个候选词。
耗时与 credits
实操耗时:约 10 分钟(含五维打分复核与 Kill Switch 逐条核对)。
Credits 消耗:本步为纯计算与判断,不调用任何 API,消耗 0 credits。单次完整验证总消耗 17 credits(利基 10 + SERP 2 + PDP 5 + 评论 0),在每月 60 credits 免费额度内;即使评论抽样拉满 4 页也只需 37 credits。
常见坑与检查点
只看总分不看 Kill Switch:31/100 本身已说明问题,但杀伤力在 4 条触发的红线——任何一条单独出现都值得警惕,四条同时触发就是结构性死局。打分卡与熔断机制必须双轨并行。
用 T360 增速代替 T90 动能:+145.9% 的年增速极具迷惑性,动能信号在 T90 的 +2.8%。只看年增速会误判红利期仍在,得出完全相反的立项结论。
检查点:确认五维得分(14/20、4/25、3/25、2/15、8/15)合计 31/100,4 条触发的 Kill Switch 编号与实测值已记录,最终裁定为 CAUTION 偏 STOP。
7. 异常分支、多轮追问与自动化编排
异常分支处理
真实选品流程很少一次跑通。以下是本案实测遇到与必须预设的四条异常分支,全部已有验证过的处理路径:
分支一:标杆 ASIN 失效。原始样本 B0B178VDQQ 返回 [ASIN_UNAVAILABLE]。处理:不追查失效原因,直接按第二步实时 SERP 的第 1 自然位切换标杆(本案为 B09FPTDBRZ),并在提示词中写明替换关系,避免后续步骤引用失效链接。
分支二:评论端点返回空集。get_amazon_reviews 在 2026-11-06 当天 4 次返回 0 条。处理:不编造评论,直接解析第三步 PDP 已有的 aiReviewsSummary;只有需要逐条差评原文做改款取证时,才花 5 credits/页调用 Reviews API。
分支三:利基无精确标题。实测中 “lick mat for cats” 与 “silicone slow feeder mat” 在 Niche API 里无精确标题记录(返回总数 0)。处理:改用最接近的已验证标题(如本案的 “lick mat for dogs”),或放宽为无标题筛查后再按实测值人工挑选,不要在提示词里硬编一个不存在的利基名。
分支四:首页被广告占满。本案 SERP 前 4 位全是赞助广告。处理:用 Pangolinfo 90% 以上的赞助位识别率先分离广告位与自然位,再数自然前 10 的评论墙;绝不能把广告位的评论数算进自然晋升门槛。
多轮追问技巧
五步主提示词跑完后,不要停在第一版输出。用追问让 AI Agent 把结论压得更实,以下三组追问可直接复制进 WorkBuddy:
追问一(垄断穿透):“把 Top-5 品牌的点击份额按品牌逐一列出,并判断第 6 名及以后的品牌合计还能分到多少点击。”
追问二(动能复核):“对比 searchVolumeT90 与 searchVolumeT360 的增速,判断该利基的红利期是否已经结束,并给出判断依据。”
追问三(改款清单):“把 VOC 负面率超过 40% 的维度列成改款清单,每个维度给出一句工程改动建议与一项成本代价。”
追问时坚持一条规则:每次只追一个维度,且要求 Agent 引用已返回的真实数字作答,不接受无数据支撑的泛泛判断。
自动化编排
把五步提示词固化为 WorkBuddy 里的一个标准会话模板后,单次验证就变成可重复的流水线:新建会话、粘贴五步提示词、填入候选利基名,60 分钟后直接取裁定报告。两个编排要点:第一,每个利基单独开一个新会话,避免上一个利基的数据污染下一个的打分;第二,利基快照按月重跑、SERP 与 PDP 按周重跑——本案快照是 2026-08-02 的,SERP 是 2026-11-06 实时的,跨天复用必须重跑实时盘面,否则裁定失真。28 列核验表是唯一的事实底表,所有步骤的输出都要回填到同一行。
常见问题解答(FAQ)
Q1:WorkBuddy 跑五步和手工查网页比,到底省在哪?
手工查不到 top5BrandsClickShare、returnRateT360 这类深层利基指标,数 60 条 SERP 的广告位也容易错;WorkBuddy 一次调 MCP 就把利基快照、实时 SERP、PDP、VOC 全拉回来填表,60 分钟出裁定,手工半天还未必准。
Q2:MCP 配置失败、连不上远程地址怎么办?
先确认 API 密钥有效且 Bearer 头格式正确,再检查网络能否访问远程地址;WorkBuddy 里看得到 21 个工具才算接通;仍失败就换网络环境重试,不要在提示词里硬编码真实密钥。
Q3:免费 60 credits 够跑几次完整验证?
单次完整验证 17–37 credits(利基 10 + SERP 2 + PDP 5 + 评论 0–20),免费额度每月够跑 1–3 个利基;评论抽样按需开,不翻评论页时一次只要 17 credits。
Q4:Reviews API 到底要不要调?
先看 PDP 的 aiReviewsSummary 够不够用——本案 8 个维度的正负面计数都已在 PDP 里,直接解析 0 额外成本;只有需要逐条差评原文做改款取证时,才花 5 credits/页调 Reviews API。
Q5:五步能不能拆开多天做?
可以拆,但要锚定同一验证窗口:利基快照标 2026-08-02、SERP 与 PDP 标实时日期;跨天做必须在打分前重跑一次 SERP,否则快照与盘面脱节,裁定不可信。
推论:五步工作流的价值不在于跑出一个“能做”的结论,而在于用 60 分钟与 17 credits 的最小成本,在开模打样之前拦截掉像 lick mat for dogs 这样看似热闹、实则垄断锁死的红海。跑完本篇的五步实操后,读者可继续沿着系列第 3 篇的打分卡阈值推导与第 4 篇的完整提示词包,把单次验证固化为团队的标准作业流程。