
在亚马逊上寻找高利润爆款,本质上早已不是“凭感觉看图”,而是一场严谨的数据漏斗筛选与工程验证问题。面对同一个大类目,普通卖家花整个周末在浏览器标签页和卖家后台里手动翻找;而顶尖的量化选品团队则通过一套标准化的 Amazon niche discovery workflow(亚马逊细分利基市场挖掘工作流),在投入第一笔模具和备货资金前,先用程序化接口跑完 90 天搜索增长率、前五大品牌点击垄断度、360 天退货率以及真实邮编下的 SP 广告密度测算。
为什么很多卖家明明照着网上的选品教程设置了“高需求、低竞争”筛选条件,最后做出来的产品依然亏钱?原因很残酷:当全网 5 万名卖家都在用同一款 SaaS 软件的同一个“蓝海预设模板”时,周一筛出来的“蓝海”,到了周五就已经挤满了跟风上架的同行。
本文将全面复盘全网主流选品流程的优劣,并为你拆解一套面向 2026 年的六步闭环 Amazon niche discovery workflow——无论你是偏爱无代码飞书看板的运营团队、使用 Claude/Cursor 的 AI 原生玩家,还是拥有自研系统的开发团队,都能借助 Pangolinfo 实时电商数据底座 快速落地。
一、 为什么传统的亚马逊选品工作流在 2026 年频频失灵?
如果你调研过目前 Google 上排名靠前的选品指南(如围绕亚马逊官方 Product Opportunity Explorer 商机探测器 或传统子类目筛选工具的教程),会发现它们大多遵循“搜词 → 看总搜索量 → 数前十名评论数 → 算毛利”的线性手工流程。
但在 2026 年的亚马逊生态下,这套传统工作流存在四个致命盲区:
- 静态快照偏差与数据滞后:亚马逊后台商机探测器的数据按周甚至按月更新,而普通第三方工具往往依赖缓存估算。单次 BSR 快照根本无法区分一个细分市场是处于“长期健康增长”,还是短视频带货后的“瞬时退潮期”。
- 隐蔽的广告垄断与“千人千面”地域盲区:很多利基市场自然排名看似分散,但首屏 70% 的坑位已被高竞价的 Sponsored Products (SP) 广告焊死。更要命的是,普通工具使用机房 IP 抓取,无法传入真实交付地邮编(ZIP Code),完全看不出美国东海岸(
10001)与西海岸(90001)在 FBA 配送时效、价格及断货率上的巨大差异。 - 缺乏前置退货率过滤与规模化差评工程拆解:搜索量再大,如果该细分品类平均退货率高达 12% 以上(如尺码极易出错的服饰或高故障率电子配件),盲目切入就是给平台交学费;反之,只人工抽看 10 条评论极易陷入幸存者偏差,漏掉真正能构筑产品护城河的结构性改款痛点。
- 忽视 AI 搜索入口截流(Alexa for Shopping 与 Google AI Overview):随着亚马逊将 Rufus 全面升级为 Alexa for Shopping,以及 Google 搜索顶部普及 AI Overview,越来越多买家直接通过对话式提问完成选品。如果某个利基在 AI 回答中已被两个老牌完全绑定,传统关键词搜索量再高也难以转化。
二、 2026 实战级 Amazon Niche Discovery Workflow:六步漏斗全景图
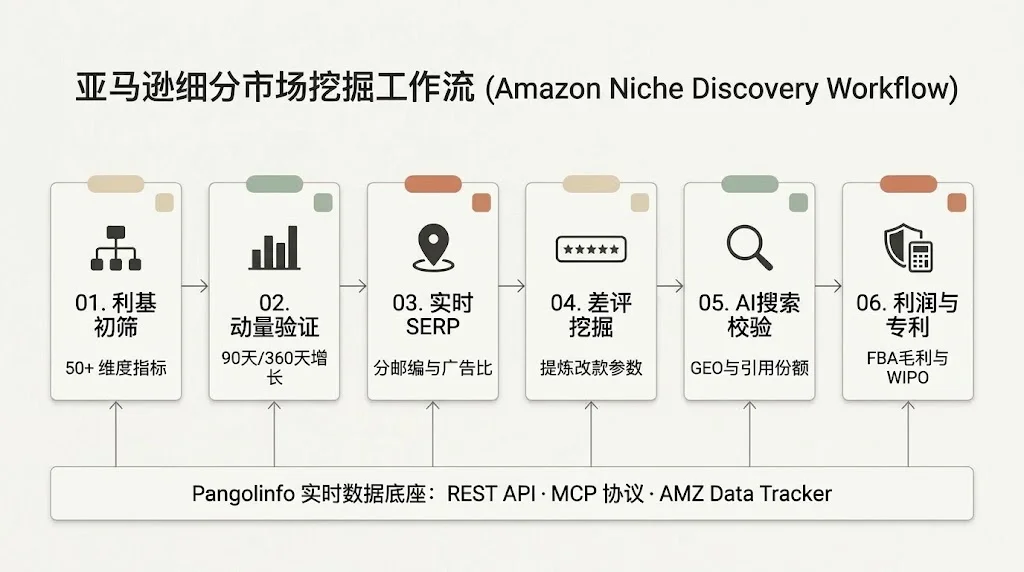
为了彻底解决上述痛点,我们将现代化的亚马逊利基市场挖掘工作流重构为以下六个环环相扣的数据验证阶段,每一阶段均配有明确的量化淘汰红线(Kill Criteria)与对应的 Pangolinfo 产品与接口文档支撑:
| 工作流阶段 | 核心验证目标 | 量化筛选阈值(Pass/Kill Benchmarks) | 对应的 Pangolinfo 解决方案与文档 |
|---|---|---|---|
| 阶段 1:全类目树与宏观利基初筛 | 从数万个细分需求群中快速锁定 20–30 个高潜候选池 | searchVolumeT90 > 10,000;top5BrandsClickShare ≤ 40%;returnRateT360 ≤ 6%;均价 $22–$75 |
亚马逊利基数据 API(Niche Filter 接口文档) |
| 阶段 2:新品存活率与生命周期验证 | 确认新品牌是否有真实突围空间,排除伪爆款与夕阳市场 | successfulLaunchesT360 ≥ 3 个;90天与360天增长率同向为正;存在评论 <300 但月销破万美金的新品 |
亚马逊利基数据 API & Category Tree API |
| 阶段 3:分邮编实时 SERP 与广告密度审计 | 测算真实 PPC 抢位成本与东西海岸区域断货机会 | 首屏 SP/SB 广告占比;前3自然位品牌重合度;指定邮编下的 Prime 覆盖率与断货率 | Amazon Scraper API & 关键词与广告监控 |
| 阶段 4:全量差评挖掘与微创新立项 | 提炼高频 1–3 星真实抱怨,将差评直接转化为工厂改款参数 | 单一结构缺陷在差评中提及率 ≥ 8%;提取 Customer Says 核心情感标签 |
Amazon Review API(评论接口文档)& VOC Insight MCP |
| 阶段 5:站内外 AI 搜索可见性(GEO)评估 | 检查目标利基在 Alexa 与 Google AI 摘要中的品牌固化度 | Google AI Overview 提及品牌集中度;Alexa 商品页问答推荐倾向 | AI Overview SERP API(AI Mode 文档) |
| 阶段 6:FBA 利润精算、专利排雷与动态追踪 | 锁定净利率 >30%,排除商标/外观专利风险,持续追踪 30 天 | 官方 FBA/MFN 费用明细;WIPO 商标与 PACER 专利诉讼清零;30天 BSR 趋势监控 | FBA 费用测算 API 文档、WIPO API & AMZ Data Tracker |
第一步:程序化宏观利基初筛(区分 Category 与 Niche)
在启动工作流时,首先要厘清 “类目(Category)” 与 “利基(Niche)” 的本质区别:类目是亚马逊官方 Browse Node 目录树上的固定节点(如 Home & Kitchen),而利基是基于海量买家真实搜索词与连带购买行为动态聚合出的精准需求市场(如 iphone 16 wallet case 或 儿童防漏不锈钢保温便当盒)。
借助 Pangolinfo 亚马逊利基数据 API,你无需在网页端手动翻页,只需一次 POST /api/v1/amzscope/niches/filter 请求(完整参数见 Niche Filter API 官方文档),即可在 5–10 秒内通过 50+ 项深度商业指标筛出高潜利基:
- 需求量级底线(
searchVolumeT90Min):设定 90 天搜索量≥ 10,000,同时参考netShippedGmsSum(净发货 GMS 总额),确保拿到 3% 市场份额即可贡献可观现金流。 - 头部垄断红线(
top5BrandsClickShareMax):设定前五大品牌点击份额≤ 0.40(40%),结合top20ProductsClickShare排除被单一巨头垄断的畸形市场。 - 高退货率一票否决(
returnRateT360Max):直接在 API 请求中设定过去 360 天退货率≤ 0.06(6%),从源头避开高售后损耗的深坑类目。
curl --request POST   --url https://scrapeapi.pangolinfo.com/api/v1/amzscope/niches/filter   --header 'Authorization: Bearer YOUR_API_KEY'   --header 'Content-Type: application/json'   --data '{
    "marketplaceId": "US",
    "searchVolumeT90Min": 10000,
    "top5BrandsClickShareMax": 0.40,
    "returnRateT360Max": 0.06,
    "page": 1,
    "size": 20
  }'
第二步:验证新品突围存活率与需求动量
筛出低垄断、低退货的候选池后,切忌只看存量不看增量。继续调取 亚马逊利基数据 API 中的生命周期指标进行二次过滤:
- 对比长短期增长曲线(
searchVolumeGrowthT90vs.searchVolumeGrowthT360):寻找 90 天与 360 天搜索量同步稳健增长的细分市场,剔除增长率大起大落的短期网红品。 - 计算新品突围率(
newProductsLaunchedT360与successfulLaunchesT360):重点核查过去一年内上架的新品中,有多少比例成功存活并稳定出单;同时结合avgBrandAge(平均品牌年龄)与searchToPurchaseRatio(搜索购买转化比),优先选择对新品牌友好、买家重功能轻品牌的市场。
第三步:分邮编实时 SERP 审计与广告战况摸底
宏观利基指标代表过去 90 天的均值,而今天的前台搜索结果页(SERP)才代表真实的获客成本。
对进入复赛的 10 个利基市场,调用 Amazon Scraper API(配合 关键词与广告监控方案),传入美国东西海岸核心邮编(如纽约 10001、洛杉矶 90001)实时抓取核心词前 3 页结果。依托千万级原生住宅代理池与深度渲染技术,Pangolinfo 能够以 96%–98%+ 的准确率剥离自然排名与 Sponsored Products (SP) / 品牌视频广告(技术细节详见 Pangolinfo API 文档中心):
- 测算付费入场门槛:如果首页前 8 个坑位中有 5 个以上是高强度 SP 广告,说明该词属于典型的“付费强推型市场”,必须在立项时预留充足的首发 PPC 预算。
- 捕捉区域性断货与配送空白:对比不同邮编下的 Prime 覆盖率(
primeProductsPercentage)与断货率(avgOosRate),寻找头部竞品在特定区域供货不足的切入窗口。
第四步:批量 VOC 评论挖掘与产品微创新逆向工程
在 2026 年,没有任何微创新的“纯公模跟风品”注定沦为价格战炮灰。真正值钱的产品定义,就藏在竞品的一星至三星差评里。
与其让运营人工翻看十几条评论,不如直接调用 Amazon Review API(参见 Amazon Review API 中文接口文档)或接入 VOC Insight MCP,一次性拉取前 10 名竞品最近 3 个月的全部差评全文、验证购买标识(Verified Purchase)以及亚马逊原生的 Customer Says AI 评论摘要:
- 量化差评议题频次:让大模型按“结构设计缺陷、材质耐用度、尺寸不符、包装破损、功能缺失”自动聚类。
- 锁定工厂改款立项点:当某一个具体痛点(例如 “硅胶保鲜盖在大号碗边缘无法密封”)在多款头部竞品的差评中提及率 ≥ 8% 时,这就是你最具确定性的微创新切入点与首图视觉卖点。
第五步:站内外 AI 搜索可见性(Alexa + Google AI Overview)校验
在移动互联网向生成式 AI 演进的当下,完整的选品工作流必须多看一步“AI 入口”:
- 站内 Alexa for Shopping 提问分析:使用 Pangolinfo 文档中心 提供的
Alexa Listing API,提取竞品详情页下买家最常向 AI 购物助手提出的问题及 AI 推荐关联品逻辑。 - 站外 Google AI Overview 趋势验证:调用 AI Overview SERP API(参见 AI Mode API 文档),检索
"best [目标利基词] 2026",看 Google 顶部 AI 摘要推荐了哪些品牌、引用了哪些垂直测评媒体,提前为新品上线后的站外种草与 GEO(生成式引擎优化)铺路。
第六步:FBA 利润精算、专利合规排雷与 30 天动态追踪
在最终拍板下单前,用三个自动化工具完成风控闭环:
- 官方级 FBA/MFN 费用精算:将目标竞品 ASIN、包装尺寸、重量与目标售价传入 Revenue Calculator API,直连亚马逊官方计费服务返回精准的佣金、FBA 配送费与月度仓储费,确保扣除首发折扣和广告费后仍有 30%–35% 以上的净利空间。
- WIPO 全球商标与 PACER 专利诉讼排雷:调用 Pangolinfo API 文档 中的
WIPO API与PACER检索工具,按关键词、申请人与技术领域排查外观专利与商标侵权风险,杜绝上架即遭 TRO 冻结的惨剧。 - 30 天持续观察而非单次盲猜:将最终入围的 20 个标杆 ASIN 加入 AMZ Data Tracker,连续追踪 14–30 天的价格波动、评论增速(Review Velocity)与 BSR 曲线,确认趋势稳健后再正式立项。
三、 三种落地路径:不同规模团队如何一键跑通这套工作流?
搭建这套 Amazon niche discovery workflow 并不意味着你必须招一支爬虫工程师团队。Pangolinfo 基于同一套底层数据引擎,提供了三种灵活的接入方式:
- 方式一:零代码 AI 对话式选品——接入 Amazon Data MCP
适合独立卖家、选品经理与 AI 极客。只需 3 分钟在 Claude Desktop、Claude Code、Cursor 或 OpenClaw 中粘贴一行配置,你的 AI 助手就会原生获得 19 个实时数据工具(含利基筛选、商品详情、评论抓取、AI 搜索与 WIPO 专利检索)。你只需用自然语言下达指令:“帮我筛选美国站家居类目下 90 天搜索量大于 15,000、前五大品牌点击份额低于 35%、退货率低于 5% 的蓝海利基;拉取排名第一利基下前 5 名竞品的最新差评提炼改款方案,并排查 WIPO 外观专利风险。”
- 方式二:无代码可视化表格协同——使用 AMZ Data Tracker
适合无需写代码的运营团队。通过可视化界面配置目标 ASIN、关键词与榜单定时采集任务,将结构化数据直接自动同步至飞书多维表格(Lark Base)或 Excel,轻松沉淀团队内部的动态选品库。 - 方式三:企业级高并发数据管道——集成 亚马逊利基数据 API 与 Amazon Scraper API
适合亿级大卖、跨境 ERP 及 SaaS 服务商。通过标准 RESTful API 将 50+ 维度的利基指标与实时 SERP 数据无缝写入企业自研 BI(Tableau/PowerBI)或选品中台(完整接口规范见 docs.pangolinfo.com)。
四、 常见问题解答(FAQ)
1. 亚马逊利基数据 API 中的“利基(Niche)”和普通类目(Category)有什么区别?
类目(Category)对应亚马逊官方固定的 Browse Node 目录树;而利基(Niche)是基于真实买家的海量搜索词与连带购买行为动态聚合出的细分需求市场。使用 亚马逊利基数据 API 可以直接按买家真实意图群组评估市场容量与垄断度。
2. 跑完一次完整的利基挖掘工作流需要多少数据成本?
相比动辄数千美金年费的传统选品软件,Pangolinfo 采用按成功调用量计费的模式:调用一次 Niche Filter API 仅消耗 10 积点,类目树检索仅需 2 积点,商品详情页采集 1 积点/页,评论采集 5 积点/页。完成一个细分市场的深度扫描与验证通常不到 500–800 积点,且前往 Pangolinfo 官网 免绑卡注册即可获得免费测试额度。