
亚马逊差评分析的核心不是逐条回复差评,而是用50+条差评样本做8类分类、按“频率×星级伤害”排序、安全类问题单独处理,再用5 Whys找到根因并跟踪修复效果。 进入2027年,随着亚马逊在2026年2月12日至5月31日完成按品类的变体评论拆分,并将Rufus正式升级为Alexa for Shopping,负面评论对单一子体评分与AI导购摘要(Customers say)的杀伤力显著放大。在本系列第一篇支柱文章中,我们搭建了通用的6步评论分析SOP;作为2027年专项实操指南,本文将彻底聚焦“1至3星差评子集”,为您提供一套从样本构建、8维分类、优先级加权、根因穿透到修复追踪的闭环方案与实操表格模板。
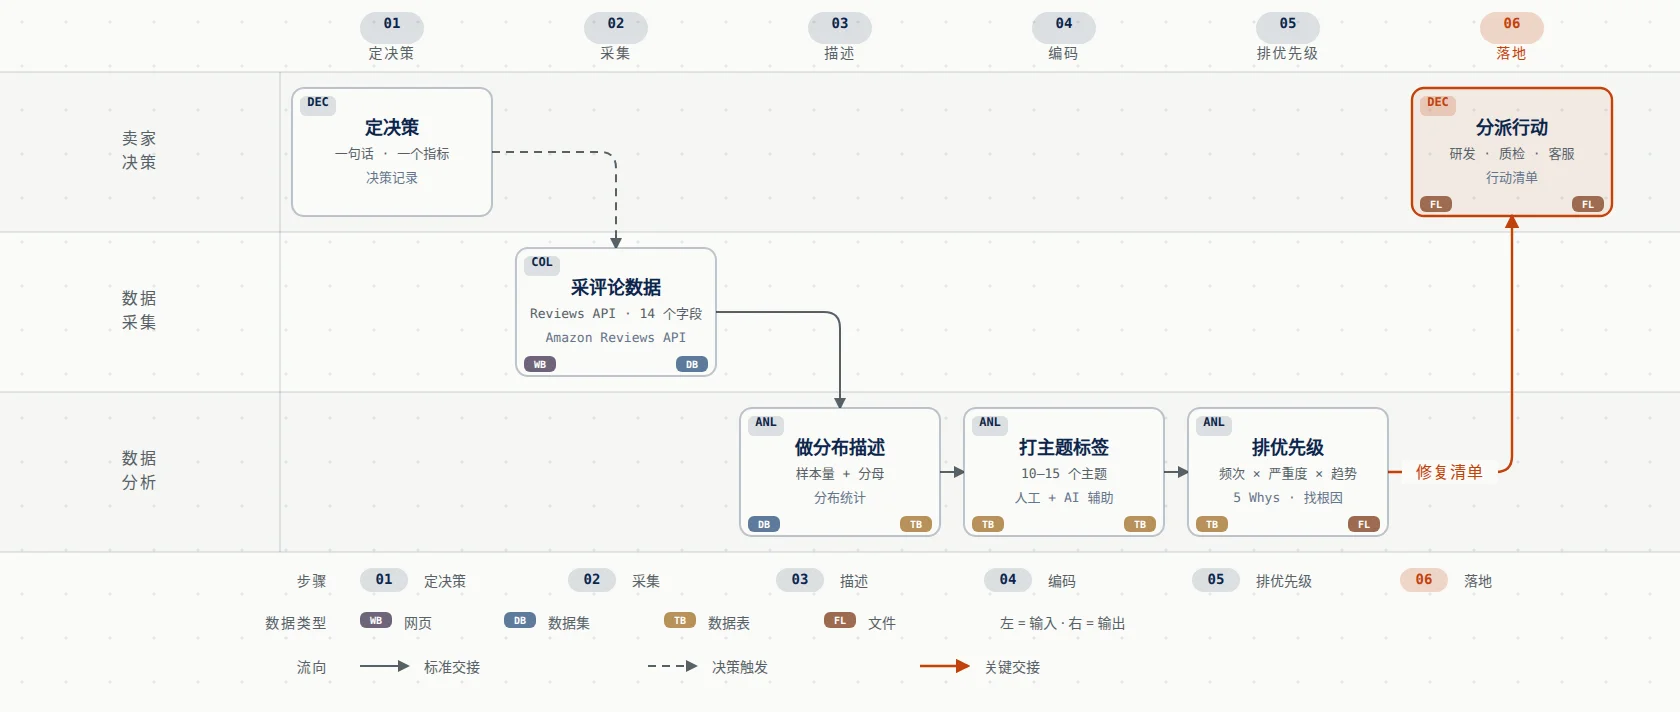
第一步:采集50+条差评样本(覆盖自有ASIN与3–5个核心竞品)
构建差评语料库的第一原则是汇聚至少50条以上的1至3星评论(覆盖自有ASIN与3至5个核心竞品),并将信息密度最高的3星保留意见纳入样本池。 仅看1星往往只能收集到极端情绪,而忽略竞品则无法判断某类缺陷是行业通病还是自身批次事故。
在2027年启动差评采集时,请严格执行以下三项规范:
1. 锁定“自有ASIN + 3–5个竞品”凑齐50+条差评基数
成熟链接可直接拉取近90至180天内的50条以上差评;若是刚上线的新品或低评论量ASIN,自身差评不足10条,必须同步抓取同品类3至5个直接竞品的差评以凑齐50+条样本。注意,50+条是展开工程排查与业务归类的实操起点,切勿将其视为统计学显著性门槛;汇报时必须始终同时写明样本量 n 与对应的总评论分母。
2. 范围锁定1–3星,重点拆解3星评论的“保留意见”
差评分析绝不能只抓1星和2星。在亚马逊评论生态中,3星评论的信息密度最高:买家通常会克制地写明“A功能尚可,但因B设计缺陷和C说明不清只能给3星”。这些保留意见是产品从4.1星跃升至4.5星的突破口。若使用第三方工具(如Helium 10、Jungle Scout、卖家精灵等,具体费用请查看官方结账页面)导出数据,需注意没有任何厂商公开披露其情感或主题模型的准确率,且AI摘要存在二层失真、极易抹杀低频致命问题,因此必须拉取原始评论正文并随机抽查20至30条进行人工核验。
3. 隔离变体属性与时间戳
受2026年变体评论拆分政策影响,采集时必须保留每条差评的子变体(尺码、颜色、款式)、站点、日期与Verified Purchase标识。若不剥离变体字段,很容易因某一个特定颜色的涂装掉漆差评而误判整条产品线的模具质量。
第二步:将差评归入8大标准类别(定义、典型表述与责任部门)
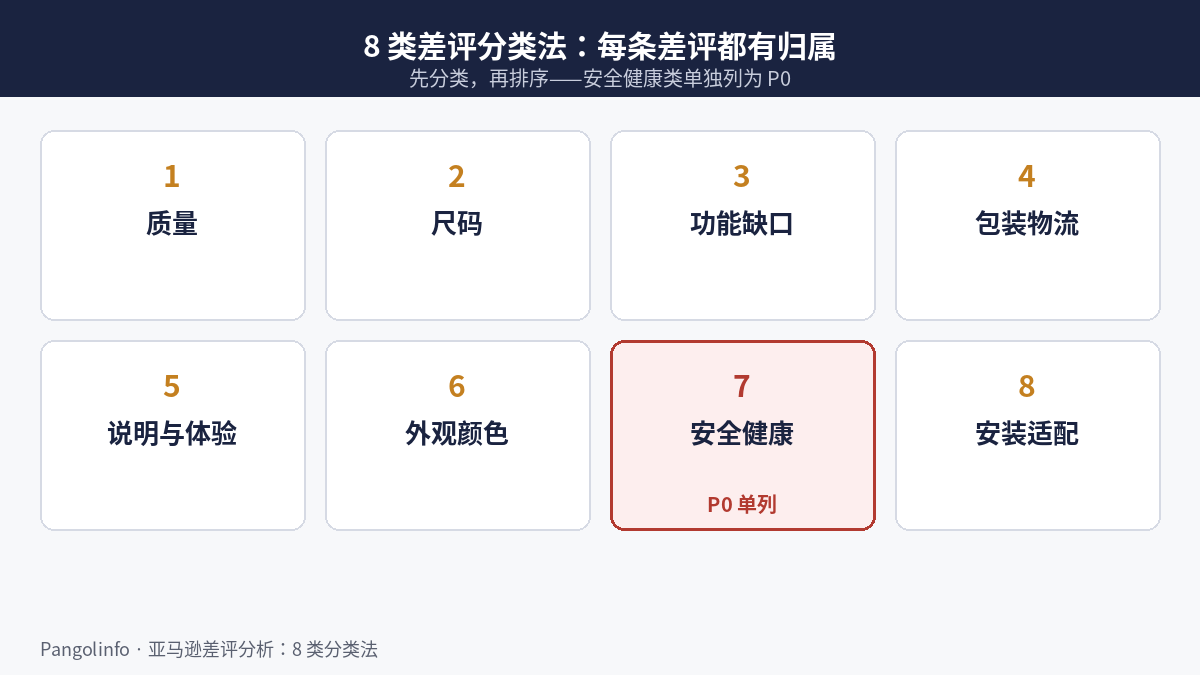
将非结构化抱怨转化为可执行任务的关键,是把每条1至3星评论精准映射至8个标准类别,并直接绑定内部责任部门。 笼统打上“质量差”标签毫无指导意义;当一条差评同时吐槽多个痛点时,应在底表中按“方面级情感”拆分为多行,分别归入对应类别。
以下为2027年标准差评8类分类法(8-Category Taxonomy)字典与归属矩阵:
| 类别编号与名称 |
核心定义与判定边界 |
买家典型原声表述(中英对照) |
内部归属与主责部门 |
|---|---|---|---|
| 1. 质量(Quality) |
正常使用下发生结构断裂、元器件失灵、材质老化、漏水漏电或批次性做工粗糙。 | “用三次马达就烧了” / “Stopped working after a week” |
供应链管理、工厂品控(QC)与硬件研发部 |
| 2. 尺码(Sizing & Fit) |
服鞋尺码偏大偏小、配件公差不准、容量体积与常规认知或标称值存在显著偏差。 | “XL像M码一样紧” / “Runs way too small” |
产品开发部(版型/公差校准)与Listing运营部 |
| 3. 功能缺口(Feature Gap) |
产品未坏,但缺乏买家默认应具备的核心功能,或性能、续航、功率低于预期。 | “不支持快充” / “Suction too weak for pet hair” |
产品经理(PM)与新品立项(NPD)团队 |
| 4. 包装物流(Packaging & Shipping) |
外箱压瘪、防震不足导致运输破损、配件漏发、发错货或亚马逊FBA派送延误。 | “盒子烂了玻璃碎一地” / “Missing mounting screws” |
包装结构工程师、仓储打包组与FBA物流协调员 |
| 5. 说明与体验(Instructions & UX) |
说明书难懂、按键交互反人类、清洁维护繁琐导致买家因“不会用”误判产品坏损。 | “没有英文步骤图” / “Impossible to reset” |
用户体验(UX)、平面设计(说明书)与客服部 |
| 6. 外观颜色(Appearance & Color) |
实物与渲染图严重色差、塑料感强、涂装划痕或廉价感导致的期望落差。 | “香槟金收到是土黄” / “Looks like cheap plastic” |
视觉设计部(渲染与实拍校准)与表面工艺厂 |
| 7. 安全健康(Safety & Health) |
发热起火冒烟、锋利毛刺划伤、刺鼻异味、皮肤过敏、幼童误吞隐患或食品变质。 | “充电接口发烫融化” / “Sharp edge cut my finger” |
合规法务部、最高品控委员会与运营总监(单列) |
| 8. 安装适配(Installation & Compatibility) |
孔位对不上、接口协议不兼容、与特定车型、手机或家具型号无法匹配固定。 | “装不进车载支架槽” / “Doesn’t fit US 3/8 valve” |
结构工程师(转接头适配)与文案合规核查组 |
编码时请特别留意买家上传的图片与视频。目前没有任何商业评论工具公开披露其能自动解析图片与视频评论,但“孔位错位”或“电路板烧焦”等关键证据往往只存在于视觉附件中,必须由分析人员人工核实。
第三步:按“频率 × 星级伤害”排序,安全健康类问题单独提级处理
差评整改绝不能简单按提及次数排队,而必须用“提及频率 × 星级伤害”计算综合加权分,且任何“安全健康类”差评无论频率多低都必须剥离常规队列、无条件优先处理。
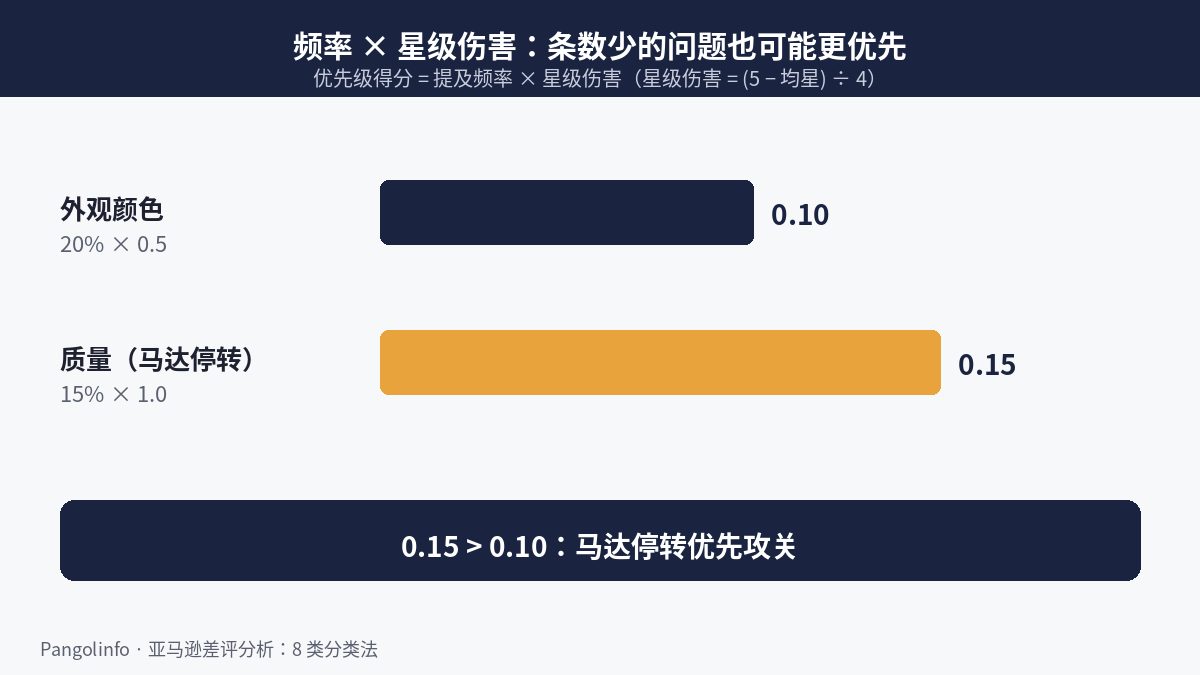
1. 常规7类问题的“频率 × 星级伤害”加权公式
研发与运营资源有限,对于除安全健康外的其余7大类别,请按以下公式计算优先级得分:
差评优先级得分 = 该类差评频率 × 星级伤害系数
该类差评频率 = 该类别差评条数 ÷ 本次采集的差评总样本量 n
星级伤害 = (5 − 均星) ÷ 4
这是一个透明的启发式系数,不是统计模型。
-
该类差评频率(Frequency):该类别差评条数除以本次采集的差评总样本量 n(如 60 条差评中有15条属“安装适配”,频率为 15 / 60 = 25.0%)。
- 计算示例:“外观颜色”类有12条差评(频率20%),买家多给3星(均星3.0,星级伤害为 (5 − 3.0) / 4 = 0.5),得分为 0.20 × 0.5 = 0.10;而“质量(马达停转)”类虽只有9条差评(频率15%),但全是1星(均星1.0,星级伤害为 (5 − 1.0) / 4 = 1.0),得分为 0.15 × 1.0 = 0.15。0.15 大于 0.10,显然,马达停转对评分的破坏力远超轻微色差,必须优先攻关。
星级伤害系数(Star Damage):星级伤害 = (5 − 均星) / 4,其中“均星”为该类别差评的平均星级。
2. 安全健康类问题:零容忍单列与红线熔断机制
在50条差评中,哪怕只有1条提到“充电冒烟”、“割手”或“红肿过敏”,其频率也仅有 2%,套用乘法公式得分极低,在AI摘要中更会被直接抹平。但在亚马逊规则下,只要积累2至3次发热起火或人身伤害投诉,系统就会立刻触发安全审核并下架Listing。因此SOP强制规定:凡编码为“7. 安全健康”的差评,不参与常规算分,直接单列为“P0级紧急工单”,24小时内启动批次封存与工程复现。
第四步:用5 Whys穿透表面抱怨,找到可落地的工程与运营根因
差评写的永远是“表面症状”而非“底层病因”,针对加权选出的前3名核心差评类别,必须召集跨部门人员连续追问5个为什么(5 Whys),直至推导出可修改的图纸公差、包装结构或文案参数。
以下通过“便携式意式咖啡机”差评案例,完整推演如何从表面投诉穿透至可执行根因:
-
原始症状(类别:1. 质量 & 5. 说明与体验):在 65 条1至3星差评中,有18条(占差评样本 27.7%,均星1.3星)抱怨:“用了一周就彻底不出水,只会嗡嗡响,质量太垃圾!”
Why 1:为什么水泵还在响却压不出水? 拆解退货件与差评视频发现,并非水泵损坏,而是单向进水阀被极细的咖啡粉渣堵死。
Why 2:为什么粉碗里的咖啡粉会倒流进上方的进水阀? 买家使用了超细研磨粉(Turkish grind),且填粉量超过粉碗上限,泄压时高压水流将细粉反冲进了进水口。
Why 3:为什么大量买家同时用错研磨度并超量填粉? 黑色塑料粉碗内的“MAX刻度线”为同色暗纹,室内光线下几乎看不见;且包装未附赠定量粉勺。
Why 4:为什么买家没看说明书里的研磨度与刻度提醒? 警告印在24页黑白折页说明书的第14页角落,且Listing第4张主图使用了误导性的极细粉末特写。
Why 5:为什么上月该差评频率突然从8%飙升到27.7%? 核查供应链记录发现,上月工厂为降本0.15美元,将进水口双层不锈钢滤网简化为单层冲孔网,导致防反冲容错率减半。
根因结论与三端改进动作:
-
运营端(48小时内):撤换第4张附图,标明“请用中细研磨粉,勿用超细粉”,A+页面增加防堵清洗动图。
包装端(7天内):机身顶部贴亮黄色MAX线强提醒贴纸,配件包补入标准8克量勺。
工程与供应链端(下一批次):停用单层冲孔网,恢复双层烧结滤网,并将粉碗内部MAX刻度线改为白色激光镭雕。
第五步:修复措施落地、红线合规边界与恢复效果跟踪模板
差评分析的最终闭环,是在严守监管合规红线的前提下落地改版,并通过30/60/90天周期跟踪目标差评率是否实质性回落。
1. 严守合规红线:FTC 16 CFR Part 465 与平台铁律
推进差评修复时,全员必须严守三条铁律:绝不以返现、礼品卡、免费换新或折扣诱导买家修改或删除差评;绝不通过站外邮件、电话或包裹卡片私下联系差评者施压;绝不利用技术或变体合并手段压制真实差评。
依据美国联邦贸易委员会生效的《消费者评论与证言规则》(FTC Consumer Review Rule, 16 CFR Part 465),诱导改评或压制差评均属违法,每次违规最高罚款 53,088 美元;英国CMA亦已接受亚马逊严打评论操纵的法律承诺。差评分析的唯一合法用途,是从源头修复产品、升级包装防呆并修正Listing失真描述。
2. 复查周期与验收指标
修复措施落地后,切勿用历史累计总星级评估效果。应以“措施生效日(新批次入库日或文案修改日)”为分界线,按30天、60天、90天周期独立采集生效后的增量评论(同时报告增量样本量 ),核查该类别差评占比是否显著下降。
3. 差评修复与恢复效果跟踪表(模板)
| 工单号与ASIN |
差评类别 |
5 Whys核心根因 |
修复措施与主责部门 |
生效日期 |
整改前基线(样本 n/分母) |
生效后30天复查(增量 n/分母) |
验收状态与动作 |
|---|---|---|---|---|---|---|---|
| #NC-01 B0XXXXXX01(黑-大号) |
7. 安全健康 (P0单列) |
充电线护套过软,弯折后铜丝外露发热 | 供应链:换加厚TPE护套并全检库存;运营:下架老SKU | 2027-02-01 | 占差评 3.3% (2/60),占总评 0.5% (2/400),均星 1.0 | 占增量差评 0.0% (0/18),占增量总评 0.0% (0/150) | 已结案:连续60天零复发,解除警报 |
| #NC-02 B0XXXXXX01(全变体) |
1. 质量 & 5. 说明体验 |
单层滤网容错低+粉碗无明显刻度致细粉堵阀 | 工程:恢复双层滤网+白镭雕刻度;包装:加亮黄贴纸与量勺 | 2027-02-15 | 占差评 27.7% (18/65),占总评 4.5% (18/400),均星 1.3 | 占增量差评 8.3% (2/24),占增量总评 1.1% (2/180) | 持续观察:贴纸见效,待3月新滤网到货复核 |
| #NC-03 B0XXXXXX02(蓝-标准款) |
8. 安装适配 |
附赠M6膨胀螺丝比北美石膏板支架短5毫米 | 包装:增配加长M6螺丝;运营:第2张主图注明适配墙厚 | 2027-03-01 | 占差评 20.0% (10/50),占总评 3.1% (10/320),均星 2.1 | 占增量差评 4.5% (1/22),占增量总评 0.6% (1/165) | 已达标:投诉降超七成,转入常规监控 |
结语:差评分析以完整采集为前提
任何深度的差评归类与5 Whys根因推演都以数据采集为前提:拿不到的评论无法分析,所以在启动8类分类法之前,必须先解决评论采集问题。 若在源头受限于前端折叠或字段残缺,缺失了关键的子变体属性、日期与1至3星完整文本,后续的优先级加权与恢复跟踪就无法落地。
为稳定拉取包含完整元数据的评论语料,团队可以使用 Amazon Reviews Scraper API 作为底层数据获取方案。若需回顾涵盖全星级分布、13个分析盲点与月度复盘的完整框架,请阅读本系列支柱文章《如何分析亚马逊评论:完整 SOP 与 6 步方法(2027)》;关于抓取评论并开展差评拆解的具体实操步骤,请参考《如何抓取亚马逊评论并进行差评分析》。(接口参考见 Review API 中文文档。)
常见问题解答(FAQ)
1. 为什么差评分析必须把3星评论也纳入样本池?
1星评论多为极端情绪宣泄,而3星评论是亚马逊上信息密度最高的反馈。给出3星的买家通常会客观列出“哪些功能好、但因哪一两个具体痛点只能给中评”。将3星保留意见纳入50+条样本池,能帮团队精准捕捉最易修复的期望落差与体验瑕疵。
2. 自有新品的差评还不到10条,怎么做8类分类法?
自有ASIN差评不足时,应将其与同品类3至5个核心竞品的1至3星评论合并采集,凑齐50条以上差评基数。这样不仅能看清品类的共性结构缺陷与适配痛点,还能在新品放量前提前在包装、说明书和五点描述中做好防呆规避。
3. 发现严重的1星差评后,可以联系买家退款来请求修改评论吗?
绝对不可以。根据美国FTC《消费者评论规则》(16 CFR Part 465),任何以退款、礼品卡或补偿诱导买家修改、删除差评或私下施压评论者的行为均属违法,每次违规最高罚款53,088美元,且会触发亚马逊封店。差评只能用于驱动内部产品与文案改进。
4. 为什么安全健康类差评不能按“频率×星级伤害”排队?
因为起火冒烟、割伤或过敏等安全隐患早期往往只有1至2条低频反馈,按频率相乘得分极低,甚至会被AI摘要抹平。但此类问题一旦累积就会触发亚马逊安全审核强制下架乃至召回诉讼,因此无论频率多低,都必须单独列出并作为P0级最高优先级处理。
5. 产品改进落地后,多久复查一次差评率才科学?
建议以新批次入库日或Listing修改日为分界点,按30天、60天、90天周期复查。复查时切勿看历史累计总星级,而应单独统计措施生效日后新增评论中的目标差评占比(始终同时报告增量样本量 n 与分母),以此验证修复动作是否真正起效。