
在支柱页的数据地图里,评论与 Q&A 被单列为一类,原因在于它与其他七类数据有一个本质区别:价格、排名、评论量描述的都是”市场发生了什么”,是结果变量;评论文本描述的是”用户为什么不满意”,是少数能直接指向原因的原始材料。也正因为如此,评论数据的价值密度最高,常见用法里的系统性错误也最集中——只看平均分,或者只读商品页默认展示的几条评论,就据此判断一个产品的问题所在。
本篇给出一套完整的处理方法,并给出严格的执行顺序:第一步,拉取某个 ASIN 的全量评论语料,而不是抽样;第二步,先计算星级分布,而不是先看平均分;第三步,切出 1–3 星的差评子集并做主题聚类;第四步,把主题簇翻译成产品与 Listing 的具体改动。顺序不可颠倒:没有全量语料,分布就是估计;没有分布,差评子集就没有分母;没有聚类,改动就没有优先级。本篇是 C 组(按数据类型拆解的进阶任务)的一篇,处理的是评论这一种数据类型;商品详情、价格、变体等结构化字段的批量采集是另一项任务,见同组 C1《如何批量采集亚马逊商品详情》——评论回答”用户在抱怨什么”,商品数据回答”市场在卖什么”,两个语料拼在一起才构成完整的竞品画像。
一、先纠正一个前提:平均分会系统性地掩盖分布
平均分是把序数尺度(1 至 5 星)当作等距数值求均值的结果,它的第一个问题是同分不同形。设想两个平均分同为 4.3 的商品:甲的评论集中在 4 星与 5 星,1 星占比很低,这意味着产品整体达标、只有零星不满;乙的评论呈双峰分布,5 星占多数,但 1 星也占了相当比例,这意味着产品对一部分用户很好、对另一部分用户存在某种系统性失败。两个 4.3 的最优应对完全不同:甲需要的是渐进改良,乙需要的是找到那批 1 星用户共同的失败场景。平均分把这两种形态压成同一个数字,决策所需的信息在压缩中丢失了。
第二个问题是前台展示不是随机样本。商品页默认展示的评论经过平台排序(通常是”最有帮助”优先),排序依据是其他用户的投票行为,与评论总体的分布无关。只读前两页评论得出的”用户主要在抱怨 X”,本质上是排序算法与投票行为共同筛选后的结果,存在系统性偏差,不能外推到全体。
第三个问题是时效错位。页面上的平均分是商品全生命周期评论的累计均值:一次改版、一次换供应商、一个批次的质量波动,都会被数年的历史评论稀释到几乎看不见。而运营真正要回答的问题是”现在这批货好不好”——累计平均分对这个问题天然滞后。这也是本篇方法始终以”带日期的全量语料”为起点的原因:只有带时间维度的分布,才能把当前产品从它的历史里分离出来。
由此得到本篇的第一个结论:评论分析的合法起点是全量语料上的星级分布。平均分可以看,但只能在看完分布之后看;前台的热门评论可以读,但只能当作个案材料,不能当作统计结论。
二、第一步:拉取全量语料,而不是抽样
2.1 什么是”全量”,以及为什么抽样不够
本文所称全量,是指在固定的采集条件下(站点、语言、排序口径、采集时点),把某个 ASIN 的全部评论页逐页拉完,形成一份带完整分母的语料。抽样之所以不够,有两个理由。其一,差评主题是长尾分布:高频抱怨固然重要,但低频抱怨中常藏着严重度最高的问题(例如涉及安全、损坏、完全不可用的情形),抽样会系统性地漏掉长尾。其二,分布估计需要分母:后文所有占比——差评率、各主题在差评中的占比——都以评论总量为分母,抽样只能给出带误差的估计,且误差大小取决于抽样方式是否真正随机,而平台排序下的”前 N 页”根本不是随机抽样。
2.2 语料的字段清单
一次合格的评论拉取,每条记录至少应包含以下字段;缺少关键字段的语料,后续分析会被迫降级。
| 字段 | 用途 |
|---|---|
| 评论 ID | 去重与增量更新的唯一键 |
| 星级(1–5) | 分布计算与差评子集切分 |
| 标题与正文 | 主题聚类的分析对象 |
| 评论日期 | 时间切分:区分持续性问题与批次性问题 |
| Verified Purchase 标记 | 区分真实购买者反馈与非购买评论的权重参考 |
| 所购变体 | 把抱怨定位到具体规格(尺寸、颜色、型号) |
| Helpful 票数 | 个案阅读时的参考,不作为统计权重 |
| 站点与语言 | 记录采集条件,保证口径可复现 |
2.3 完整性校验
拉取完成后做三项校验:一是页数对齐——实际拉取页数与接口返回的总页数一致,中途失败的页必须补拉而不是跳过;二是去重——按评论 ID 去除分页边界可能产生的重复记录;三是缺失标记——个别评论缺少变体或日期字段时,保留记录并标记缺失,而不是整条丢弃(丢弃会改变分母)。工程实现上,这类拉取通常通过评论 API 按页完成:调用方逐页请求、本地落盘、按 ID 合并,采集条件(站点、时点)随语料一并存档。
2.4 语料的保存与增量更新
语料是后续一切分析与监控的底座,保存方式决定它能否复用。三条规则:其一,存原始记录——字段原样落盘,采集阶段不做筛选与改写,分析口径日后变化时不需要重新采集;其二,存采集日志——每次拉取的站点、时点、页数、失败与补拉情况随语料归档,这是日后解释”两次结果为什么不一致”的唯一依据;其三,增量按 ID 合并——后续拉取只追加新评论、刷新已有评论的票数等可变字段,不整表重采。按这三条维护的语料,才能支撑第七节的持续监控——监控的本质,就是同一口径的语料在时间上的延续。
三、第二步:先算星级分布,再切出差评子集
3.1 分布先行
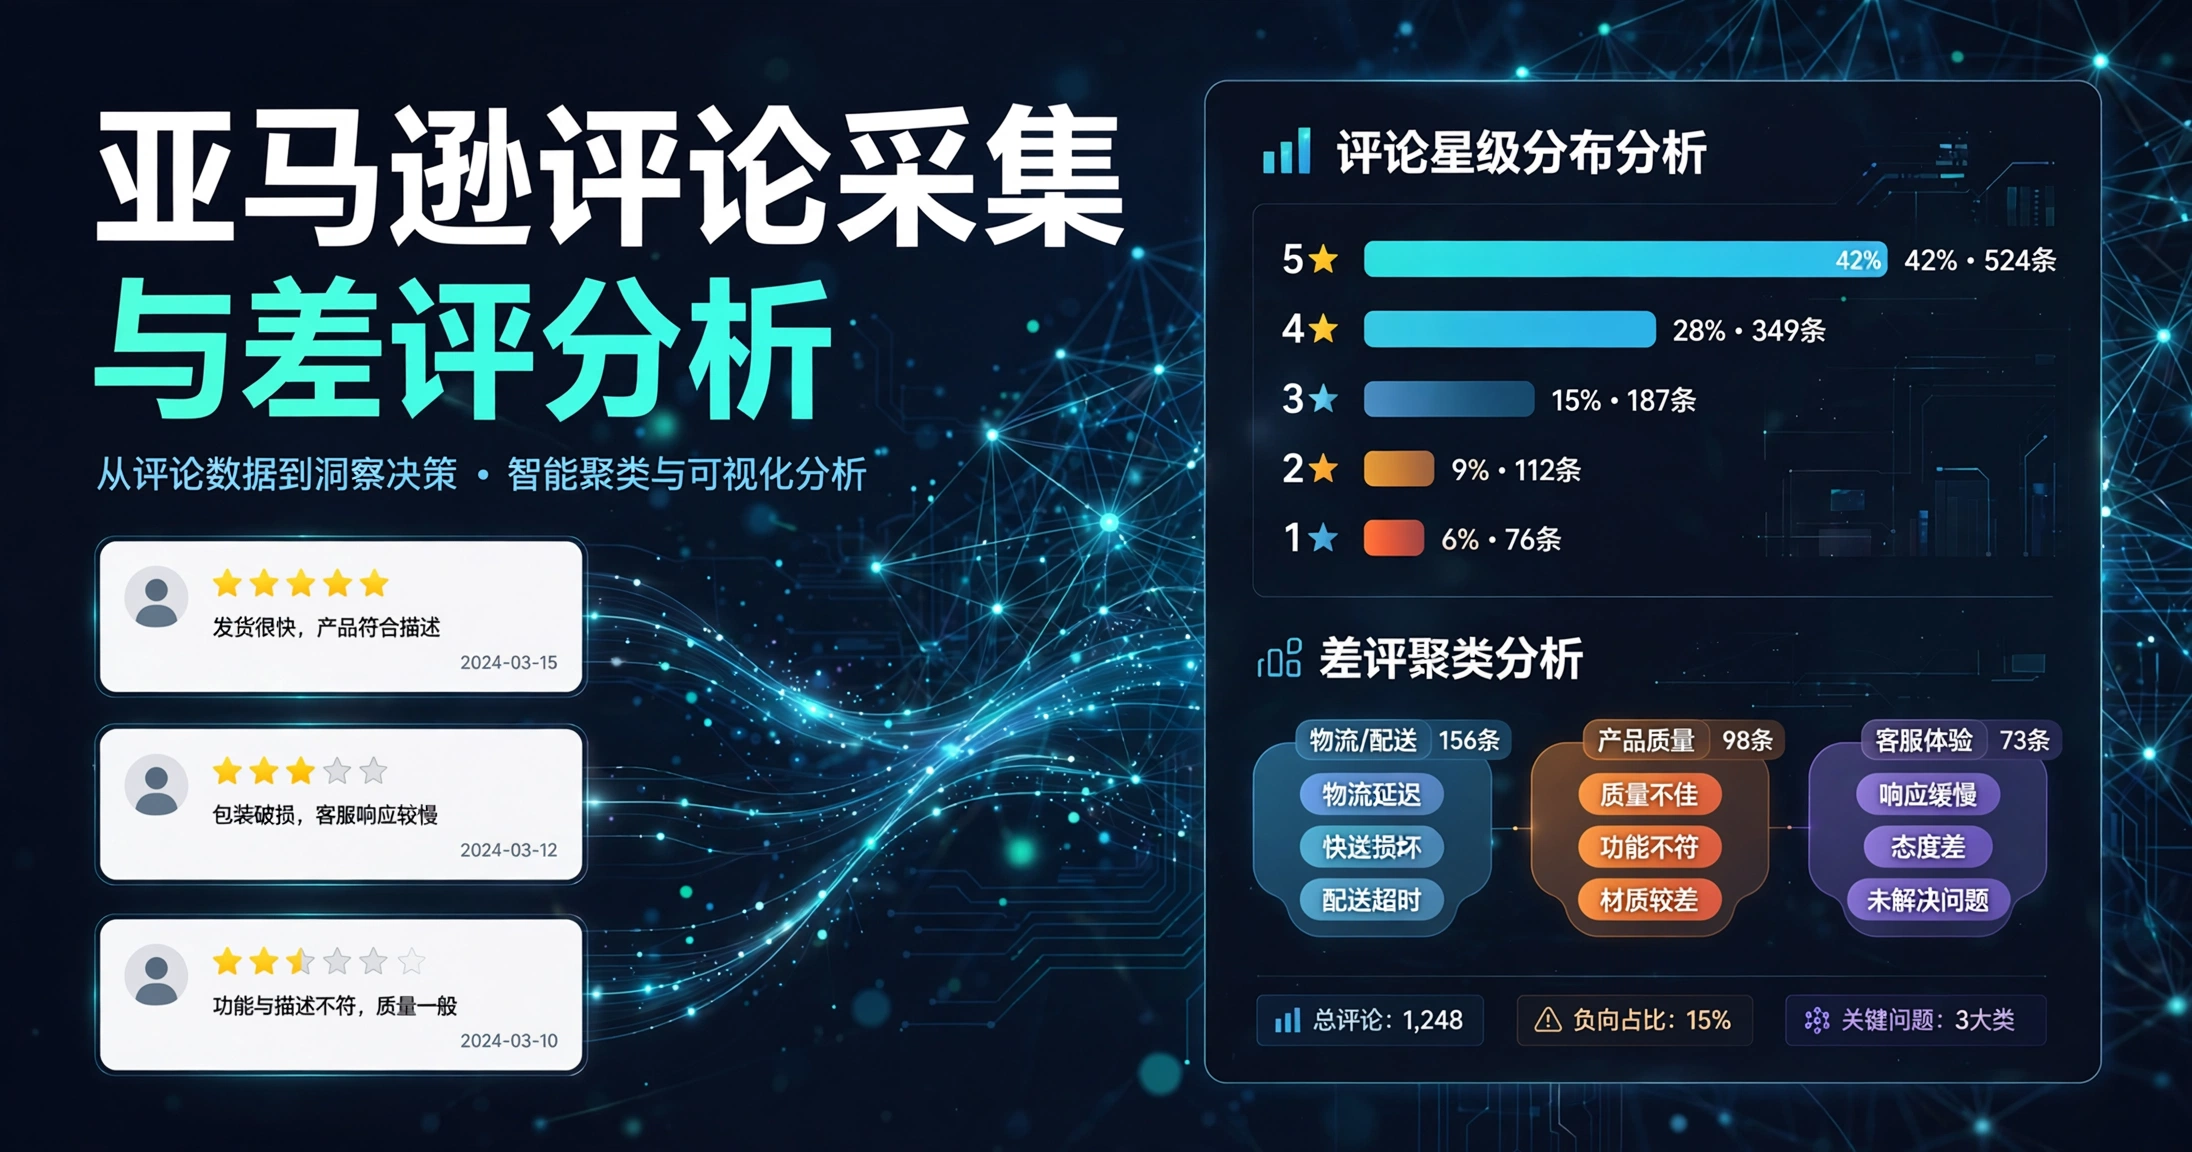
拿到全量语料后,第一件计算不是平均分,而是各星级的计数与占比。这张分布表回答三个问题:满意侧(4–5 星)与不满意侧(1–2 星)各占多少;中间层(3 星)有多厚;整体形态是单峰、双峰还是均匀分布。本文把 1–3 星定义为差评子集(critical),需要说明 3 星的归属理由:3 星在量表上是中点,但在文本上绝大多数 3 星评论都包含具体抱怨——”东西不错,但是……”,抱怨部分正是差评分析的对象。把 3 星排除在外,会系统性漏掉”总体接受、单点不满”这一类最可修复的问题。
3.2 实测案例:一组可复核的数字
以下数字来自一次真实测量,标注口径与日期以便复核与引用:2026 年 10 月 12 日,以 Pangolinfo Review API 拉取 AirPods Pro 3(ASIN:B0FQFB8FMG,美国站)的评论语料,共 4,268 条;其中 1–3 星差评 1,392 条,占全量语料的 32.6%。这是一个时点测量,评论总量随时间持续增长,当前数字必然已经变化;可复核的是方法与口径,而不是这个静态数值本身。
这组数字说明的问题在于:接近三分之一的评论落在差评区间,这是一个仅看平均分永远得不到的判断。无论该商品页面显示的平均分是多少,”每三条评论约有一条是明确的负面或中性偏负面反馈”都意味着差评子集大到值得逐条处理——1,392 条差评不是抽查几条就能概括的样本量,它需要的是下一节的系统性聚类。
四、第三步:对差评子集做主题聚类
4.1 编码:把文本变成可计数的主题
主题聚类在方法上是内容编码:逐条阅读差评,为每条标注一个或多个主题标签,再按标签计数。编码规则有三条。第一,一条评论可多标。一条差评同时抱怨佩戴与续航是常态,强制单标会人为压低次要主题的计数。第二,主题从数据中归纳,而不是预先写死。可以准备一个起始码本作为脚手架,但读到无法归类的抱怨时,正确动作是新增或拆分主题,而不是硬塞进最近似的类别。第三,同义合并。措辞不同、指向同一问题的抱怨必须归入同一主题,否则计数会被表述差异稀释。
以编码动作为例(以下为方法示例,非上述实测案例的结论):一条写着”戴两个小时耳朵就疼”的差评,编码为”佩戴舒适度”;一条写着”地铁里老是断连”的差评,编码为”连接稳定性”。编码完成后,每个主题得到两个数:命中条数,以及占差评子集的比例。分母必须用差评子集而不是评论总量——主题占比回答的是”在不满的用户里,多少人在抱怨这一件事”,换错分母,优先级排序就会失真。
4.2 加上时间维度
只算总计数会掩盖问题的性质。把主题计数按评论日期切分(按月或按季),每个主题会出现两种形态:持续性主题——各时段占比稳定,通常指向产品设计或定位层面的固有问题;批次性主题——在某时段集中出现又消失,通常指向某个生产批次、某次固件更新或某轮促销带来的人群变化。两者的应对完全不同:前者进产品迭代清单,后者先查批次与变更记录。用总计数把它们混在一起,会把最有价值的归因线索平均掉。
4.3 工具辅助的边界
关键词规则与大模型可以辅助初筛与预编码,在上千条差评时显著降低人工通读成本,但有两步不能外包:主题的命名与合并必须经人工复核,自动聚类很容易生成听起来合理、实际并不存在的主题,或把两个不同的问题并成一个;抽样回读不可省略——每个主题随机抽回若干条原文,确认编码无误后再采信计数。自动工具负责规模,人工负责口径,这是本节的结论。
五、第四步:把主题簇翻译成行动
聚类的终点是改动清单。翻译的方法是先判断每个主题簇的问题性质,再落到对应的责任侧:
| 问题性质 | 典型表现 | 产品侧动作 | Listing / 内容侧动作 |
|---|---|---|---|
| 产品缺陷 | 耐久、性能、做工类抱怨跨时段稳定出现 | 进入产品迭代与品控清单,按严重度排期 | 在页面上如实说明能力边界,避免继续制造预期落差 |
| 预期落差 | 抱怨点与宣传卖点直接冲突,用户觉得”被骗了” | 复核卖点是否有实测依据 | 修正文案与主图说明,删除或限定无法兑现的表述 |
| 使用门槛 | 产品没坏,但用户不会设置、不会用 | 降低上手成本,改进说明书 | 在页面与 Q&A 中预埋操作说明与排查步骤 |
| 适配问题 | 尺寸、型号、兼容性选错导致的差评 | 增加变体区分度 | 补适配表与选购指引,把选错挡在下单之前 |
改动排序用一个简单的优先级函数:频次 × 严重度 × 可修复性。频次来自聚类计数,严重度看抱怨是否涉及不可用、安全与退货,可修复性看问题能否在当前产品上解决。四类问题里,”预期落差”与”使用门槛”通常是优先级最高的:它们频次不低,且不需要改产品——改页面就能解决,今天就能动手。产品缺陷类频次再高,也要走迭代周期,它的正确出口是立项而不是改文案。最终产出物应包含三样:主题排行榜(带计数与占比)、每个主题的代表性原话(供团队直接感受问题)、按优先级排好的改动清单。
清单交付不是终点。改动上线后,要用同一套口径复测一次:对应主题在新增评论中的占比是否下降,是判断改动有效的唯一标准。页面改了、产品也改了,但差评主题纹丝不动,说明翻译环节出了问题——改的不是用户抱怨的那个点——而不是”用户还没注意到”。这一步复测同时为第七节的监控提供基线:没有基线分布,监控阈值就无从设定。
六、成本口径:按页计费与免费档的边界
评论 API 的计费方式决定了这项工作的成本结构,必须事先算清。Pangolinfo 的评论接口按页计费,每页 5 点;免费档为每月 60 点、按月重置,折算 12 页。这组数字划出两条清晰的边界:免费档足够完成一次采样验证——挑一个小评论量的 ASIN 或一个大 ASIN 的头部页数,把字段口径、拉取流程、聚类方法先跑通;全量语料通常需要付费档——热门 ASIN 的评论动辄数千条、对应数百页,12 页的免费额度在数学上不可能覆盖,这不是额度设计的问题,而是”全量”二字的必然成本。正确的路径是:先用免费档验证流程与口径,再按目标 ASIN 的评论规模估算页数,最后再决定付费档的规格——而不是反过来,先买额度再想采什么。
七、从一次性分析到持续监控
本篇的方法产出的是一张时点快照,但差评不是静态资产:新批次上市、固件更新、竞品降价,都会在评论里长出新主题,老主题也会消长。一次性分析回答”现在的问题是什么”,回答不了”问题正在变好还是变坏”。因此完整的闭环是:用本篇的方法做出第一次全量分析、建立主题码本与基线分布,之后接入定时监控——按固定周期增量拉取新评论、按同一码本自动计数、主题占比越过阈值时告警。监控环节的实操(n8n 定时工作流、增量拉取与告警配置)已有一篇先行发布的实操文:《用 n8n 搭建亚马逊评论定时监控》。分析定基线,监控看变化,两者共用同一套字段与码本——这是评论数据从”一次性报告”变成”常设管道”的最后一步。
本文属于《亚马逊数据采集完全指南》系列——支柱页《亚马逊数据采集完全指南:从入门到精通(2026 版)》给出全部数据类型的地图、四级路线图与各子篇入口;本篇是其中 C 组的一篇,负责评论这一种数据类型的完整处理方法。