
1. 执行层:为什么 n8n 为这个系列收尾
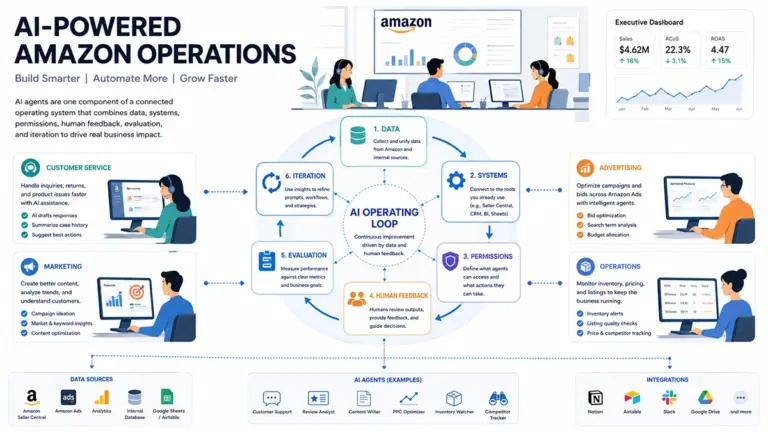
这个系列的前五篇在不同的房间里回答了同一道题:agent 怎样摸到实时 Amazon 数据?Meta Muse 走了自定义连接器,Claude Code 走了 --header 参数,ChatGPT 走了开发者模式 Token,Workbuddy 走了 Skill 市场,IDE agent 走了编辑器内 skill。它们都有一个共同前提:聊天窗口前坐着一个人,在提问。
n8n 把这个人拿掉了。它是无人值守的执行层:按定时醒来、拉数据、做判断、发通知——在你睡觉的时候。如果说总纲论证的是 agent 为什么需要实时商业数据(总纲),这一篇回答的是没人盯着的时候,谁去跑腿。
先把诚实声明放在前面:Pangolinfo 没有原生 n8n 节点,ScrapeHero 在 2026 年 9 月已经有了。下面是通用的、完整可用的路径——定时触发器 + HTTP Request + 凭证管理,不宣称比原生集成更强。它的赢面在另一个维度:跑的正是本系列自 10 月 12 日以来一直在测量的那套投诉挖掘协议,只不过是自动的。
2. Pattern 1:定时评论挖掘 → 投诉预警
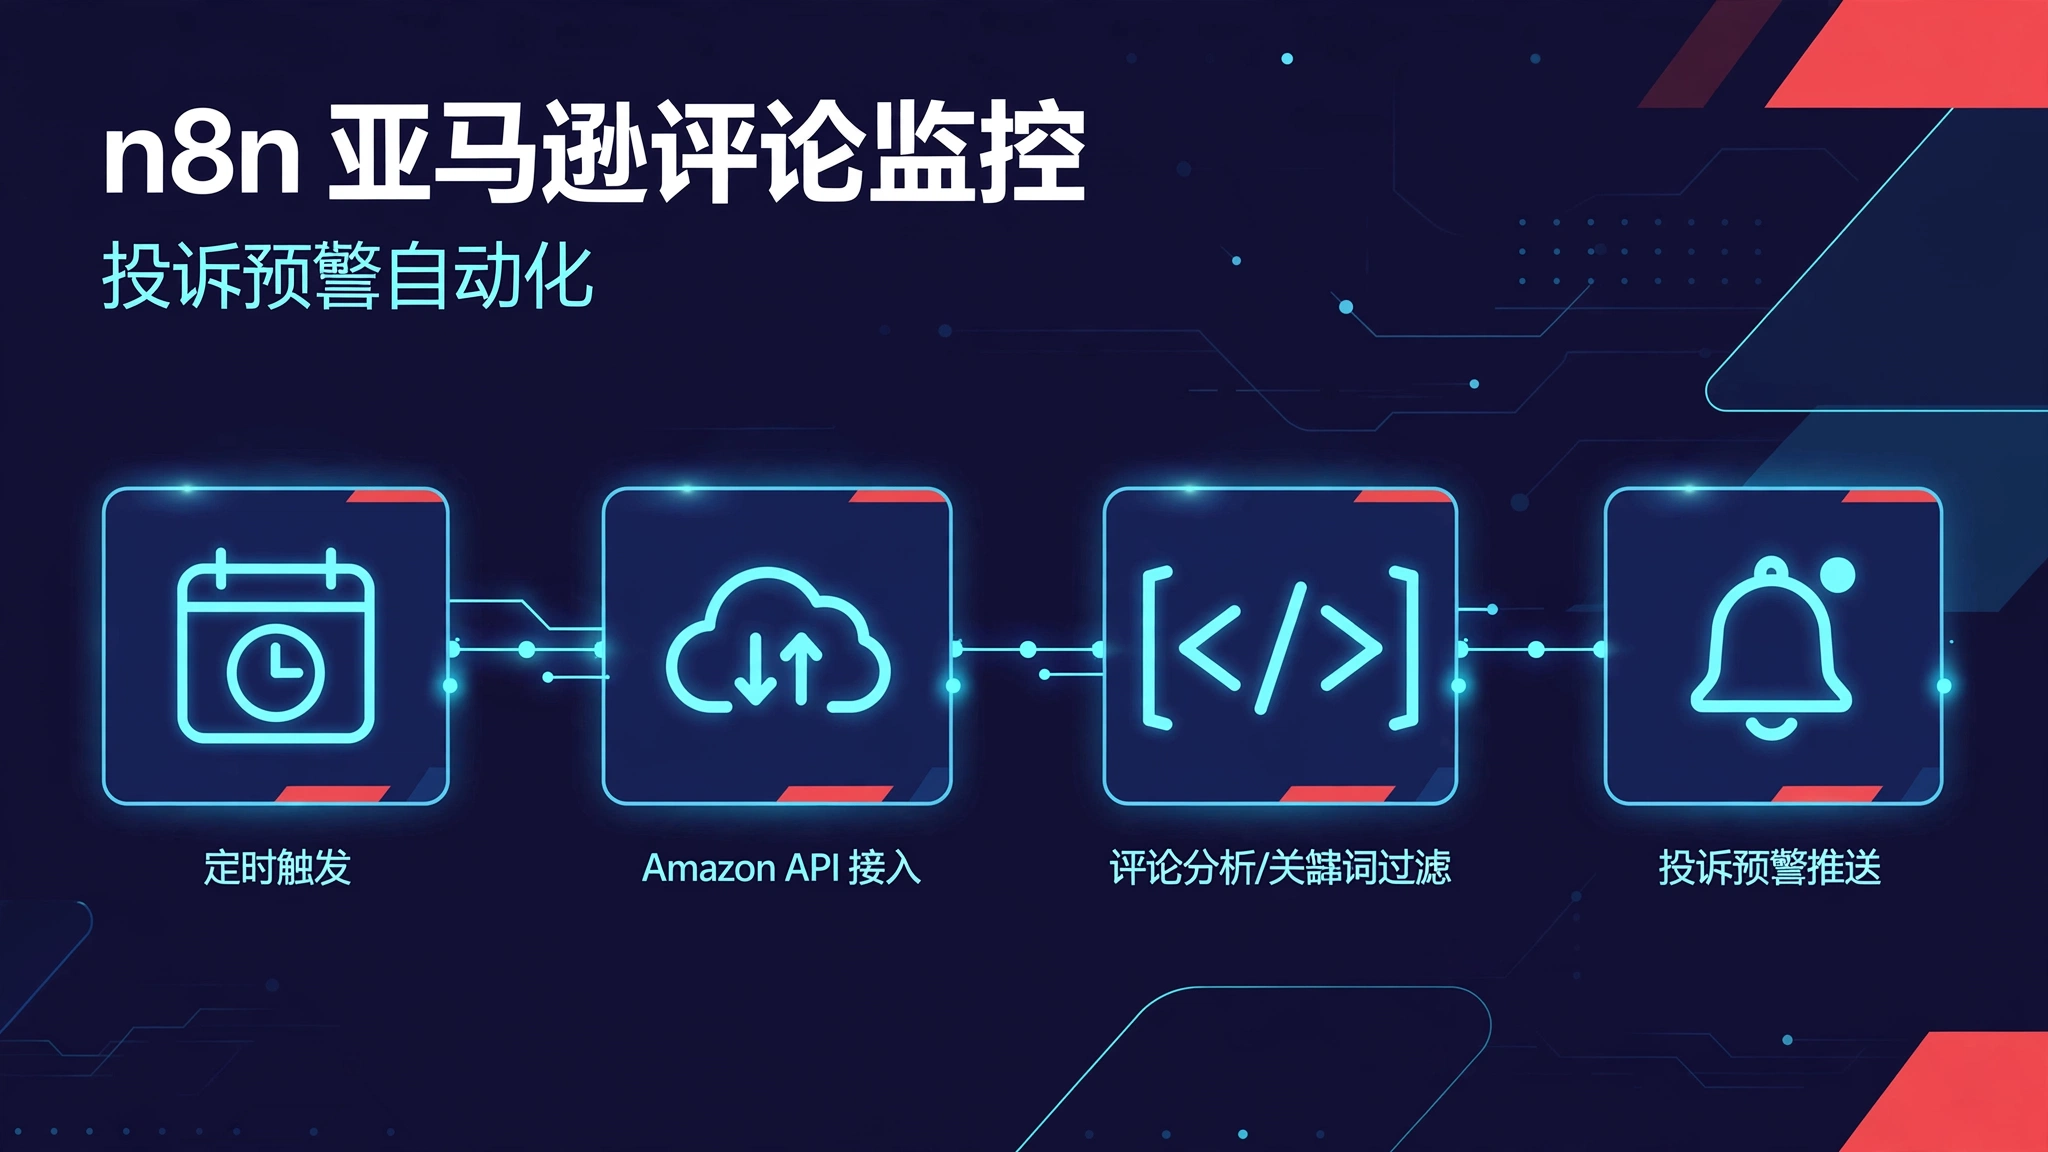
这是值得完整做出来的模式,因为它占着一个真实空位:n8n 监控亚马逊价格的模板一抓一大把,把亚马逊评论监控、做成投诉预警的完整指南几乎没有。工作流每天跑一次,拉取你 ASIN 的最新评论,按投诉主题给 1–2 星评论分类,记住已经见过的内容,只在出现新的差评时才 ping Slack,每次运行都归档到 Google Sheets。
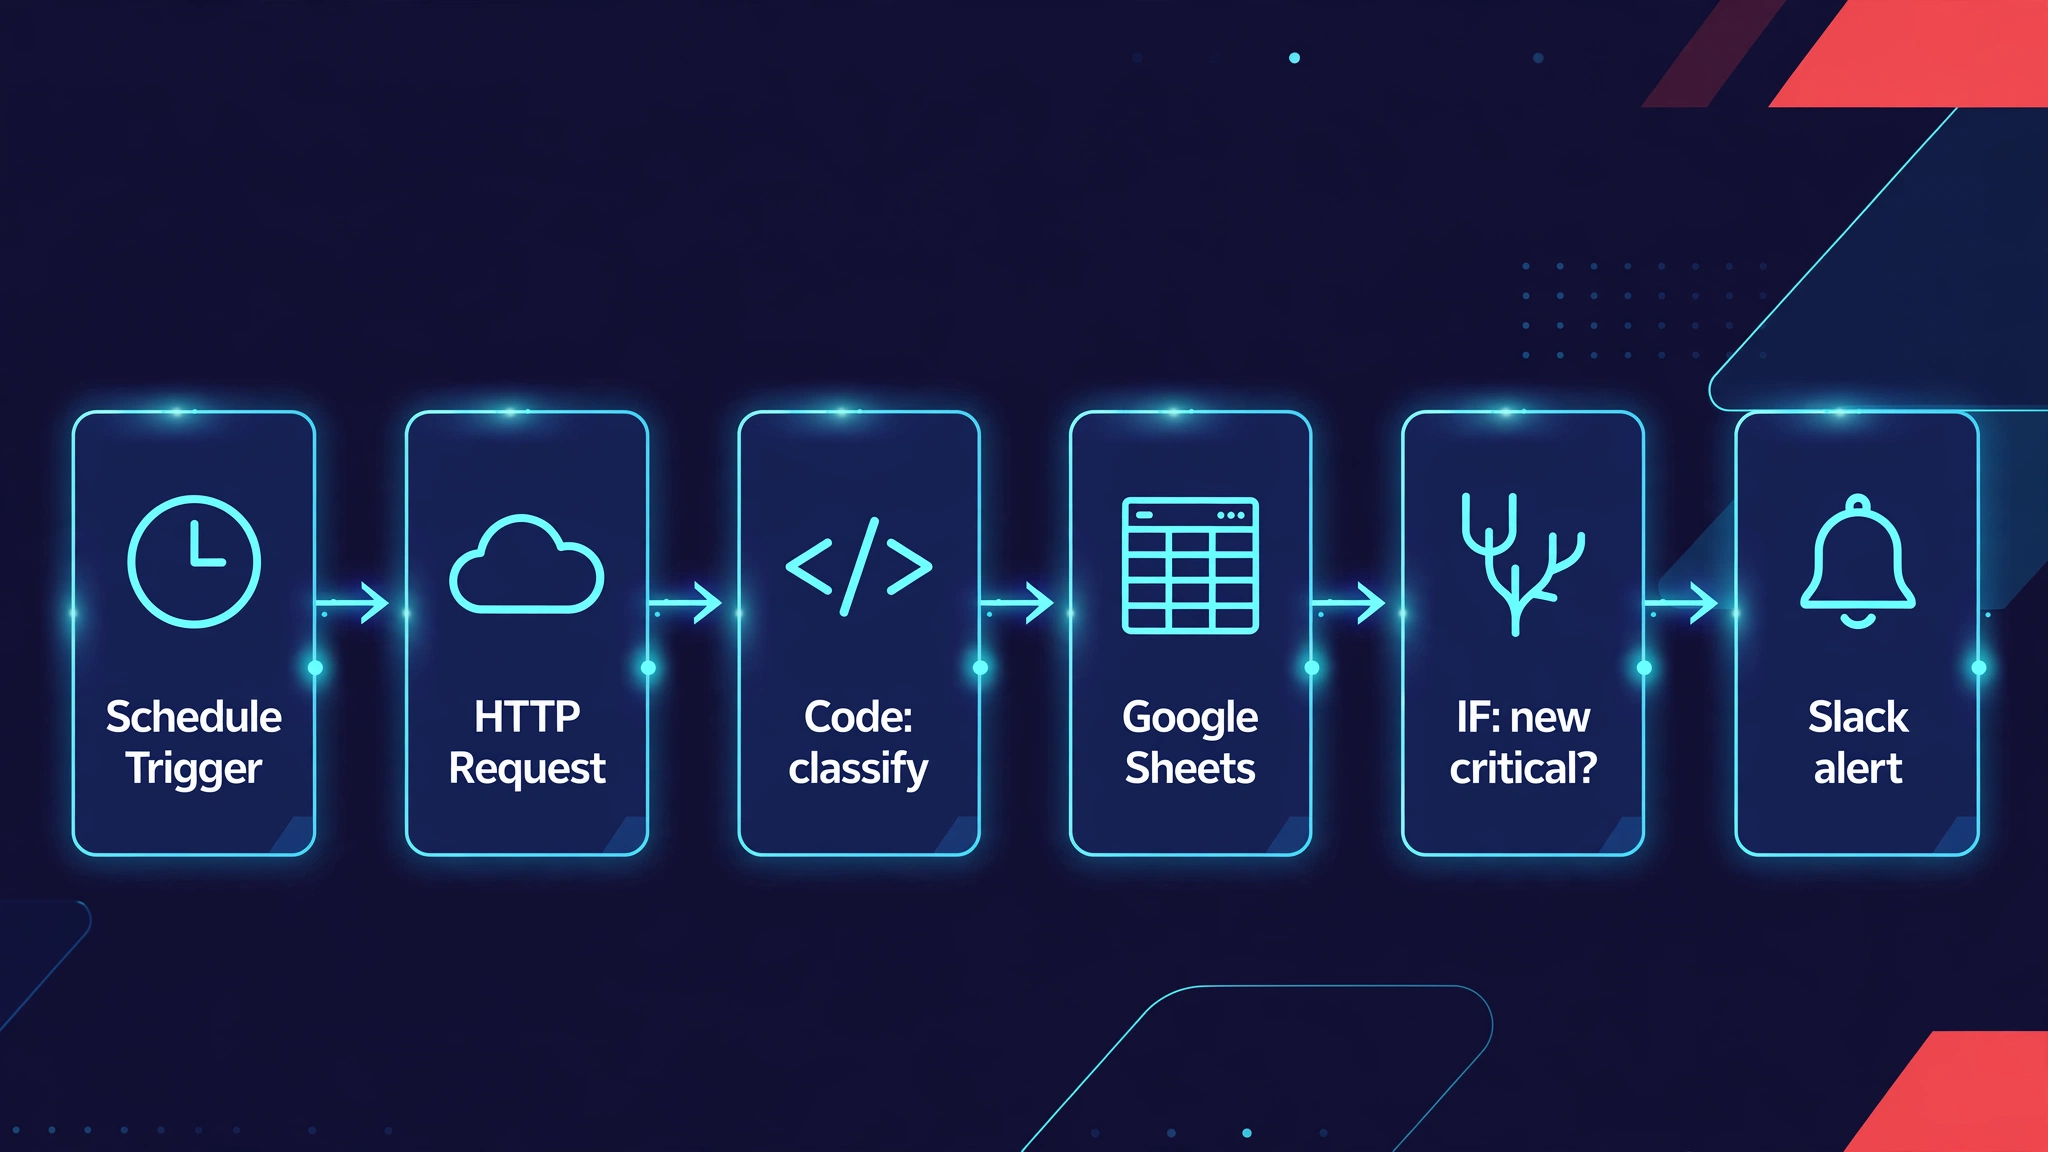
节点 1——Schedule Trigger:每天 02:00 UTC
频率是设计决策,不是默认值。评论按天累积,亚马逊评论页在美国时间的后半夜趋于稳定,更重要的是——每多跑一次都是 API 点数(第 4 节算账)。每天 02:00 UTC 是本系列的既有测量协议:同一时间、同一批 ASIN,数字才可比。
节点 2——HTTP Request:Pangolinfo 评论调用
没有原生节点,这个节点就是集成。配置:
- Method: POST —— URL:
https://scrapeapi.pangolinfo.com/api/v1/scrape - Authentication: Generic Auth Type → HTTP Header Auth。新建一个叫
Pangolinfo Bearer的凭证:Name 填Authorization,Value 填Bearer <你的token>。key 只活在凭证里,不进工作流 JSON,不进表达式。 - Body(JSON):
{
  "url": "https://www.amazon.com/product-reviews/B0FQFB8FMG",
  "parserName": "amzReview",
  "format": "json"
}
parserName: amzReview 选中评论解析器;format: json 返回结构化数据(按文档的格式计费,json 为每次请求 1 credit)。ASIN 多了就复制这个节点或在外面套循环——蓝图里只留一个 ASIN,让 JSON 保持可读。
返回包长这样(字段名已对官方文档核实):
{
  "code": 0, "message": "ok",
  "data": { "json": [ { "code": 0, "data": {
      "reviews": [
        { "reviewId": "R12W2XCCBZMJK9", "title": "...", "content": "...",
          "star": "5.0 out of 5 stars", "author": "DJPizzaboi",
          "date": "July 20, 2025", "helpful": "4 people found this helpful",
          "purchased": true, "vineVoice": false, ... }
      ] } } ],
    "url": "...", "taskId": "..." }
}
下游 Code 节点读的是 data.json[0].data.reviews,这条路径是整个工作流依赖的契约。
节点 3——Code:分类,还要记住
这个节点干 HTTP 节点干不了的两件事:判定什么算投诉,以及记住已经告警过的内容,避免同一条评论 ping 你两次。Code 节点设为 “Run Once for All Items”,粘贴:
const staticData = $getWorkflowStaticData('global');
const seen = staticData.seenReviewIds || {};

const THEMES = [
  { id: 'noise',   label: '降噪/音质', kws: ['noise', 'anc', 'sound quality', 'hiss', '降噪', '音质'] },
  { id: 'pairing', label: '配对/连接', kws: ['pair', 'connect', 'bluetooth', 'drop', '配对', '连接'] },
  { id: 'battery', label: '电池/续航', kws: ['battery', 'charge', 'drain', 'dies', '电池', '续航'] },
  { id: 'compat',  label: '兼容性',   kws: ['compatib', 'not work with', 'ipad', 'iphone', '兼容'] },
  { id: 'defect',  label: '故障/品控', kws: ['broke', 'stopped working', 'defect', 'dead on arrival', '故障'] },
];

const results = [];
for (const item of $input.all()) {
  const payload = item.json?.data?.json?.[0]?.data || {};
  const reviews = payload.reviews || [];
  const asin = payload.asin || 'B0FQFB8FMG';
  const seenIds = new Set(seen[asin] || []);
  const fresh = [];

  for (const r of reviews) {
    const id = r.reviewId || `${r.author}-${r.date}`;
    if (seenIds.has(id)) continue;
    seenIds.add(id);
    if (!/^([12])\.0/.test(String(r.star || ''))) continue; // 只收 1–2 星
    const text = `${r.title || ''} ${r.content || ''}`.toLowerCase();
    const themes = THEMES
      .filter(t => t.kws.some(k => text.includes(k.toLowerCase())))
      .map(t => t.label);
    fresh.push({
      reviewId: id, date: r.date, star: r.star, author: r.author,
      title: r.title, helpful: r.helpful, verified: r.purchased, themes,
    });
  }
  seen[asin] = [...seenIds];
  results.push({
    json: {
      asin,
      newCritical: fresh.length,
      totalScanned: reviews.length,
      themes: [...new Set(fresh.flatMap(f => f.themes))],
      samples: fresh.slice(0, 5),
    },
  });
}
staticData.seenReviewIds = seen;
return results;三处值得注意。第一,星级过滤用的是文档原文格式的正则("5.0 out of 5 stars")——1–2 星算投诉,其他的对这个工作流都是噪音。第二,verified: r.purchased 把 verified purchase 标记一路带下来,因为已验证购买用户的投诉权重更高。第三,去重记忆用的是 n8n 自带的 $getWorkflowStaticData('global')——工作流级持久化,”只告警新内容”不需要另搭数据库。
一个真实的坑,写下来是因为一定会踩到:Code 节点里没有 fetch。如果你的 Code 节点自己要调 HTTP,用 require('https')。这里不需要——HTTP Request 节点已经把请求发完了。
节点 4——Google Sheets:每次运行都归档
只追加不修改,一行一次运行:日期、ASIN、扫描数、新增差评数、主题、样例标题。这是最不性感但决定工作流半年后还可信的部分——当有人问”配对投诉从什么时候开始的”,答案是一个筛选器,不是一段回忆。
节点 5——IF:有新的坏消息吗?
条件:{{ $json.newCritical }} 大于 0(数字)。真 → Slack;假 → 结束。工作流按设计是安静的,沉默才是它的正常输出。
节点 6——Slack:告警
发到你的频道(Slack 凭证建一次):
🚨 {{ $json.newCritical }} 条新增差评 — {{ $json.asin }}
主题:{{ $json.themes.join('、') || '未分类' }}
典型:"{{ $json.samples[0].title }}"({{ $json.samples[0].star }},{{ $json.samples[0].helpful }})
换成 Telegram、邮件或 webhook 都行,决策逻辑不在乎。
可导入的工作流
上面六个节点,打包成 JSON(工作流 → Import from JSON)。先建好 Pangolinfo Bearer header 凭证和 Slack/Sheets 凭证,sheet ID 换成你自己的。typeVersion 对应 n8n 1.x,导入时如果提示升级节点,点接受。
{
  "name": "Pangolinfo Amazon Review Complaint Alerts",
  "nodes": [
    {
      "parameters": { "rule": { "interval": [{ "field": "hours", "hoursInterval": 24 }] } },
      "id": "n8n-schedule-1",
      "name": "Daily 02:00 UTC",
      "type": "n8n-nodes-base.scheduleTrigger",
      "typeVersion": 1.2,
      "position": [240, 300]
    },
    {
      "parameters": {
        "method": "POST",
        "url": "https://scrapeapi.pangolinfo.com/api/v1/scrape",
        "authentication": "genericAuth",
        "genericAuthType": "httpHeaderAuth",
        "sendBody": true,
        "specifyBody": "json",
        "jsonBody": "={\n  \"url\": \"https://www.amazon.com/product-reviews/B0FQFB8FMG\",\n  \"parserName\": \"amzReview\",\n  \"format\": \"json\"\n}",
        "options": { "timeout": 60000 }
      },
      "credentials": { "httpHeaderAuth": { "id": "", "name": "Pangolinfo Bearer" } },
      "id": "n8n-http-1",
      "name": "Fetch Reviews (Pangolinfo)",
      "type": "n8n-nodes-base.httpRequest",
      "typeVersion": 4.2,
      "position": [460, 300]
    },
    {
      "parameters": { "mode": "runOnceForAllItems", "jsCode": "/* 粘贴上文节点 3 的分类代码 */" },
      "id": "n8n-code-1",
      "name": "Classify & Delta",
      "type": "n8n-nodes-base.code",
      "typeVersion": 2,
      "position": [680, 300]
    },
    {
      "parameters": {
        "resource": "sheetWithinDocument",
        "operation": "append",
        "documentId": { "__rl": true, "value": "YOUR_SHEET_ID", "mode": "id" },
        "sheetName": { "__rl": true, "value": "review_alerts", "mode": "name" },
        "columns": {
          "mappingMode": "defineBelow",
          "value": {
            "date": "={{ $now.toISO() }}",
            "asin": "={{ $json.asin }}",
            "scanned": "={{ $json.totalScanned }}",
            "new_critical": "={{ $json.newCritical }}",
            "themes": "={{ $json.themes.join('; ') }}"
          },
          "matchingColumns": [],
          "schema": []
        },
        "options": {}
      },
      "id": "n8n-sheets-1",
      "name": "Archive to Sheets",
      "type": "n8n-nodes-base.googleSheets",
      "typeVersion": 4,
      "position": [900, 300]
    },
    {
      "parameters": {
        "conditions": {
          "options": { "caseSensitive": true, "leftValue": "", "typeValidation": "loose" },
          "conditions": [
            { "id": "cond-1", "leftValue": "={{ $json.newCritical }}",
              "rightValue": 0, "operator": { "type": "number", "operation": "larger" } }
          ],
          "combinator": "and"
        },
        "options": {}
      },
      "id": "n8n-if-1",
      "name": "New Critical?",
      "type": "n8n-nodes-base.if",
      "typeVersion": 2,
      "position": [1120, 300]
    },
    {
      "parameters": {
        "resource": "message",
        "operation": "post",
        "channel": "={{ 'YOUR_CHANNEL_ID' }}",
        "text": "=🚨 {{ $json.newCritical }} 条新增差评 — {{ $json.asin }}\n主题:{{ $json.themes.join('、') || '未分类' }}\n典型:\"{{ $json.samples[0].title }}\" ({{ $json.samples[0].star }}, {{ $json.samples[0].helpful }})",
        "otherOptions": {}
      },
      "id": "n8n-slack-1",
      "name": "Slack Alert",
      "type": "n8n-nodes-base.slack",
      "typeVersion": 2,
      "position": [1340, 220]
    }
  ],
  "connections": {
    "Daily 02:00 UTC": { "main": [[{ "node": "Fetch Reviews (Pangolinfo)", "type": "main", "index": 0 }]] },
    "Fetch Reviews (Pangolinfo)": { "main": [[{ "node": "Classify & Delta", "type": "main", "index": 0 }]] },
    "Classify & Delta": { "main": [[{ "node": "Archive to Sheets", "type": "main", "index": 0 }]] },
    "Archive to Sheets": { "main": [[{ "node": "New Critical?", "type": "main", "index": 0 }]] },
    "New Critical?": { "main": [
      [{ "node": "Slack Alert", "type": "main", "index": 0 }],
      []
    ] }
  },
  "active": false,
  "settings": { "executionOrder": "v1" }
}
3. Pattern 2:价格/BSR 快照——简短而诚实的版本
同一个 HTTP Request 节点换个 parser,就是定时价格快照:parserName: amzProductDetail、content: B0FQFB8FMG、site: amz_us、format: json → 把价格、评分、评论数追加进 Sheets。这个模式只给两段,是故意的:n8n 价格监控是红海。ScrapeHero 2026 年 9 月就上了原生 n8n 节点,Bright Data、ScrapeOps 都有官方模板,”定时拉取→比价→告警”的形状被写透了。想要原生节点体验,去评估他们的。这篇指南的贡献是通用 HTTP 路径能覆盖而模板覆盖不了的东西——从 Pattern 1 开始。
4. 调度 × 额度:先算账,再自动化
自动化把成本乘以频率。公式:
每月消耗 ≈ ASIN 数 × 每天次数 × 30 × 单次 credit
| 配置 | 每天请求 | 每月请求 | 按文档 json 计费(1 credit/次) | 60 免费档够吗 |
|---|---|---|---|---|
| 3 个 ASIN × 每天 1 次 | 3 | 约 90 | 约 90 credits | 不够 → 降到每周 2 次(约 24/月)或升级套餐 |
| 1 个 ASIN × 每天 1 次 | 1 | 约 30 | 约 30 credits | 够,还有余量 |
两个诚实脚注。第一,上面的单价是文档里 format: json 的计费;评论解析的实际扣费以你的控制台账单为准——我们经 MCP 侧实测评论是 5 credits/页,所以先按高估算,跑出第一张账单再调频率。第二,免费档按月重置(每月 60 credits),第一个月跑得下的配置,每个月都跑得下。
5. n8n 做不到的三件事
三条边界,说清楚免得工作流被寄予它做不到的期望。它不是实时的。定时就是定时——投诉预警按天是合理默认;分钟级轮询技术上可行,主要是烧点数的办法。它不解决反爬。验证码、IP 轮换、解析器维护都在 API 那一侧;n8n 只负责定时和凭证。它没有 Pangolinfo 原生节点——该不该有是 roadmap 议题,不是本指南的承诺。至于 agent 为什么需要实时数据——整个系列立足的论证——在总纲,不在这一页。
6. 验证状态:查过什么,没查什么
✅ REST 合约——端点(POST https://scrapeapi.pangolinfo.com/api/v1/scrape)、parser 名(amzReview、amzProductDetail)、header 鉴权形态、format: json 计费、评论字段名(reviewId、star、helpful、purchased…)——2026-10-19 已对官方文档核实。 ✅ 引用数字(AirPods Pro 3,美区,截至 2026-10-12 共 4,269 条评论、差评 1,392 条)是本系列既有的 MCP 实测,非编造。 ✅ 红海判断——ScrapeHero 原生 n8n 节点(2026-09)、Bright Data / ScrapeOps / Crawlbase 模板——来自 2026-10-14 SERP 侦察。 ⚠️ 上面的 workflow JSON 未在我们团队的 n8n 实例里真实执行过。导入后先手动跑一次,看 Code 节点的输出,再开定时。 ⚠️ 评论分页与筛选参数以文档最新版为准,多页循环开工前先确认。节点 typeVersion 对应 n8n 1.x,导入时如提示升级,接受即可。
7. 相关阅读
- AI Agent 接入实时 Amazon 数据完全指南(总纲)——总纲:接地的论证与三种接入模式
- ChatGPT 接入实时 Amazon 数据完全指南(MCP)——有人在场的对照组:回路里有人确认时,工作流有何不同
- Amazon Review API——工作流背后的评论数据引擎
- Amazon Data MCP——同一份数据的对话侧:20 工具服务器
- Pangolinfo API 文档——本工作流所依据的 REST 合约
8. 系列导航
本指南是系列《AI Agent 接入实时 Amazon 数据完全指南(总纲)》的子篇。各篇:
- Meta Muse 篇——自定义 MCP 连接器,在 Muse 客户端内实测走通。
- Claude Code 篇——命令行、Desktop、网页端三条路径对照与鉴权面拆解。
- ChatGPT 篇——开发者模式自定义连接器(Token 鉴权);有人在场的对照组。
- Workbuddy 篇——Skill 生态路径:应用市场 Skill、MCP 连接器、Expert 组合对照。
- IDE agent 篇——编辑器内的 MCP 与 skill。
- n8n 篇——本篇:定时评论挖掘与投诉预警,无人值守的执行层。