
为什么要做评论挖掘
评论是卖家永远读不完的最大用户心声数据集。一个有 5,000 条评论的 listing,就是一份完整的产品需求文档——买家亲笔所写,还按”多少人觉得有用”排好了序。没人读,是因为没人读得完。
评论挖掘是把这份非结构化语料变成结构化信号:哪些产品维度被夸、哪些被骂、比例如何随时间变化、和竞品比处在什么位置。产出不是情感分数,是决策:先修哪个缺陷、主打哪个卖点、打竞品的哪个弱点。
三类需求驱动投入。产品团队要缺陷发现和路线图输入——投诉主题就是按频率排好序的 backlog。品牌运营要早期预警:新的缺陷模式出现在评论里,比出现在退货率里早几周。品类管理者挖竞品的评论,因为对手的 1 星主题是免费的产品拆解报告。
投诉检测的业务价值
如果评论挖掘是研究职能,投诉检测就是告警职能。它在评论流里盯四类失效信号:
- 缺陷爆发。某一批次出问题,描述同一故障模式的 1 星评论几天内扎堆。发现延迟决定了应对空间的大小:几天的提前量意味着改一句文案、打一个供应商电话;几周的延迟意味着退货潮,和一条永久压住转化率的 1 星长尾。
- 安全信号。”着火””烫伤””触电””窒息””过敏”这类词出现在评论里,是责任事件,不是产品反馈——要当天处理,不是等季度报告。
- 假货与质量漂移。自家 listing 下扎堆出现”和正品不一样””包装变了””有化学品气味”,可能是混仓假货,也可能是供应商悄悄换料。
- 差评攻击。未验证购买的 1 星突然放量、措辞雷同,和真实不满是两件事,应对方式也完全不同。
亚马逊自己在履约侧验证了这个逻辑:Project P.I. 用生成式 AI 和计算机视觉在发货前扫描商品缺陷,并用多模态大模型复盘客户反馈找根本原因(SiliconANGLE、Fast Company 2024 年报道)。卖家没有影像隧道,评论就是他们的传感器。
难点
评论是非结构化的。 评分是结构化的,信号不是。一条 3 星评论可能藏着关键缺陷报告(”能用,但把手烫得危险”);一条 5 星评论可能顺手投诉(”很喜欢,就是 App 老闪退”)。必须做方面级分析——文档级情感对产品决策几乎无用。
评分 ≠ 情感 ≠ 严重度。 三个变量独立运动。投诉检测要打的是严重度分,不是情感分:一条礼貌的 2 星”有起火隐患”,优先级高于一条暴怒的 1 星”物流太慢”。
刷单和激励评论是噪声。(已核实:官网 Review API 页确认返回 verified-purchase 状态与 helpful votes,并支持 Verified Purchase Filter) verified 购买标记和有用投票数是标准降噪器;未验证评论的突发要单独处理。
多语言现实。 美国站点的 listing 下有西班牙语评论,欧洲站点混五种语言。只为英文建的词典会把投诉整个漏掉。
亚马逊的反爬。 评论页是最难抓的目标之一:激进限流、验证码、布局常变。自建评论采集器,这笔维护税要一直交。
现有方案的短板
- SaaS 评论工具:只看你自己的 listing,看自家后台;没有程序化接口,更没有竞品 listing 的 API 级覆盖。
- 通用情感 API(云 NLP 服务):只会打极性分。它不知道”用了两周拉链坏了”对箱包卖家和对夹克卖家意味着什么——电商的方面语义是缺失的。
- 人工读:不可规模化、无记录、还只读到最新的而不是最有代表性的。
- 亚马逊品牌分析:覆盖的是你品牌的搜索词,不是评论语料,更没有竞品。
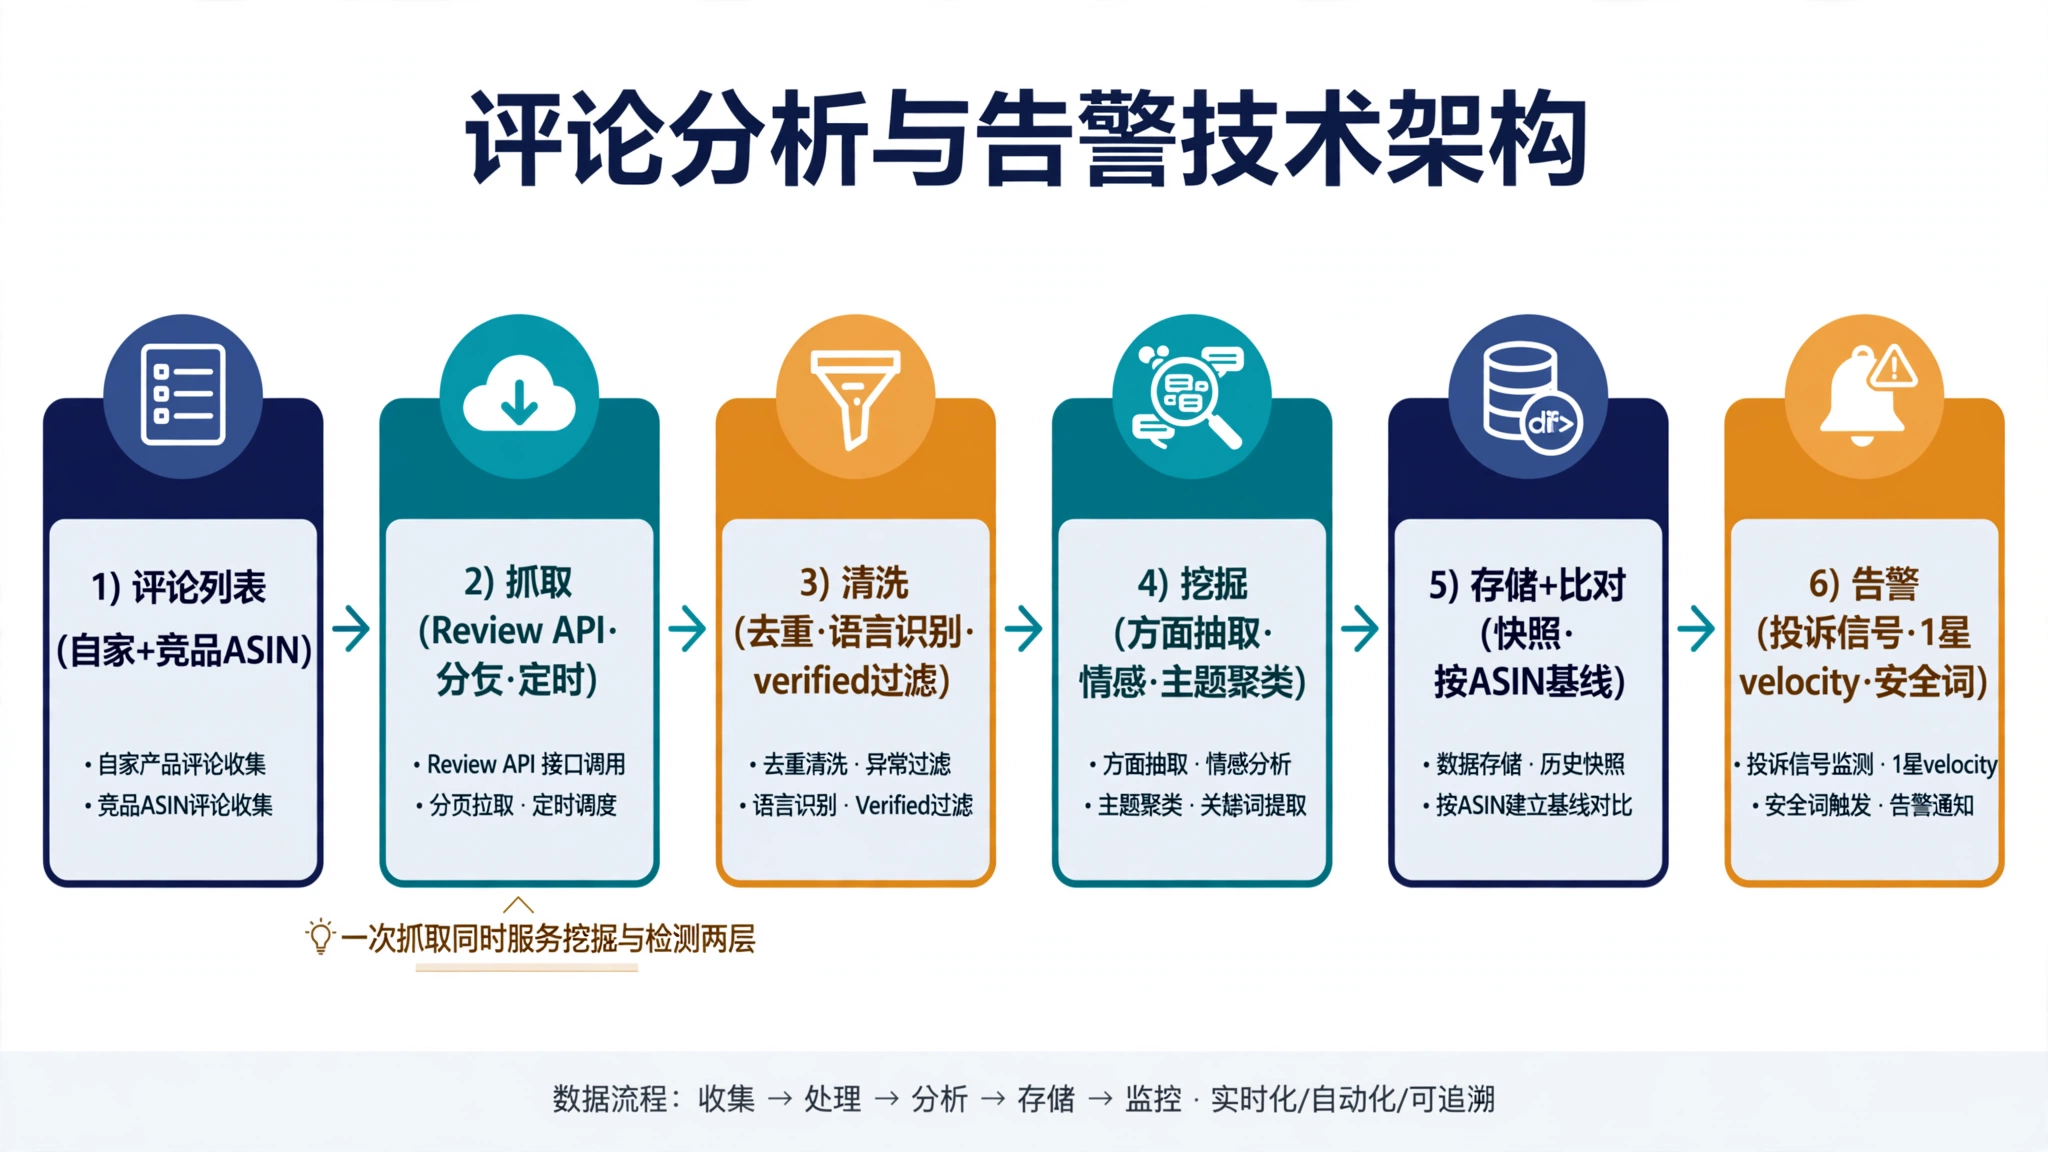
系统架构:抓取→清洗→挖掘→告警
评论列表(自家 ASIN + 竞品 ASIN)
        → 抓取(Review API,分页,定时)
        → 清洗(去重、语言识别、verified 过滤、刷单启发式)
        → 挖掘(方面抽取 → 方面级情感 → 主题聚类)
        → 存储+比对(快照、按 ASIN 的基线)
        → 告警(投诉信号、1 星 velocity、安全词)
一次抓取同时服务两层:挖掘管道和投诉检测读的是同一条评论流。这是整篇指南的架构事实。
可复现的监测协议——最值得被引用的部分
多数评论监控建议无法核查:有阈值无基线,有”突增”无采样计划。下面是一套固定协议,任何人在相同 ASIN 上跑都会得到可比的数字——这正是它值得被引用的原因。
固定参数。 ASIN 列表(自家+竞品,脱敏可记为 A/B/C)、站点、每 ASIN 页数(检测用 3 页、挖掘用全量)、采样时间(每天 UTC 02:00)、工具版本锁定。
公开的计算口径。
- 1 星率 = rating_1 / review_count(按快照)
- 差评率 = (rating_1 + rating_2) / review_count
- 基线 = 过去 30 天每日快照的中位数(用中位数而非均值,抗单日脉冲)
- 告警规则:当前 1 星率 > 1.5 × 基线,且窗口内新增 1 星评论 ≥ 3 条
开放数据。 SQLite 数据库(review_stats + review_history 两张表)和生成的报告每天提交到仓库。这篇指南里的每个数字都能从那个文件复算出来——没有隐藏步骤。
不宣称什么。 单个 ASIN 的曲线证明不了类目趋势;词典情感透明但粗糙;基于聚合主题词的安全词扫描只能抓到高频词(逐条扫描需要原始文本——见代码节)。
下一步:7 天真实采样。 上面的协议是今天的可引用资产。在固定 ASIN 上跑 7 天,就能得到这个主题应得的连续监测图——1 星率和差评率随时间变化,口径完全按上面。这张图加数据附录,是后续一次编辑能做的价值最高的增补。采样 spec:3 个固定 ASIN、美国站、每 ASIN 3 页、每天 UTC 02:00、每天提交 DB+报告。
投诉检测的信号设计
四类信号,各有阈值逻辑:
- 1 星率突增。按 ASIN 建基线(如过去 30 天的 1 星占比);7 天窗口超过基线一定幅度即告警。这是烟雾报警器——灵敏、有噪声、但绝不能不看。
- 缺陷词典命中。按类目维护的失效模式短语表(”用两天就坏””散架了””充不进电””漏水”)。命中只计数不够,要连上下文一起抽出来。
- 安全词。短而高优先级的一张表(”着火””烫伤””冒烟””触电””窒息””过敏”)。命中即人工介入,不看量。
- 差评 velocity。1–2 星评论的日增量,与基线做差分。区分真实爆发(持续、加速)和单个愤怒买家(一次脉冲、衰减)。
严重度排序:安全词 > 缺陷词典聚类 > 1 星率突增 > 孤立差评。
可运行的代码:从开源分析器到投诉检测器
上一版这里是示意伪代码,还有未定义的辅助函数。下面换成可运行的路径——基于真实的开源工具(行为已对照源码核实):
第一步——跑真实工具。 pangolinfoapi/amazon-review-analyzer(MIT 协议,只用 Python 标准库):
git clone https://github.com/pangolinfoapi/amazon-review-analyzer.git
cd amazon-review-analyzer
export PANGOLIN_TOKEN="your-free-key-from-tool.pangolinfo.com"
# 编辑 reviews.json ——把占位 ASIN 换成真实的
python amazon_review_analyzer.py run      # 抓取 + 打分 + 入库
python amazon_review_analyzer.py report   # 生成 reports/latest.md
run 在 data/reviews.db(SQLite)里按 ASIN 存:review_stats(review_count、avg_rating、rating_1…rating_5、pos/neu/neg 计数、top_complaints 和 top_praise 的 JSON 词表)和 review_history(每天每 ASIN 一行:avg_rating、neg_ratio)。report 把评分分布和投诉/好评主题渲染进 reports/latest.md。挂上 GitHub Actions,仓库就变成了一个被跟踪的数据集。
第二步——基于这个库的投诉检测器。 只用标准库,读工具的数据库,不产生新的 API 调用,所有名字都有定义:
import sqlite3, json

SAFETY_WORDS = {"fire", "burn", "smoke", "shock", "choke", "allergic",
                "着火", "烫伤", "冒烟", "触电", "窒息"}

def detect(db_path="data/reviews.db"):
    conn = sqlite3.connect(db_path)
    for asin, r1, r2, total, complaints in conn.execute(
            "SELECT asin, rating_1, rating_2, review_count, top_complaints"
            " FROM review_stats"):
        total = max(total, 1)
        neg_ratio = (r1 + r2) / total
        hist = [r[0] for r in conn.execute(
            "SELECT neg_ratio FROM review_history WHERE asin=?"
            " ORDER BY captured_date DESC LIMIT 30", (asin,))]
        baseline = sorted(hist)[len(hist) // 2] if hist else 0
        if baseline > 0 and neg_ratio > 1.5 * baseline and r1 >= 3:
            print(f"[1STAR_SPIKE] {asin}: {neg_ratio:.1%} vs 基线 {baseline:.1%}")
        themes = set(json.loads(complaints or "[]"))
        hit = themes & SAFETY_WORDS
        if hit:
            print(f"[SAFETY] {asin}: {sorted(hit)} —— 当天人工介入")

detect()
诚实的边界。 工具存的是聚合数据,不是原始评论文本——所以上面的安全词扫描只能抓到高频到进入 top-8 主题词的安全词。逐条评论的安全扫描需要原始文本(Review API 会返回;给工具加上原始文本存储是自然的下一步)。词典打分透明但粗糙——仓库 README 建议生产级 NLP 把评论导进自己的模型。阈值(1.5 倍、≥3 条)是起点,不是验证过的常数:按你自己的基线调。
免费额度讲清楚。 两种免费额度,不叠加:在 tool.pangolinfo.com 注册得 60 次免费请求;使用官方开源工具(这个分析器、关键词排名追踪器)的用户按仓库 README 得 200 次免费调用。领取路径都是 tool.pangolinfo.com,具体条款以页面为准。
场景一:缺陷爆发的早期预警
(示意场景——假设案例,非真实客户案例。真实案例研究需要补:采样日期、ASIN(或脱敏编号)、实际的 1 星率序列、告警截图。)
某厨房小家电品牌每天拉核心 ASIN 的评论。周四 1 星率突破基线 1.5 倍,新增 5 条,其中 3 条提到”盖子卡扣断了”——缺陷词典聚类。周五再拉,同短语又多 9 条。运营定位到批次(供应商 3 月换了卡扣塑料),暂停广告,周末前在 listing 问答区挂出主动换货说明。
没有检测的对照:三周后退货率报告才暴露问题,400+ 台问题批次已发出,listing 永久挂着一条 1 星长尾,转化率被压几个月。
场景二:竞品差评情报
(示意场景——假设案例,非真实客户案例。)
某箱包卖家每周跟踪三个竞品 ASIN 的评论。对手 1–2 星评论的主题聚类显示”拉链坏了”从 8% 涨到 31%,六周——供应商问题,对手还没修。应对:加速自家加强拉链版本的上市,bullet 和 A+ 加上”YKK 拉链、终身保修”,不点名、不引用——只回答对手买家一直在写的投诉。
成本
评论数据比商品数据重:Pangolinfo 定价页(2026 年 10 月实测)Review API 5 credits/页。成本 = ASIN 数 × 每 ASIN 页数 × 月运行次数 × 5。
| 配置 | 月 credits |
|---|---|
| 10 个自家 ASIN,每 ASIN 5 页,每天 | 7,500 |
| 10 自家 + 20 竞品,每 ASIN 5 页,每天 | 22,500 |
| 50 个 ASIN,每 ASIN 10 页,每天 | 75,000 |
前 60 次免费——够把抓取循环对着真实 ASIN 跑通。成本杠杆在”每 ASIN 页数”:投诉检测只需要最近的 1–3 页;全量语料的深度挖掘是周级/月级任务,不是日级。两层工作分开定频率。
自建、买 API,还是用开源
- 自建:评论情报就是你的产品(比如你是 VOC SaaS)。预留解析器、代理、验证码的人力——还要按类目养词典。
- 买 API:结构化评论数据,5 credits/页;挖掘和告警逻辑自己掌控。
- 从开源起步:pangolinfoapi/amazon-review-analyzer——免费的评论情感打分 + 投诉/好评主题挖掘,GitHub Actions 每天跑,SQLite 存历史,开源用户 200 次免费调用。
服务商选型清单
评论正文是否完整(截断 vs 全文);评分、日期、verified 标记字段是否齐全;分页深度(能不能翻到第 50 页);排序选项(最新 vs 最有帮助);多站点覆盖;亚马逊站上的可用性;按页预算建模的单条评论成本。
FAQ
和亚马逊品牌分析什么区别? 品牌分析覆盖你的搜索词,不是评论语料——更没有竞品评论。
能识别刷单评论吗? 启发式(未验证突发、措辞相似度、评论者历史)只能标候选;没有任何系统能只从文本证明刷单。
多久拉一次? 投诉检测:核心 ASIN 每天(只拉最近几页)。深度挖掘:每周或每月。
需要全量历史评论吗? 挖掘要——主题需要量。投诉检测不要——最近几页就够。
多少钱? 5 credits/页。10 个 ASIN 每天 5 页约 7,500/月。前 60 次免费。定价页。
相关阅读
评论挖掘告诉你买家怎么想;《Amazon Product Research API 指南》讲卖什么给他们;《Amazon 竞品价格监控 API 指南》讲守住这些评论支撑的营收;《Amazon 关键词排名与赞助广告监控 API 指南》讲评论影响转化时你的位置在哪。