
选择亚马逊评论分析工具,不是寻找“综合第一”的万能软件,而是根据具体业务在“样本口径”“证据可追溯性”与“计费模式”之间做精准匹配。截至 2027 年,没有任何商业工具在科学上完备,也无任何厂商公开披露模型准确率;工具标签仅作初筛,每轮仍须人工核验 20 至 30 条原始评论。
系列支柱篇《亚马逊评论分析完整 SOP(2027)》拆解了六步流程与 14 字段 schema,第二篇《亚马逊负面评论分析指南》聚焦了差评八大归因与 5 Whys。本篇不排“红黑榜”,只建立一套 2027 年可落地的工具选型决策框架。
为什么 2027 年不能用“排行榜”思维选亚马逊评论分析工具
不同工具在数据源权限、抽样截断与颗粒度上存在结构性差异,脱离具体工作场景的横向打分毫无决策价值。
2026 年平台机制变化放大了工具盲区
2026 年 2 月 12 日至 5 月 31 日,亚马逊按类目推进变体评论共享拆分,限制功能、容量或配置不同的子体 ASIN 共享评论池;若工具只按父体聚合或缺失子体属性,就会掩盖单品质量危机。此外,2026 年 5 月 13 日 Rufus 更名为 Alexa for Shopping,强化了前台“Customers say”与对话问答对评论的提炼,工具若只输出泛化情绪词,便无法对齐前台算法抓取的具体缺陷。
模型准确率是未公开的行业黑盒
截至 2027 年,没有任何亚马逊 SaaS 或 VOC 厂商公开披露可复现的模型准确率评估报告。电商评论存在大量反讽与语境多义(如“厚重”在羽绒服里是保暖好评,在随行杯里则是便携投诉),因此选型关键不在于 AI 宣传,而在于样本读取量与原文可追溯性。
铁律:每轮分析必须人工核验 20 至 30 条原始评论
无论使用哪款工具,提交改款或 listing 优化结论前,必须针对前三大核心主题各随机抽检 20 至 30 条原始评论全文对照,以过滤合并同类项导致的语义扭曲、识别反讽并还原 3 星评论中的使用条件。
评估亚马逊评论分析工具的三把核心标尺
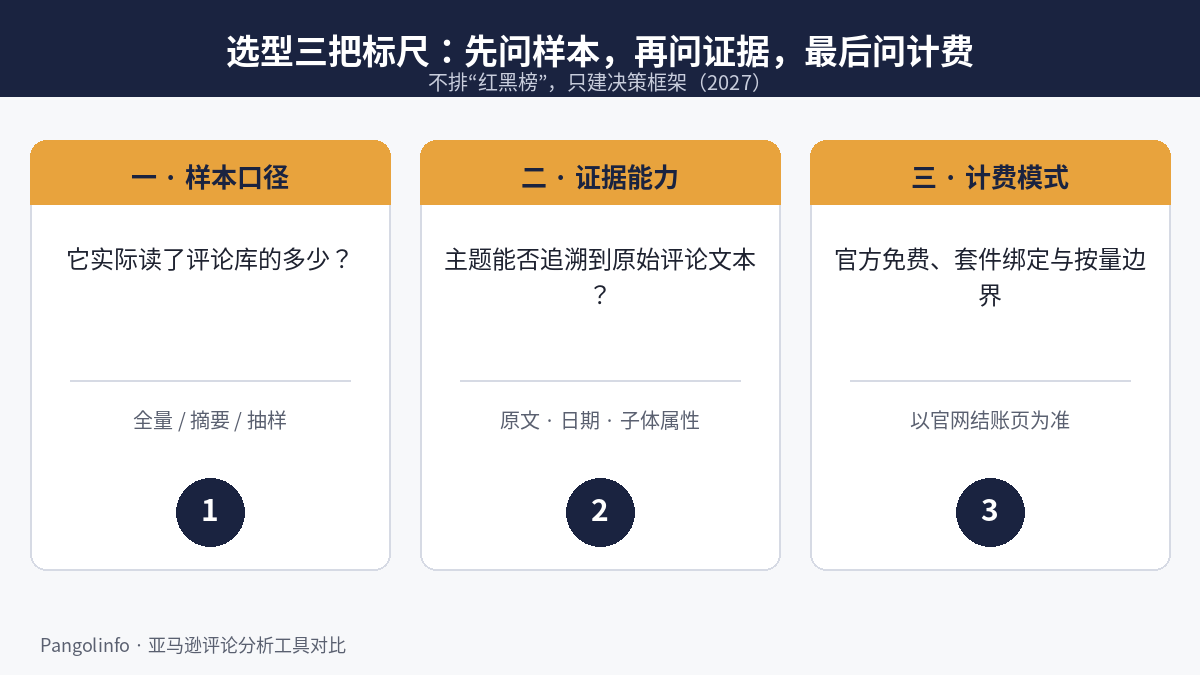
任何评论分析工具的能力边界都可用“样本口径”“证据能力”与“计费模式”拆解,且选型必须先问样本口径、再问证据可追溯性。
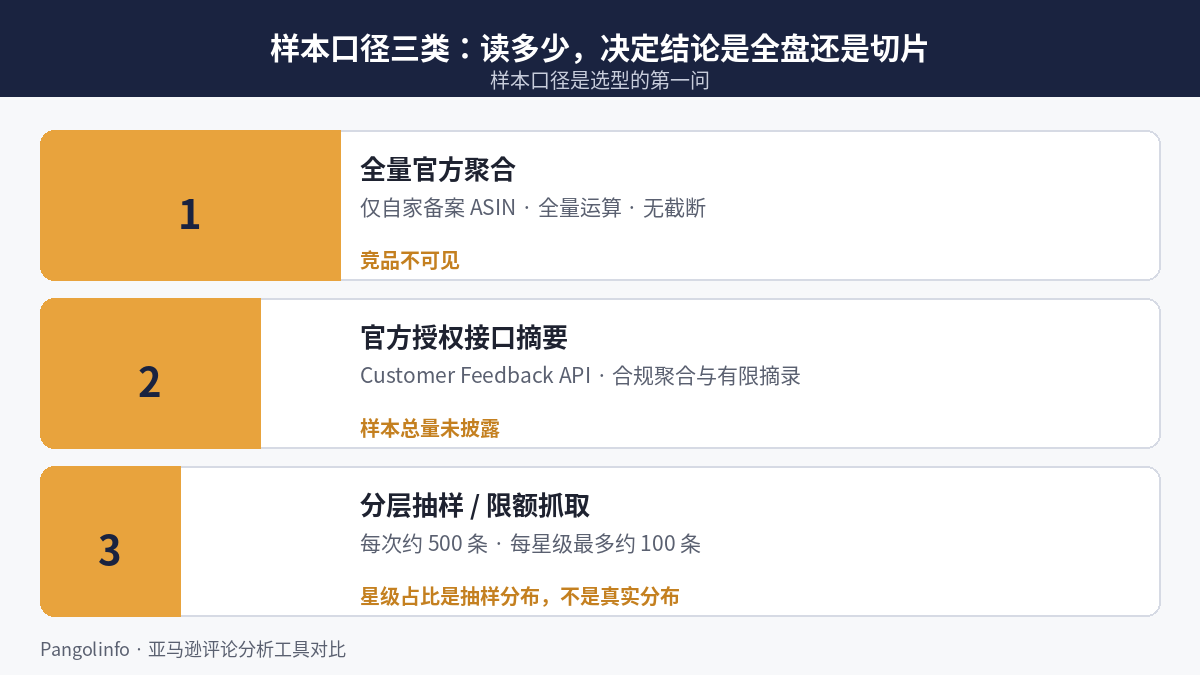
第一标尺:样本口径(它实际读了评论库的多少?)
样本口径决定结论是全盘写照还是局部切片,主要分三类:一是全量官方聚合口径(仅限卖家后台查看自家备案 ASIN,基于全量订单与评论运算,无截断但对竞品不可见);二是官方授权接口摘要口径(通过亚马逊 Customer Feedback API 获取合规聚合与有限摘录,但底层样本总量未披露);三是分层抽样或限额抓取口径(如每次运行读取约 500 条、每星级最多约 100 条,能高效挖出差评,但生成的星级占比是拉平后的抽样分布,不可当作真实差评率)。
第二标尺:证据能力(主题能否追溯到原始评论文本?)
证据能力看工具给出抽象标签后能否提供可审计的原始证据链:第一,能否一键展开对应原文摘录与上下文(分清“漏水”究竟出在螺纹盖还是硅胶圈);第二,是否保留评论日期、已验证购买、Vine 标识及子体变体属性;第三,能否导出 CSV 或通过 API 接入,以便按《亚马逊负面评论分析指南》的“频次 × 星级伤害”公式二次排序并追踪 30 天修复进展。
第三标尺:计费模式(官方免费、套件绑定与按量边界)
商业工具打包方式各异,有的随卖家账号免费提供,有的捆绑在 SaaS 套件中按席位或月度额度计费,有的按 ASIN 量或 API 额度收费。本文中所有商业工具的具体方案与价格,请查看官方结账页面;评估总成本时,应重点核对单月可分析 ASIN 上限、单次读取上限及 CSV 导出权限。
主流亚马逊评论分析工具能力边界拆解(2027 实操核验版)
市面主流方案在样本读取深度、原文可追溯性与跨竞品能力上各有取舍,没有任何一款工具能同时满足所有维度的最高要求。
下表汇总了六类核心工具与方案在三大标尺上的已核实表现(市场情报类辅助工具 DataDive 与 SmartScout 侧重类目格局与关键词选品,可在前期锁定对标竞品时辅助使用,不承担评论逐条取证职责):
| 工具 / 方案名称 | 核心数据源与样本口径 | 证据可追溯性与导出能力 | 计费模式与适用边界 |
|---|---|---|---|
| 亚马逊原生免费基线(Customer Review Insights / VOC / AI Review Highlights) | 亚马逊官方全量第一方数据;最可信的基线;仅限自有品牌备案 ASIN(前台摘要公开可见) | 展示核心正负向属性词与买家之声健康度;无法跨 ASIN 分析,无法导出原始评论明细 | 卖家后台原生免费;适合作为自家单品基线校准,不适合竞品调研 |
| Helium 10 Review Insights | 由亚马逊官方 Customer Feedback API 驱动;覆盖 7 个市场;支持 6 个月趋势;样本量未披露 | 每个提炼主题最多配 3 条原始评论摘录;支持导出 CSV | 随 Helium 10 套件订阅提供,具体套餐与价格请查看官方结账页面 |
| Jungle Scout Review Sentiment(Ask Cobalt + MCP) | 支持大规模读取评论(官方不给出具体读取条数上限);支持多 ASIN 竞品横向对比 | 自动归类为投诉、好评与功能需求三大维度;支持通过 Ask Cobalt 与 MCP 进行对话式追问 | 面向品牌与企业级分析场景,具体计费方案请查看官方结账页面 |
| SellerSprite(卖家精灵)AI 评论分析 2.0 | 每次运行读取约 500 条评论,且每个星级最多读取约 100 条;其星级分布不是完整分布 | 提供 7 层深度分析维度(人群、场景、痛点、买点等),支持查看对应样本原文 | 随卖家精灵套餐提供,具体版本与价格请查看官方结账页面 |
| ZonGuru Love-Hate | 抓取目标 ASIN 评论提炼高频正负面词组;具体样本截断上限未公开披露 | 直观拆分 “Love(正面喜爱点)”与“Hate(负面痛点)” 主题,附关联评论片段 | 随 ZonGuru 套件订阅提供,具体计费与价格请查看官方结账页面 |
| VOC.AI(Shulex) | 支持跨 ASIN 聚合;厂商自称评论量 20 亿条以上(厂商自称,未经独立核实,不可当作客观事实) | 主打痛点聚类与优先级矩阵,支持追溯原始评论,提供 API 与 MCP 接入 | 提供 SaaS 与企业定制方案,具体价格与额度请查看官方结账页面 |
1. 亚马逊原生免费基线(Customer Review Insights / VOC / AI Review Highlights)
该体系直接调用亚马逊内部全量订单、退货原因与全量评论运算,是整个行业中最可信的基线,在 2026 年 5 月 13 日 Rufus 更名为 Alexa for Shopping 后,观察前台“Customers say”标签还能直接验证平台算法对自家商品的认知。但其局限同样明确:除了前台公开可见的摘要外,后台洞察无法跨 ASIN 分析竞品,也无法导出原始评论明细。
2. Helium 10 Review Insights
由亚马逊官方 Customer Feedback API 驱动,覆盖 7 个市场,提供过去 6 个月的趋势对比并支持 CSV 导出,合规性与稳定性极高。受限于官方接口返回规则,每个主题最多仅配 3 条原始评论摘录,且底层参与计算的样本量未披露,遇到复杂故障时难以仅靠 3 条摘录完成深度拆解;具体套餐与价格请查看官方结账页面。
3. Jungle Scout Review Sentiment(Ask Cobalt + MCP)
整合于企业分析体系(Cobalt)并支持 Ask Cobalt 与 MCP 自然语言交互,具备大规模读取评论的能力(官方不给出具体数字上限),能自动将反馈归类为投诉、好评与功能需求三大维度并支持多 ASIN 竞品对比。其底层样本截断边界与模型准确率未公开,跨竞品提炼功能需求后仍需抽检原文校准;具体方案与价格请查看官方结账页面。
4. SellerSprite(卖家精灵)AI 评论分析 2.0
提供 7 层分析维度(人群、场景、痛点、买点等),每次运行读取约 500 条评论,且每个星级最多读取约 100 条,能让 1 至 3 星差评在海量好评面前获得同等分析权重。但运营必须警惕口径陷阱:由于每星级均设约 100 条上限,其展示的星级分布不是完整分布,绝不能直接拿报告里的星级占比当作真实差评率;具体套餐与价格请查看官方结账页面。
5. ZonGuru Love-Hate 与 VOC.AI(Shulex)
ZonGuru Love-Hate 专注将评论快速提炼为正负向主题(Love 与 Hate),适合选品初筛或撰写五点描述前速览受众爽点与雷区,具体方案与价格请查看官方结账页面。VOC.AI(Shulex) 主打自动化痛点聚类与优先级矩阵,支持跨 ASIN 分析并开放 API 与 MCP 接口,但关于其底层数据库规模,厂商自称评论量在 20 亿条以上(此为未经独立核实的厂商自称,不可当作客观事实依据),具体方案与价格请查看官方结账页面。
场景化决策框架:按具体业务工作匹配工具组合
“最好”的工具完全取决于手头的具体工作,高效团队会根据“快速检查 listing”“深度改款”“竞品跟踪”或“矩阵监控”动态组合工具。
场景一:自有 Listing 快速健康检查与异动预警
日常确认退货率或星级异动时,以亚马逊原生免费基线(卖家后台 VOC + Customer Review Insights + 前台“Customers say”)为核心看板,配合 Helium 10 Review Insights 观察 6 个月趋势并导出 CSV 留档。发现指标下滑时,务必到前台按“最新评论”人工通读最近 20 至 30 条 1 至 3 星评论,核查是否出现特定批次集中故障。
场景二:单品深度产品改款与负面评论根因排查
针对高差评 SKU 做改款拆解时,用 SellerSprite AI 评论分析 2.0 借助“每星级最多约 100 条”的均衡抽样完成 7 层定性初筛,导出后对照《亚马逊负面评论分析指南》的八大类别重新归类、按“频次 × 星级伤害”排序(安全与健康类问题无条件列为 P0)并执行 5 Whys 排查。同时必须人工抽检核心痛点 20 至 30 条原文,且严禁引用抽样工具的星级百分比作为整体差评率,报告中须单独注明样本量 n 与该子体 ASIN 的真实总评分分母。
场景三:多竞品跟踪与新品差异化定义
新品立项前扫描 3 至 5 个头部竞品时,先用 DataDive 或 SmartScout 锁定同配置竞品 ASIN,再用 Jungle Scout Review Sentiment(提炼投诉、好评与功能需求三大桶)或 VOC.AI(Shulex)(跨 ASIN 痛点聚类与优先级矩阵)完成横向扫描,快速验证文案卖点则可辅以 ZonGuru Love-Hate。受 2026 年变体评论拆分机制影响,务必核对所对比的竞品评论对应同一功能规格的子体 ASIN,避免跨规格误判。
场景四:多变体矩阵监控与企业级自定义分析管线
当品牌拥有数十个父体、上百个独立子体 ASIN,需要按月自动化追踪改款前后 30 天新增评论的缺陷占比变化且不受限于 500 条抽样截断或 3 条摘录上限时,应绕过封闭式 SaaS 的样本黑盒。此时直接搭建“原始评论数据接口 + 自有标准化清洗表 + 人工抽检”的轻量级工程管线,按月刷新基准占比与 30 天复核占比即可。
从“工具图表”到“可审计分析闭环”的落地规范
任何工具报表只有在附带透明口径、严守评论合规红线并解决底层数据获取的前提下,才能转化为可持续的业务增长。
在将分析结果推向跨部门执行时,团队必须守住三条操作底线:
-
所有结论必须附带样本口径与分母: 杜绝“28% 的买家抱怨漏水”这类模糊表述,统一写明样本量 n 与真实分母(例如“某子体 ASIN 的 65 条 1 至 3 星样本中,18 条即 27.7% 提及单向阀堵塞,该子体累计总评分为 412 条”),且不得将 50 至 75 条样本包装成“具有统计显著性”。
严守 FTC 与亚马逊评论合规红线: 无论分析定位出多少差评,所有客服跟进与产品插页都必须遵守 FTC 消费者评论规则(16 CFR Part 465,单次违规民事罚款最高可达 53,088 美元) 及亚马逊平台政策——绝不以退款、礼品卡或补发为条件诱导买家修改或删除差评,绝不私下联系评论者要求改评,绝不通过筛选机制压制负面评论。
先解决评论获取,再谈上层洞察: 许多团队在工具间反复切换却依然受阻,根本原因在于上层工具受限于固定抽样上限、无法按日期窗口增量提取或缺失变体属性字段。
任何严谨的评论分析,前提都是先稳定、干净地解决评论获取问题。如果成品分析工具在样本截断深度、多变体拆分或原始文本导出上无法满足需求,可以通过 Pangolinfo Amazon Review API 获取完整结构化的评论原始数据;完整的六步分析方法论与 14 字段数据结构请回顾支柱篇《亚马逊评论分析完整 SOP(2027)》,1 至 3 星差评的八大归因分类与 5 Whys 模板请见《亚马逊负面评论分析指南》,评论抓取字段设计与采集规范请参阅《亚马逊评论抓取与投诉分析指南》。(接口参考见 Review API 中文文档。)
亚马逊评论分析工具选型常见问题(FAQ)
以下五个高频问题浓缩了团队在采购与使用评论分析工具时最容易混淆的口径细节。
1. 哪款亚马逊评论分析工具的准确率最高?
截至 2027 年,没有任何厂商公开披露过可核验的模型准确率,因此不存在“准确率最高”的排名。电商评论存在大量反讽与一词多义,任何工具聚类都只能作为初筛线索,每轮分析都必须人工抽检 20 至 30 条原始评论全文进行核验校准。
2. 为什么卖家精灵 AI 评论分析 2.0 里的星级占比和前台不一样?
卖家精灵 AI 评论分析 2.0 每次运行读取约 500 条评论,且每个星级最多读取约 100 条。这种分层抽样能防止好评淹没差评,但其呈现的星级占比是截断后的抽样分布,并非该 ASIN 的真实全量分布,不能直接用来计算整体差评率。
3. 已经有亚马逊后台免费工具了,为什么还要用第三方分析工具?
亚马逊后台的 Customer Review Insights 与 VOC 是最可信的第一方基线,但仅限自有品牌备案 ASIN,既无法跨 ASIN 分析竞品痛点,也无法导出原始评论明细。做竞品对比或导出数据做二次归因排序时,仍需配合第三方工具或数据接口。
4. 评估一款评论分析工具时,最应该先问哪两个问题?
第一问“样本口径”,确认它读取了全量评论、官方接口摘要,还是按星级限额截断的局部样本;第二问“证据能力”,确认每个主题能否回溯到原始评论全文、评论日期与具体子体变体属性,并支持导出 CSV 或通过 API 获取。
5. 这些亚马逊评论分析工具的具体价格是多少?
各款商业分析工具的套餐档位、调用额度与多账号权限设计不同,且随版本更新动态调整,本文不列举具体数字,所有付费工具的最新方案与具体价格请查看官方结账页面。