
任何严谨的评论分析都以数据采集为前提:拿不到的评论无法分析。在落地 6 步 SOP 之前,必须先用 Amazon Reviews Scraper API 解决评论采集问题,获取包含完整元数据的评论语料。
如何分析亚马逊评论,核心不在于寻找一款“一键生成报告”的软件,而在于执行一套可复现的 6 步标准作业程序(SOP)。 截至 2027 年,市面上没有任何一款评论分析工具在科学上是完备的:它们或受限于采样上限,或完全忽略图片与视频评论,且没有任何厂商公开披露其情感与主题模型的准确率。真正能指导产品迭代、品控改进与 Listing 优化的分析,必须将 SOP 本身作为方法——通过 14 个必选行级字段、无偏语料构建、10–15 个主题编码、5 Whys 根因分析及人工抽样核查,把买家反馈转化为可审计的商业决策。
许多团队常走入两个极端:要么只翻前两页差评,把个别情绪当普遍缺陷;要么盲目依赖插件生成的 AI 摘要,却忽略 AI 二层压缩会抹杀低频高危风险。本文将拆解从“第 0 步:界定决策”到“第 6 步:每月复盘”的完整 SOP,对比工具能力边界,梳理 13 个需人工判断的盲点,并结合 2026 年变体评论拆分与 Alexa for Shopping 等最新变化,助您建立严谨的分析体系。
视频版:本文的视频讲解。
亚马逊评论分析完整 6 步 SOP:从界定问题到月度复盘
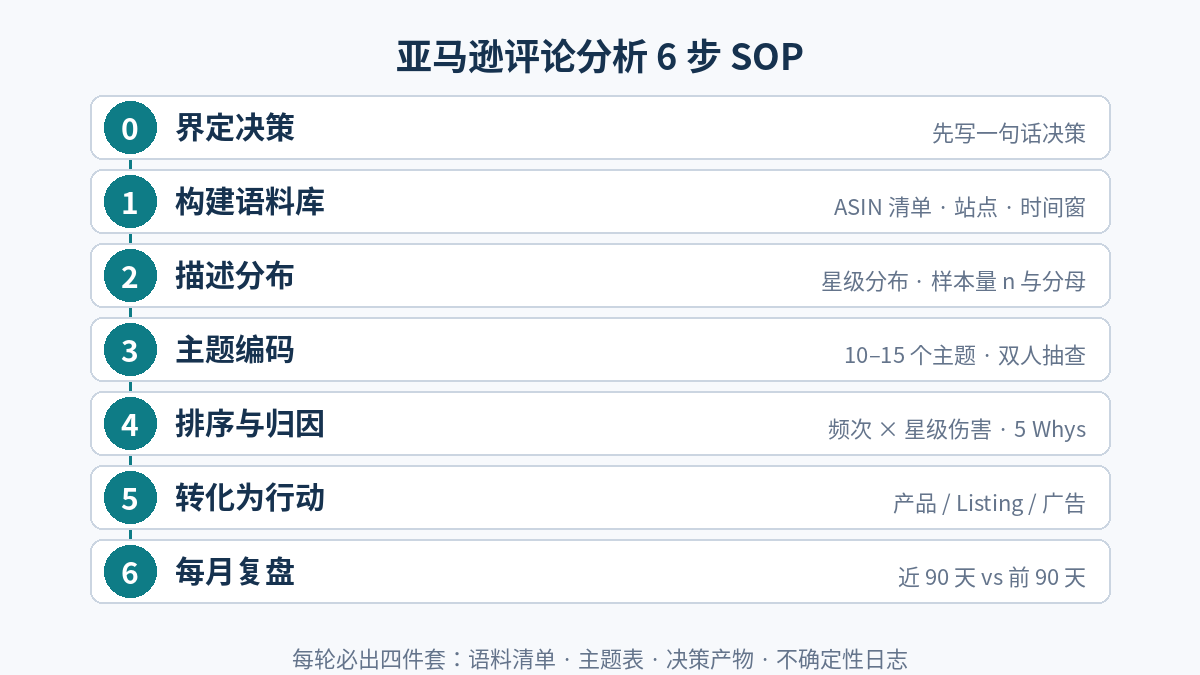
一套严谨的亚马逊评论分析流程包含从“第 0 步:界定决策”到“第 6 步:每月复盘”的完整闭环,且每轮分析必须交付四份标准化产物。 事先锁定业务问题、语料范围与字段标准,跨月结论才具备可比性。
第 0 步:界定决策(Frame the Decision)
拉取数据前,先用一句话写明本次分析服务的具体决策,并确定目标 ASIN、竞品、站点与时间窗:
-
供应链与品控改进:聚焦结构损坏、批次不良与包装破损,需精确归因到子变体与出货时间。
Listing 与视觉优化:聚焦“期望落差”与买家高频场景词,用于修正主图、五点与 A+ 页面。
新品立项与竞品切入:对比头部与新兴 ASIN 痛点分布,寻找未被满足的结构性需求。
第 1 步:构建语料库(Build the Corpus)
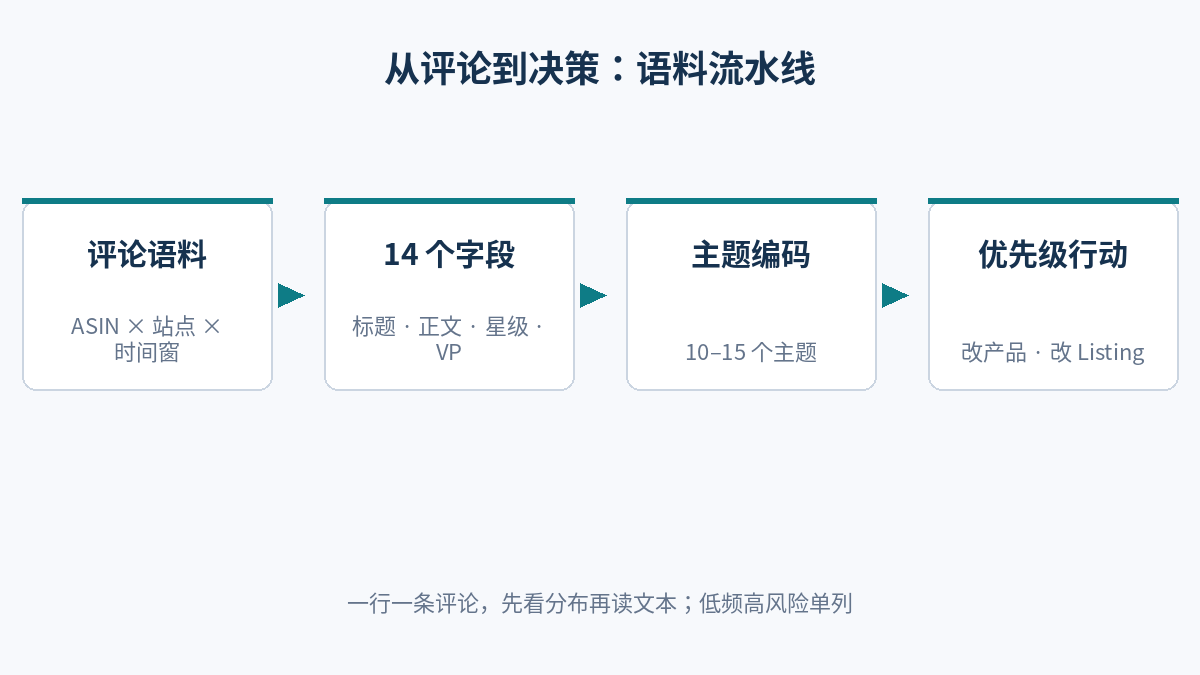
语料库质量决定了结论上限,每条评论行必须包含 14 个最低标准字段。 仅抓取“星级+正文”会导致无法做变体归因、时间趋势或真实性过滤。
| 字段名称 | 取值规范 | 分析用途 |
|---|---|---|
| ASIN | 10 位编码 | 标识父体或独立产品页 |
| 变体(Variant) | 尺码/颜色/款式 | 隔离特定 SKU 的模具、色差或尺码问题 |
| 站点(Marketplace) | US/UK/DE/JP 等 | 区分法规、电压、物流与文化差异 |
| 语言(Language) | en/de/es/ja 等 | 确保多语言文本按统一标准编码 |
| 日期(Date) | YYYY-MM-DD | 追踪质量波动、退货潮或改版前后趋势 |
| 星级(Star Rating) | 1–5 整数 | 计算星级分布与负向严重程度 |
| 评论原文(标题 + 正文) | 标题 + 正文全文 | 主题编码与方面情感的分析对象 |
| 评论链接 / ID | 评论 URL 与唯一 ID | 溯源到原文、去重与复查 |
| Verified Purchase | 是 / 否 | 区分验证购买与非验证评论 |
| Vine | 是 / 否 | 识别早期 Vine 测评,防长文主导早期词频 |
| 主题(Theme) | 10–15 个标准标签 | 归类核心讨论维度(支持一对多映射) |
| 方面情感(Aspect Sentiment) | 正/负/中/混合 | 判定针对具体主题而非整条评论的情感 |
| 使用阶段(Usage Stage) | 开箱/初次/长期/售后 | 定位问题发生在物流、安装还是耐用期 |
| 可疑标记(Suspicion Flag) | 正常 / 待核查 | 标记疑似刷单、合并遗留或无关噪音 |
第 2 步:描述分布(Describe Distributions)
细读文本前必须先统计宏观分布,并始终同时报告样本量 n 与分母。 绝不能仅写“30% 抱怨续航差”,而应写明,例如在 400 条评论中,60 条提及续航(占总样本 15.0%),其中 42 条为负向(占续航样本 70.0%,占总样本 10.5%)”。需完成四项统计:1–5 星占比、按月增量趋势、变体与站点集中度,以及 Verified Purchase 与 Vine 占比。
第 3 步:主题编码(Theme Coding,控制在 10–15 个主题)
将文本量化的核心是主题编码,最科学的分类体系应控制在 10 到 15 个互斥且穷尽的主题以内。 少于 8 个颗粒度太粗,无法指导工程改版;多于 20 个则语义重叠,导致跨月打标口径漂移。
编码需遵守三条准则:
-
标注“方面级情感”:一条 4 星评论可同时含“音质惊艳(正向)”与“耳罩夹头(负向)”,需按主题拆分。
建立编码字典(Codebook):明确定义各主题的包含/排除边界与典型例句。
强制人工抽样复核:情感模型在讽刺、混合情感和短评论上会失效,每轮自动打标后必须随机抽 20–30 条人工核查并修正规则。
第 4 步:优先级排序与 5 Whys 根因分析(Prioritize + 5 Whys Root-Cause)
完成编码后,需结合“频率 × 严重度 × 趋势”对负向主题排序,并对首要问题执行 5 Whys 根因追溯。
-
排序公式三维度:综合计算频率(负向主题占总样本 或变体样本比例)、严重度(该主题平均星级对整体均值的拉低幅度,及是否触及安全/报废红线)、趋势(近 30 天提及率较前 90 天基线是否上升)。
5 Whys 简例:以“搅拌机用两次就漏水”为例:Why 1 为何漏水?底部胶圈脱落;Why 2 为何脱落?买家拆洗后装反;Why 3 为何装反?胶圈正反相似且无防呆卡槽;Why 4 为何没提示?指南未标安装朝向;Why 5 为何近期激增?新换供应商胶圈公差偏松易滑落。据此可导出短期补指南与长期改模具公差的对策。
第 5 步:转化为行动(Translate to Action)
所有根因结论必须按投诉机制分派负责人并设定验证指标:
-
设计缺陷(Design Flaw) 交研发团队修改模具、结构或固件。
批次缺陷(Batch Defect) 交供应链与 QC 排查生产批次并核查 FBA 库存。
买家误用(Misuse) 交包装与客服增补防呆标识、说明书图示与引导视频。
期望落差(Expectation Gap) 交运营修改主图尺寸标注与五点适用范围声明。
第 6 步:每月复盘(Monthly Review)
评论分析是按月运转的验证闭环。 每月固定节点按相同字段与 10–15 个主题表拉取增量评论,既验证上月改版或文案调整是否让对应差评率下降,也监控新冒头的异常风险。
每轮必须输出的四份标准产物
-
语料库清单(Corpus Manifest):记录 ASIN、站点、日期范围、样本量 、星级与 VP/Vine 占比及过滤规则。
主题表(Theme Table):汇总 10–15 个主题的正负向频次、占 百分比、变体分布及典型摘录。
决策产物(Decision Artifact):含排序得分、5 Whys 推演、改进动作、责任人及验收指标。
不确定性日志 + 可复现性说明(Uncertainty Log + Reproducibility Note):记录样本局限(如子变体 、未含音视频、抽查 20–30 条的边界案例),并附脚本参数或提示词以确保可复现。
工具能做什么、不能做什么:从原生基线到第三方软件的分层对比
商业工具擅长“快速聚合与初步摘要”,但无法替代完整 SOP 中的样本完整性核查、变体归因与人工可信度审计。 采购软件前应先对比免费原生基线与各工具边界:
| 工具层级与代表产品 | 核心功能与已核实参数 | 主要局限与分析盲区 | 价格说明 |
|---|---|---|---|
| 亚马逊原生免费基线 (AI Highlights / VOC) | 前台 2023-08-14 上线 “Customers say”(仅限 Verified Purchase,据 About Amazon);后台供 NCX 与退货原因。 | 前台摘要压缩低频高危风险;无法导出完整底表;无法看竞品后台 VOC。 | 免费(内置于前台与后台) |
| Helium 10 Review Insights | 亚马逊官方反馈 API 驱动;7 站点;每主题最多 3 条摘录;6 个月趋势;可导 CSV。 | 样本量未披露;每主题最多 3 条摘录不足以做 5 Whys;未披露模型准确率。 | 付费,请查看官方结账页面 |
| Jungle Scout Review Sentiment | 集成 Ask Cobalt + MCP,提供问答式情感与痛点总结。 | 侧重定性摘要,缺 14 字段透明编码表与不确定性日志;未披露准确率。 | 付费,请查看官方结账页面 |
| SellerSprite(卖家精灵) AI 评论分析 2.0 | 提供 7 层结构化分析(人群、场景、优缺点等)。 | 单次约 500 条评论,每星级上限约 100 条;多评论链接会产生配额抽样偏差。 | 付费,请查看官方结账页面 |
| ZonGuru Love-Hate / VOC.AI (Shulex) | ZonGuru 侧重好差评词云;VOC.AI 侧重多维消费者标签与图表。 | 预设标签未必契合工程术语;均未披露模型准确率,且不分析图片视频。 | 付费,请查看官方结账页面 |
记住:没有任何厂商披露情感/主题模型的准确率,切勿轻信未抽检的百分比;同时警惕按星级截断(如每星级上限约 100 条)对真实分母的扭曲。
仍需人工判断的 13 个评论分析盲点
即便使用 AI 与商业软件,以下 13 个盲点仍需人工判断补全:
-
时间趋势:混同数年评论会让已修复的历史缺陷干扰当前决策,必须按月或版本切分。
跨 ASIN/品类基线:单一 ASIN 差评率无意义,需对标同品类竞品基线。
图片/视频评论:没有任何工具披露会分析它们,但结构开裂、色差与异响常仅存于视觉附件中。
买家问答(Q&A):评论是购后反馈,Q&A 则揭示购前转化阻力与型号混淆。
3 星评论(信息密度最高):1 星多宣泄、5 星多笼统,唯 3 星评论最常客观详述优缺点权衡。
投诉粒度:唯有人工能结合语境将“坏了”拆分为批次缺陷 vs 设计缺陷 vs 误用 vs 期望落差。
评论者画像:专业玩家与普通新手对性能标准不同,需结合评论者背景解读。
季节性:盛夏高温融化或续航衰减、旺季物流延误,不能外推为全年常态。
多站点/多语言:德日美等站点合规与容忍度不同,直接机翻合并会抹平本土洞察。
变体级归因:不按变体字段透视会导致为单一尺码颜色的瑕疵而盲目改动全系产品。
评论与退货/NCX 关联:许多不满买家直接退货不留评,必须与后台退货及 NCX 交叉比对。
沉默的大多数:评论是 J 形自选择样本(Hu, Pavlou & Zhang),极端情绪更爱留评,绝非全体买家的随机抽样。
AI 摘要的二层失真:AI 摘要提炼高频词,会将低频严重风险(如起火、误吞隐患)压缩抹杀。
改变分析的 2027 年 5 项最新变化
2024–2027 年平台与监管调整已直接改变评论语料结构:
-
变体评论共享拆分:据 Seller Central 论坛,2026-02-12 至 2026-05-31 按品类拆分变体评论,仅极小差异仍共享评论;分析时需按变体独立建档。
AI 摘要与 Rufus 更名:据 About Amazon,AI Review Highlights(”Customers say”,2023-08-14 上线,仅限 Verified Purchase)每周展示数亿次、互动同比增长 +100%;Rufus 在 2025 年用户超 2.5 亿,并于 2026-05-13 更名为 Alexa for Shopping,需重点监控 VP 子集以预判前台 AI 标签。
Vine 预发布机制:据 Seller Central,2025-06 起可预发布入驻,评论最快 Day 1 出现,档位 $0/$75/$200,每 ASIN 上限 30 条;分析新品需切分 Vine = 是 以防掩盖真实价格敏感度。
FTC 评论规则生效:FTC Consumer Review Rule 16 CFR Part 465 于 2024-10-21 生效,买卖假评或操纵变体单次违规最高罚款 $53,088。
英国 CMA 打假承诺:英国 CMA 于 2025-06-06 接受亚马逊关于打击虚假评论的承诺,欧美审查收紧要求分析竞品时必须剔除灰产噪音。
可信度检查:抽样核查、Verified Purchase 与虚假评论
交付报告前必须通过三项可信度检查:
-
随机抽 20–30 条人工核查:情感模型在讽刺、混合情感和短评论上会失效,每轮编码后必须随机抽 20–30 条人工盲测比对,误差记入《不确定性日志》。
Verified Purchase 的边界:Verified Purchase 只证明发生过购买,不证明真实性(返现测评同样带此标),它仅是基础过滤门槛。
虚假评论分数的定性:虚假评论检测分数只是模式线索,不是定论。 大促或合规索评也会产生时间脉冲;应在 可疑标记 记录异常集中或错位内容,并对比剔除前后的结论差异。
每月复盘节奏
按月固定节奏推进才能形成复利:
-
第 1 个工作日:拉取过去 30 天增量评论,更新《语料库清单》与样本量 。
第 3 个工作日:按 10–15 个主题编码并抽检 20–30 条,标出环比上升的负向主题与高危词。
第 5 个工作日:跨部门核验前期改进效果,对新增痛点做 5 Whys 并签署《决策产物》。
每季度末:微调编码字典并刷新跨 ASIN 品类基线。
结语:分析以采集为前提
任何严谨的评论分析都以数据采集为前提:拿不到的评论无法分析,所以在落地 6 步 SOP 之前,必须先解决评论采集问题。 若在源头受限于页面折叠或缺失变体、日期字段,后续编码与根因分析便无从谈起。
为获取包含完整元数据的评论语料,可使用 Amazon Reviews Scraper API 作为解决办法(参数详见 Amazon Review API 文档),并结合《如何抓取亚马逊评论并进行差评分析》了解具体的采集与差评分析方法。
基础采集流程非常简明:先从 Pangolinfo 获取 API 密钥。随后用目标 ASIN 与站点参数调用 reviews 接口。收到响应后,通过翻页参数循环拉取各页评论,即可将星级、日期、变体与 Verified Purchase 等字段存入分析表。该接口每页 5 credits,每月免费 60 credits 足够先在一个小品类上验证流程。完整的分步采集 SOP 是本系列第 7 篇文章《如何用 Pangolinfo Review API 获取评论用于分析》,另有亚马逊评论 API 数据采集新手教程可参考。
常见问题解答(FAQ)
1. 分析一个 ASIN 至少需要多少条评论样本?
无绝对门槛,核心是始终同时报告样本量 n 与分母并记入《不确定性日志》。当样本较少时,应逐条精读(尤其是 3 星与 Vine 评论)并参考竞品基线。
2. 为什么 AI 总结的痛点和后台实际退货原因对不上?
一是 AI 摘要的二层失真会压缩低频严重缺陷;二是评论呈 J 形自选择样本分布(Hu, Pavlou & Zhang),许多不满买家直接退货(计入 NCX)未留评,故需关联退货报告。
3. 2026 年变体评论拆分后,历史数据如何对比?
亚马逊于 2026-02-12 至 2026-05-31 按品类拆分变体评论(仅极小差异仍共享)。跨期对比需用 变体 字段按子 SKU 过滤,仅对比同一子变体拆分前后的表现。
4. 为什么主题编码要控制在 10 到 15 个主题?
少于 8 个颗粒度太粗,无法做 5 Whys 根因分析;多于 20 个则语义重叠,导致人工或 AI 跨月归类口径漂移。
5. 只看 Verified Purchase 能完全排除虚假评论吗?
不能。Verified Purchase 只证明发生过购买,不证明真实性;检测分数也只是模式线索而非定论,应用 可疑标记 记录异常样本并对比剔除前后的差异。