
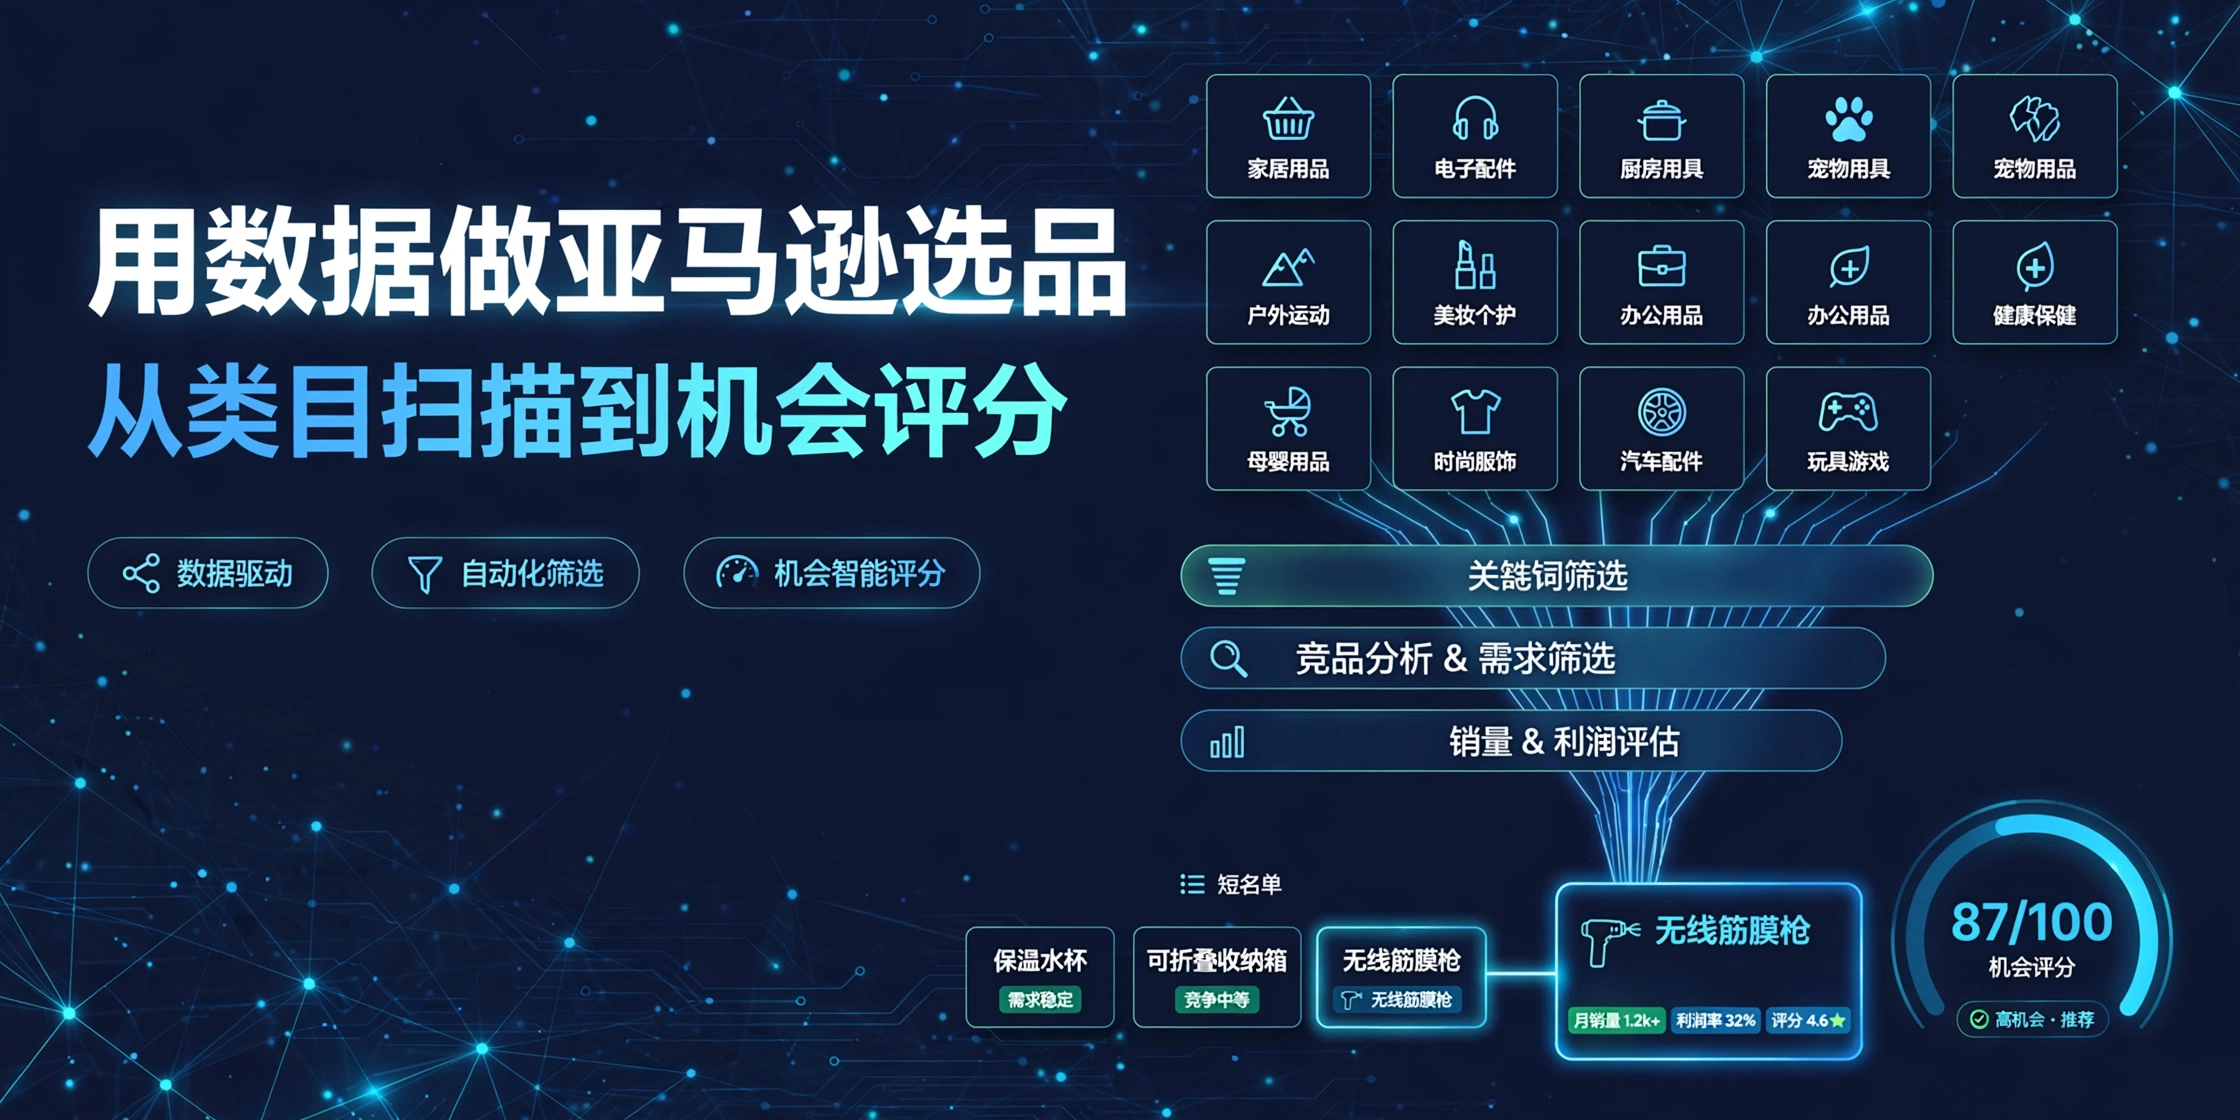
关于亚马逊选品的文章已经很多,但绝大多数在讲单点技巧:某个指标怎么看、某个类目怎么切、某个工具怎么用。单点技巧默认你已经有了一个候选产品——而难点恰恰在上游:候选从哪里来、按什么标准排序、凭什么淘汰。本文提供的是把技巧组织起来的流程框架:从类目扫描到机会评分的完整决策流水线。
先给结论。选品的产出物不应该是”一个好产品”,而应该是一条可复现的流水线:约束定义 → 类目扫描 → 候选池 → 硬过滤 → 机会评分 → 差评验证 → 移交监控。七个环节缺任何一个,选品都会退化成运气:没有约束定义,排序没有依据;没有候选池,视野被少数几个爆款锁死;没有硬过滤,时间浪费在结构性做不了的产品上;没有显式评分,决策无法复盘;没有验证,评分排出的第一名可能正是最危险的那个。
本文是本系列 E 组(场景实战)的第一篇,也是后续实战篇的方法论底座。文中涉及的采集方法只给结论与入口:批量商品数据怎么采,见系列 C1《如何批量采集亚马逊商品详情》;评论与差评怎么采、怎么分析,见系列 C4《如何采集亚马逊评论并做差评分析》——两篇与本文同批次发布。搜索结果与广告位(系列 C2)、榜单数据(系列 C3)的系统采集尚在写作中,文中只标流程位置。
一、先把选品问题写下来:约束先行
定义先行:选品是在约束集合内对候选集排序。脱离约束谈”哪个产品好”没有意义——同一个类目,对资金充裕、有改款能力的团队是机会,对测款型小团队可能是陷阱。所以流程的第一步不是看数据,而是把约束写成数字。
| 约束类别 | 要回答的问题 | 如何变成可用的数字 |
|---|---|---|
| 资金 | 首批能投入多少?一批货的周转周期多长?同时能测几个款? | 可进入的价格带下限(售价须覆盖头程、佣金、广告与退货损耗)、单款首批投入上限、可并行测款数 |
| 供应链 | 能触达哪些品类的工厂?起订量与交期如何?能不能改款? | 可进入的类目清单、最小起订量对应的资金占用、补货周期(决定断货风险敞口) |
| 团队 | 有没有产品开发与改款能力?内容与广告谁来执行?售后承接得住吗? | 可承接的品类复杂度上限、对差评敏感类目(如强尺寸/适配类)的承接能力评级 |
产出物是一页纸的约束清单,后续硬过滤的每一道都必须能回溯到这张清单上的某一条。约束不是限制想象力,而是让每一次淘汰有据可查——复盘时能分清淘汰某个产品是判断错了,还是约束变了。
二、类目扫描:先看森林,再看树木
约束明确之后,先扫描类目,再接触具体产品。这一步的数据来源是榜单:Best Sellers 的大类与小类排名、飙升榜(Movers & Shakers)、新品榜。榜单提供的是整个类目的结构截面。
扫描时看四个观察量:
- 头部集中度。榜单前列被多少个品牌占据、是否有一家独大的品牌或亚马逊自营身影。集中度决定新进入者面对的是”一群对手”还是”一堵墙”。
- 新品进入速度。新品榜与主榜的更替情况:新品能否进入主榜前列、能在榜上停留多久。更替快说明类目仍在洗牌,慢则说明格局固化。
- 价格带分布。榜单商品的价格集中在哪一段、是否存在明显的价格空档。价格空档不是机会本身,但它划定了后续候选池的价格坐标系。
- 评论量级分布。头部与腰部的评论量差距有多大。这个差距是第四步”评论墙”过滤的输入:它衡量的不是某个产品的强弱,而是后来者的冷启动成本量级。
扫描的纪律有两条。第一,榜单是时点截面,单截面只能看结构,多截面才能看趋势——同一类目间隔数周重复采集再对比,”在往哪里变”才有答案;每次采集必须记录站点与时点,否则截面不可比。第二,扫描阶段只产出候选类目清单(三到五个,每个附一句进入理由),不产出候选产品——过早盯住具体产品,是选品视野收窄的最常见原因。榜单数据的系统采集方法是系列 C3 的主题,陆续发布中。
三、建立候选池:从类目到 ASIN 清单
对候选清单上的每个类目,把视野内的商品收成一份 ASIN 清单——候选池。候选池由三个来源取并集:
- 榜单来源:该类目各级榜单上的 ASIN,代表已被市场验证的存量格局;
- 搜索来源:类目核心关键词的搜索结果 ASIN,代表消费者实际视野里的竞争集合——榜单与搜索结果并不重合,广告与自然排名使两者构成不同;
- 店铺来源:主要竞品品牌店铺的在售 ASIN,代表对手的产品矩阵,含那些不在榜单上、但靠站外流量生存的商品。
三个来源去重合并后,每个 ASIN 记录一组基础字段:标题、品牌、价格、星级、评论数、大类与小类 BSR、卖家数量、上架时长(可得时),并标注数据来源与采集时间。字段口径与批量采集的工程方法见系列 C1《如何批量采集亚马逊商品详情》(本批次同步发布)。
采集路线在这里要做一个选择。手工与浏览器插件适合验证流程,不适合建池:候选池动辄数百个 ASIN,且第二步的纪律要求它被重复采集、跨时点对比——这是 API 路线的形态。以 Pangolinfo 的 Amazon Scraper API 为例,按 ASIN 或关键词批量提交、返回结构化字段,按调用量计费;新用户每月有 60 credits 免费额度,其正确用法是先在一个小类目上把字段口径与流程验证一遍,而不是试图用免费额度完成全量建池(免费额度的定位见支柱指南 FAQ)。选哪条采集路线本身的方法论对比,见系列 A3《亚马逊数据采集的 6 种方式对比》。
建池纪律一条:候选池宁宽勿窄。淘汰是下一步的职责;在这一步因”看起来一般”漏掉的 ASIN,后续环节无法补救。宽进的前提是每条记录的来源与时点可追溯,否则池子越大,噪声越不可控。
四、硬过滤:只砍结构性不可能
硬过滤的原则一句话:只砍”在你的约束下结构性做不了”的候选,不砍”难做”的候选。前者是约束问题,后者是能力排序问题——混淆两者,要么把机会误杀在门外,要么让评分环节替硬过滤背锅。具体的四道过滤,每一道都回溯到第一步的约束清单:
- 价格带过滤。售价低于毛利模型下限的直接剔除:无法覆盖头程、平台佣金、广告与退货损耗的合理预估时,销量越大亏损越大,不进入评分。
- 评论墙过滤。类目头部的评论量级远超团队冷启动能力可承接的范围时剔除。必须强调:评论墙是资金与时间的函数,不是固定阈值——不存在一条放之四海的”评论数红线”,能翻多高的墙,取决于你能为单个 ASIN 投入多少测款预算与爬坡时间。把别人的阈值抄过来,是这一步最常见的错误。
- 品牌集中度过滤。候选池内统计品牌分布:若类目被一两个头部品牌加亚马逊自营封锁、中小卖家合计份额可以忽略,新进入者的货架空间在结构上不存在,剔除或降级为观察。
- 风险硬项过滤。明显的外观/商标侵权嫌疑、与团队资质不符的强认证类目、平台政策明确的高风险品类,直接剔除。这一道不看机会大小,只看敞口是否存在——合规边界的完整讨论见支柱指南第四节。
硬过滤后,候选池应收敛到可以逐个审视的规模。留下的每一条记录都应通过了”结构上做得了”的检验;接下来的问题是排序——先验证哪一个。
五、机会评分:四维框架
硬过滤回答”能不能做”,评分回答”先做哪个”。把判断显式化的意义不在于分数本身,而在于强迫判断留痕:三个月后你能看到当初为什么把 A 排在 B 前面,能区分是框架错了还是数据错了。四个维度均可直接从候选池字段计算,不需要外部假设。
| 维度 | 含义 | 候选池内的可算指标 | 计分方向 |
|---|---|---|---|
| 需求强度 | 类目整体的购买意愿与增长态势 | 类目核心词的搜索结果规模;头部 ASIN 评论存量与增量(需多截面采集);榜单更替速度 | 正向 |
| 竞争强度 | 新进入者要付出的代价 | 头部品牌集中度;候选池平均评论量;搜索结果页的广告位密度(需搜索结果数据,系列 C2 主题) | 反向(越弱越好) |
| 毛利空间 | 价格带与成本结构之间的缓冲 | 价格带中位数与你的采购/物流成本之间的粗算空间;注意只做量级判断——精确成本只有你自己的账本能给 | 正向 |
| 风险 | 品类层面的不确定性 | 差评率量级;尺寸/适配类等退货敏感特征;多截面 BSR 的季节性波动 | 反向(越低越好) |
每个维度按 1–5 分打分。打分的锚点没有统一标准,必须按自己的约束校准——举例来说,需求维度上”头部 ASIN 评论持续正增长且新品能进榜单前列”可以被定义为 5 分,但对测款型团队这条锚点可以下调:他们的资金允许先以小批量验证需求,锚点不必定得那么苛刻。锚点是框架的使用者自己定的,框架只规定:锚点必须写下来,且一旦确定、整轮评分内不得改动。
权重配置(示例,不是标准答案)。一个可参考的起点是:需求 30%、竞争 30%、毛利 25%、风险 15%——示例配置,不是普适权重,必须按你的约束调整:
- 资金紧、试错次数少 → 风险与毛利权重上调:活下来比增长重要;
- 供应链强、有改款能力 → 风险权重下调、需求权重上调:你能吃掉别人吃不下的机会;
- 测款型打法 → 需求权重上调、竞争权重下调:先以最小成本验证需求真伪,竞争问题留到放量阶段再解。
评分的纪律有三条:第一,保存权重版本与评分日期,每轮评分是一次实验记录;第二,总分相同者调出原始数据看——分数是压缩,原始数据才是真相;第三,评分只排出验证顺序,不直接产生采购决策:分数回答”值得先验证哪几个”,验证回答”到底能不能做”。
六、验证:用差评数据核查前排候选
评分前列的候选有三件事必须用真实数据核查过,才能进入打样环节:
- 头部竞品的差评在抱怨什么。抱怨可分为三类:缺陷型(质量、耐用性)是机会信号——现有产品没做好,你有改进空间;场景型(尺寸预期、安装说明)是 Listing 信号——产品本身可行,但页面必须正面回应;结构性(品类通病且现有技术不可解)是剔除信号。同一批差评,分类不同,结论完全不同。
- 差评占比与评分结构。差评占比的算法是差评数除以总评论数,但口径必须统一:同一品类内比较、同一采集时点、标注是否计入了 Verified Purchase 之外的内容。以本系列基准测量为例:AirPods Pro 3(B0FQFB8FMG)在 2026-10-12 经 Pangolinfo Review API 实测共 4,268 条评论,其中差评(critical)1,392 条,占比约三成。这个数字本身不构成机会判断,只说明抱怨的密度;决定结论的是抱怨内容的可解性,而不是占比本身。
- Q&A 与中评里的未满足需求。用户反复追问而卖家答不清的问题(兼容性、适用场景、长期使用表现),是产品差异化的切口;中评里”东西不错但是……”的转折句,往往藏着下一代产品应该改的地方。
评论数据的采集与差评分析的完整方法是系列 C4《如何采集亚马逊评论并做差评分析》(本批次同步发布)。成本上可控:评论接口按页计费(每页 5 点),验证阶段只对评分前列的 3–5 个候选做深核查,用量不大。一个便捷的数据入口是 Pangolinfo 的 Amazon Review API,按 ASIN 拉取结构化评论与评分分布。
验证的产出物:每个头部候选一页验证记录,结论只有三种——通过、降级为观察、剔除并写明原因。剔除的候选不要删掉:留档并记录重新评估的触发条件,成为下一轮扫描的输入。
七、决策与移交:选品不是一次性事件
决策的输出不是单个赢家,而是一份分层清单:
- 进入打样/小批量测试:验证通过的 1–3 个候选;
- 观察名单:评分高但验证未通过、或时机未到(如季节性品类淡季中)的候选;
- 归档:本轮剔除的候选及剔除原因,附”重新评估触发条件”。
然后是关键的一步:把入选与观察名单全部移交持续监控——价格、BSR、评论增速、竞品上新与价格变动。选品的结论会随时间衰减:今天评分 85 分的类目,三个月后可能因为头部降价变成 60 分;今天剔除的候选,也可能因头部品牌退市而重新可做。没有监控的选品,做完即过期。监控的搭建方法是系列 E2《竞品价格与排名监控怎么搭》、E3《新品监控:怎么第一时间发现新进入的竞品》与 D1《用定时工作流做持续监控》的主题,陆续发布中。
最后是复盘纪律:每季度回看一次评分与实际结果——进入测试的候选后续表现如何、剔除的候选后来有没有人做起来。复盘的目标是校准框架本身:哪个维度持续误判,就调整它的权重或指标定义。没有复盘的评分框架会逐年失效;有复盘的框架是团队资产,越用越准。
结语
全流程压缩成一句话:写清约束 → 扫描类目看结构 → 建池并保证可追溯 → 硬过滤只砍结构性不可能 → 四维评分排出验证顺序 → 用差评数据核查前排候选 → 分层决策并移交监控。七步之中,数据采集解决的是”输入质量”——候选池的可比性、评论口径的统一性;人的工作是”判断”——约束写进权重,权重写进记录,记录写进复盘。数据不替人决策,但让每次决策都可检验。
本文属于《亚马逊数据采集完全指南》系列,定位是 E 组(场景实战)的方法论底座:把采集来的数据,变成一次可复现的选品决策。