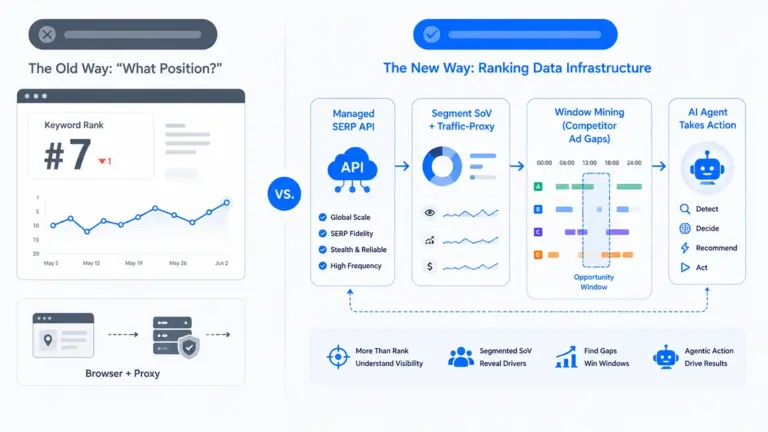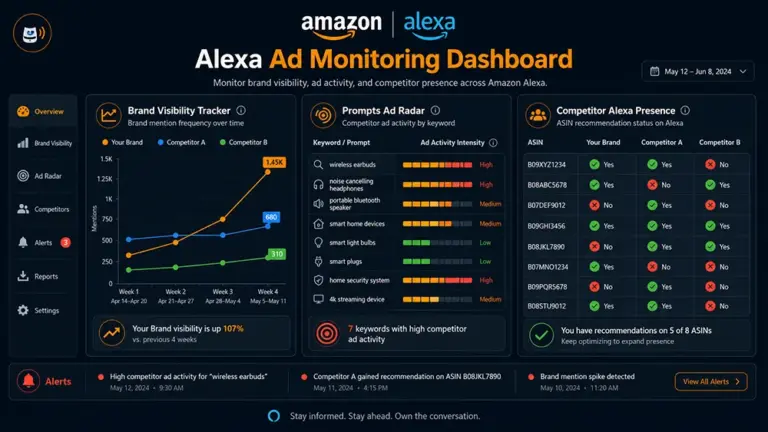

每个亚马逊搜索结果页同时回答两个问题:你的排名在哪,谁在花钱排在你前面。大多数卖家只监控第一个,对第二个靠猜。本指南把两者当作一个系统——因为技术上它们就是一个:一次 SERP 抓取同时返回自然排名和全部广告位。监控架构、成本模型、告警设计都从这个事实推导出来。本指南讲解亚马逊关键词排名监控 API 如何把一次 SERP 抓取变成完整的监控系统。
为什么要一起监控排名和广告
自然排名天生波动。亚马逊持续重排——对手动作、季节性需求、listing 改动都会让排名每天变化。上个月霸榜的关键词,可能在你看滞后几周的销售报表时悄悄 decay。
广告位是你在自己广告后台看不到的付费曝光。亚马逊 Advertising API 只报你自己的投放,不告诉你 Top of Search 上站着谁、关键词的广告密度在变厚还是变薄、新玩家什么时候开始买量。这些情报只存在于 SERP 本身。
排名下跌有两个病因,对应两种药方。自然相关性 decay(listing 问题——改文案、改图、攒评价),或对手广告把你挤下去(付费问题——调 bid、调预算,或接受并靠转化率硬吃)。没有广告数据并排对比,你分不清是哪一种——然后开错药。
跟踪什么:双指标体系
自然排名指标
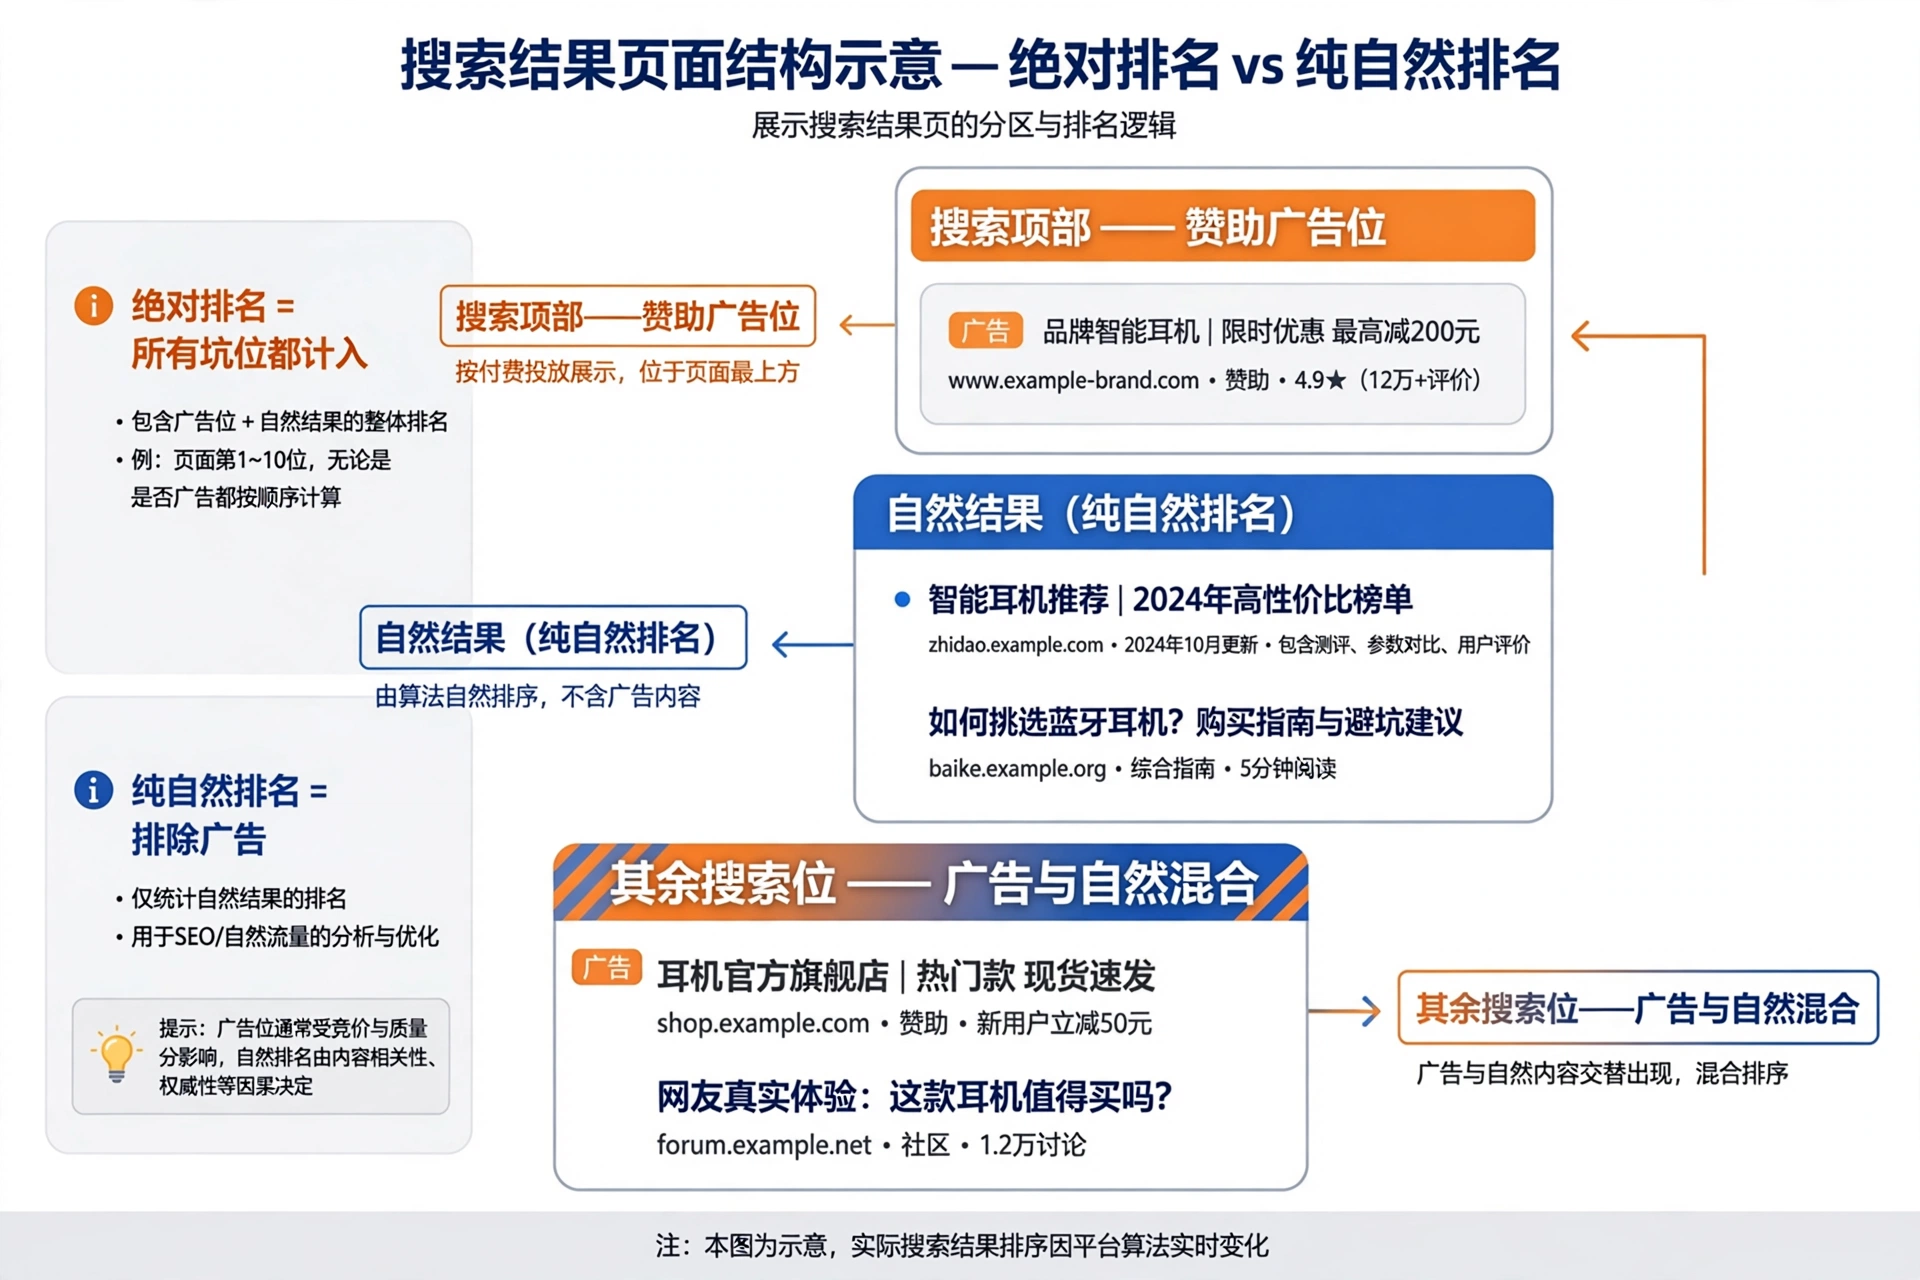
- 绝对排名——把广告位也算进去的排名。用户实际看到的样子。
- 纯自然排名——只在非广告结果里的排名。剥离广告挤压后的真实相关性信号。
- 首页占有率——跟踪关键词中有首页自然位的比例。老板真正想看的那个数字。
广告指标
- SP 广告位——每个关键词是哪些 ASIN 在投,广告排名第几。
- 展示位置类型——Top of Search、其余搜索位、商品详情页。Top of Search 是最贵、意图最强的库存。
- 广告密度——广告位占可见坑位的比例。密度上升 = 这个词的竞争变贵了。
- 新进入/退出事件——某 ASIN 第一次出现在广告位(可能是新品起量),或消失(预算烧完或战略撤退)。
上下文(缺了这些,指标就是谎言)
- 时间戳——每次抓取都要带。没有时间的排名是谣言。
- 地理位置——排名随 ZIP 变化。固定位置,只做同条件对比。
- 站点——记录你在什么条件下测的。
六个难点
1. 排名不是一个数字。地理位置、设备、浏览历史都会让两个人看到两种排序。任何不声明”位置+抓取方法”的排名数字都不可比。解法是方法论不是技术:固定位置(ZIP 级)、固定时间表,只做同条件对比。
2. 广告拍卖持续重跑。预算 pacing 和 bid 调整让广告位一天内多次变化。每天一次抓趋势,每小时一次抓战斗。频率匹配决策。
3. 广告/自然的区分是最难的解析问题。亚马逊不会把广告位做成机器一目了然的格式——徽标、布局、模板一直在变。这是服务商的分水岭:Pangolinfo 定价页宣称 90%+ 的赞助位识别率,一家关键词情报平台的 CTO 公开说 90%+ 的识别率是”关键词情报和流量归因的关键”。漏掉五分之一广告位的服务商,会在对手包周买 Top of Search 时告诉你”没有新竞争者”。
4. 频率是成本函数。每个关键词 × 站点 × 扫描页数都是一次请求。分级:赚钱词每天(或更高频),成长词起量期每天,观察词每周。
5. 归因:自然 decay 还是广告挤压。双指标体系就是为回答这个问题存在的。纯自然排名稳定 + 绝对排名下跌 = 被广告挤了;两个都跌 = listing 相关性丢了。一个指标分不清。
6. AI 购物面暂时不是排名指标。Rufus 正在并入 “Alexa for Shopping”,没有稳定的位置数字可跟踪。定性观察即可(你的 ASIN 在不在 AI 推荐里出现),绝不要让一次 noisy 的观察推翻自然排名和销售数据。
现有方案的短板
- SaaS 排名工具(Helium 10、SellerSprite、Ad Badger):为”在他们的后台看你自己的 ASIN”而生。每天更新、关键词有上限,拿不到对手广告位的程序化数据。
- 亚马逊 Advertising API:自己的投放很权威,对手的一片盲区。设计如此。
- 通用 SERP API:以 Google 为中心,亚马逊广告位解析是附带的——而这正是本场景的命脉。
- 人工查:不可规模化、无记录、还带着检查者本人的个性化。
- 排名靠前的”指南”:穿着指南外衣的 SaaS 功能页。学点按钮在哪可以,指望它搭系统不行。
关键词排名监控 API 系统如何工作
一次抓取,双路解析,然后是标准循环:
- 关键词表——赚钱词(带来 sales 的 5–15 个)、成长词(正在往首页推的)、观察词(长尾)。盯住赚钱的 10 个词,胜过盯 200 个不赚钱的。
- SERP 抓取——每个关键词每个站点一次请求,自然结果和广告位一起返回。
- 解析——拆成自然排名和广告排名,标注位置类型。
- 存储 + 比对——每次快照存档,按关键词按 ASIN 和基线比对。
- 告警 + 动作——排名下滑、新广告主、广告密度飙升、掉出首页。
排名语义:为什么需要两个位置数字
绝对排名回答”用户看到什么”,纯自然排名回答”亚马逊觉得我的 listing 有多相关”。对手在你的关键词上猛投 Sponsored Products 时,绝对排名掉、纯自然排名不动——正确的反应是广告决策,不是重写 listing。只看一个数字的团队,每周都在误诊。
赞助广告情报
广告这一半是竞争情报,不只是跟踪:
- 谁在你的词上投广告——常驻玩家 vs 打酱油的。
- 广告密度趋势——一个词从 2 个广告位涨到 6 个,就是变贵了;加预算或找更便宜的长尾。
- 新进入者检测——某 ASIN 第一次出现在 Top of Search,往往是新品起量。竞品上线第一周最脆弱,是反制的窗口。
- 广告消失——预算烧完是机会窗口,战略撤退是情报。
代码:关键词排名 + 广告位监控
每个关键词一次请求,两半数据全有。下游全是比对。(示意——精确端点见文档。)
import requests
from datetime import date

API_KEY = "pgl_xxx"  # tool.pangolinfo.com,前 60 次免费
headers = {"Authorization": f"Bearer {API_KEY}"}

def check_keyword(keyword, asin, marketplace="US", zipcode="10041"):
    d = requests.get(SERP_URL, headers=headers, params={
        "query": keyword, "marketplace": marketplace, "zipcode": zipcode,
    }).json()
    organic = [r for r in d["results"] if not r["sponsored"]]
    ads = [r for r in d["results"] if r["sponsored"]]
    abs_pos = next((i+1 for i, r in enumerate(d["results"]) if r["asin"] == asin), None)
    org_pos = next((i+1 for i, r in enumerate(organic) if r["asin"] == asin), None)
    top_ads = [a for a in ads if a["placement"] == "top_of_search"]
    snapshot = {"keyword": keyword, "asin": asin, "absolute": abs_pos,
                "organic_only": org_pos, "top_of_search_ads": top_ads,
                "ad_density": len(ads) / max(len(d["results"]), 1),
                "captured_at": date.today().isoformat()}
    baseline = load_baseline(keyword, asin)
    diff_and_alert(keyword, asin, baseline, snapshot)
    save_baseline(keyword, asin, snapshot)
场景一:守住赚钱词
某卖家的核心词 “silicone stretch lids” 贡献 30% 营收。监控每天带 ZIP 定位跑一次。周三告警:绝对排名 4 → 9,纯自然排名不动(第 3)。诊断瞬间完成——广告挤压,不是相关性 decay。广告扫描显示某新 ASIN 从周二起占了两个 Top of Search 位。反应:周末把该关键词 exact match 的 bid 拉上去,而不是去重写一个本来没病的 listing。下周一对方预算 pacing 结束,排名恢复正常。没有双指标,团队会花一周”优化”一个没病的 listing。
场景二:发现对手的新品起量
类目里一个观察词的广告密度三天内从 2 个涨到 7 个,某新 ASIN 在五个相关词上同时占据 Top of Search——这是带着真预算的起量。类目经理拉出对方 listing:评价薄、定价激进、广告凶猛——典型的抢地盘打法。选项:共享赚钱词上加防守 bid,或者让对方烧钱打一个未经验证的 listing,同时盯住它的评价增速。无论选哪个,决策发生在第一周,而不是月末复盘。
成本
每个关键词每个站点每次运行 = 一次 SERP 抓取。Pangolinfo Amazon Scraper API(2026 年 10 月实测):1 credit/页。
| 配置 | 月 credits |
|---|---|
| 20 个赚钱词,每天,1 个站点 | 600 |
| 100 个词,每天,2 个站点 | 6,000 |
| 500 个词,每天,3 个站点 | 45,000 |
前 60 次免费。最贵的错误和价格监控一样:200 个虚荣词高频跑。按营收影响分级。
自建、买 API,还是用开源跟踪器
- 自建:排名/广告情报就是你的产品,预留正经数据工程人力。
- 买 API:干净的 SERP 数据,广告位已解析好,1 credit/页;关键词表、比对、告警自己掌控。
- 从开源起步:pangolinfoapi/amazon-keyword-rank-tracker——免费,GitHub Actions 每天跑,SQLite 存历史,ZIP 级定位,广告位识别,绝对排名 + 纯自然排名双指标。开源用户送 200 次免费调用。
服务商选型清单
- 赞助位识别率,敢写出数字(Pangolinfo:90%+)
- 自然和广告一次响应全返回
- ZIP 级位置控制
- 每条记录带时间戳
- 亚马逊站上的可用性,不是泛泛的 SERP 可用性
- 按你的排期建模的单次关键词检查成本
FAQ
多久查一次?赚钱词每天,成长词起量期每天,观察词每周。只有”会盘中行动”的词才值得盘中查。
能看到对手的广告吗,不只是自己的?能——这正是基于 SERP 监控的意义。亚马逊自己的 Advertising API 只覆盖你自己的投放。
为什么需要 ZIP 级定位?排名随位置变。不固定位置,日环比就是噪音。
绝对排名和纯自然排名什么区别?绝对排名算上广告位(用户看到的),纯自然排名排除广告(listing 的相关性信号)。两个都要。
多少钱?1 credit/页。100 个词每天 2 个站点 ≈ 6,000/月。前 60 次免费。套餐见定价页。
相关阅读
排名监控告诉你你在哪,选品告诉你该去哪。还在选品阶段先看《Amazon Product Research API 指南》;要守住排名背后的营收,看《Amazon 竞品价格监控 API 指南》。